
死锁日志怎么看:还原事务交叉加锁的最短路径
来源:17golang原创
时间:2026-10-07 13:02:55 351浏览 收藏
MySQL InnoDB 的死锁日志不是一段只能“看报错”的文本,而是一张等待关系快照。最短的读法是:先找两个事务各自持有了什么锁,再找它们正在等待什么锁,最后把“事务 A 等 B、事务 B 又等 A”闭合起来。只要能还原这个环,修复点通常就是访问顺序、事务长度或索引范围。
SHOW ENGINE INNODB STATUS默认提供最近一次死锁报告。- 日志中的
HOLDS THE LOCK(S)是已持有锁,WAITING FOR THIS LOCK是卡住当前事务的请求。 - 应用必须把死锁当作整笔事务失败,回滚后有限次重试,不能只重复最后一条 SQL。
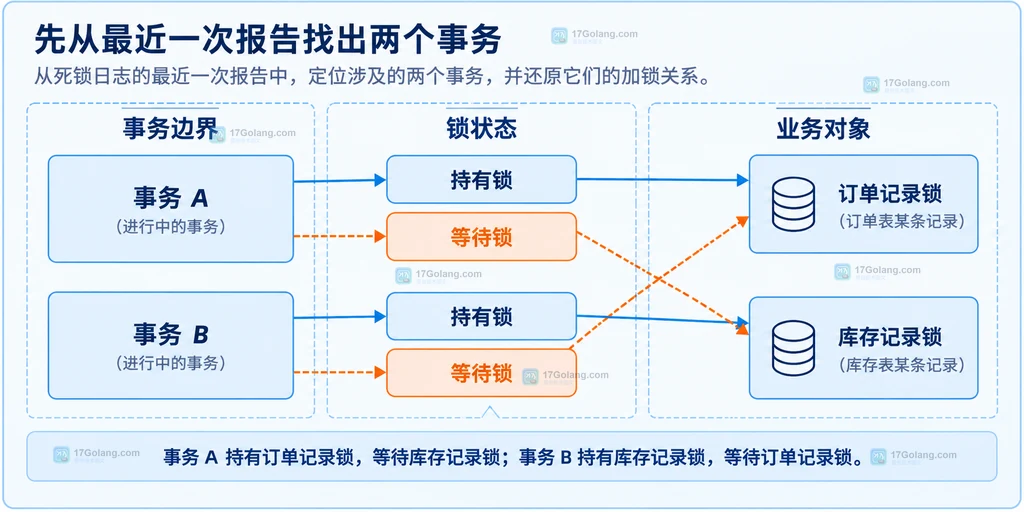
先从最近一次报告找出两个事务
排查入口先保持简单,直接读取 InnoDB 保存的最近一次死锁信息:
-- 读取最近一次死锁;结果中的 LATEST DETECTED DEADLOCK 是重点
SHOW ENGINE INNODB STATUS\G

-- 频发排查时临时记录每一次死锁到错误日志
SET GLOBAL innodb_print_all_deadlocks = ON;
报告通常分成事务一和事务二。先抄下每个事务的线程号、执行中的 SQL、锁住的表和索引,不要一看到 WAITING 就直接修改超时时间。InnoDB 默认会检测环并回滚一个事务;innodb_print_all_deadlocks 适合收集连续样本,问题定位完成后应关闭它,避免错误日志只增长不归档。
用“持有锁—等待锁”还原交叉加锁路径
把报告压缩成四句话最容易判断:
- 事务 A 已持有订单行,接着等待库存行。
- 事务 B 已持有库存行,接着等待订单行。
- A 等待 B 释放,B 又等待 A 释放。
- 环路闭合,InnoDB 选择权重较小的事务回滚。
例如两个业务入口分别按“订单→库存”和“库存→订单”更新,即使每条语句只改一行,也可能因为两条语句合在同一事务里而形成死锁。日志里的索引名很重要:它说明锁落在哪条索引记录或范围上。若同一条 SQL 锁住了比预期更宽的范围,应继续看执行计划和索引条件,而不是只盯着表名。
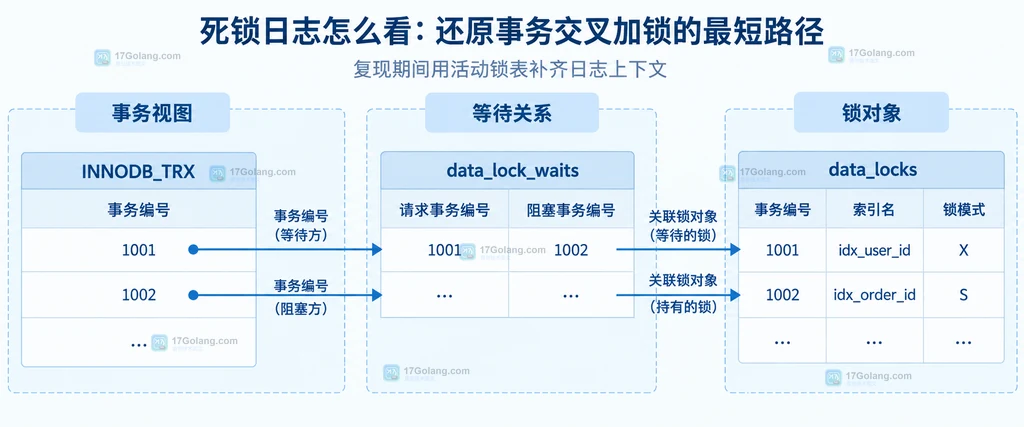
复现期间用活动锁表补齐日志上下文
死锁已经结束后,活动锁表可能看不到原现场;在问题仍能复现时,可用下面的关联查询观察当前等待关系。结果变化很快,只适合作为现场快照。
-- 把等待关系连接到请求锁和阻塞锁,便于确认两端对象
SELECT
  w.REQUESTING_ENGINE_TRANSACTION_ID AS waiting_trx,
  w.BLOCKING_ENGINE_TRANSACTION_ID AS blocking_trx,
  r.OBJECT_SCHEMA AS waiting_schema,
  r.OBJECT_NAME AS waiting_table,
  r.INDEX_NAME AS waiting_index,
  r.LOCK_MODE AS waiting_mode
FROM performance_schema.data_lock_waits AS w
JOIN performance_schema.data_locks AS r
  ON r.ENGINE_LOCK_ID = w.REQUESTING_ENGINE_LOCK_ID;

-- 查看事务状态、开始时间和当前语句
SELECT trx_id, trx_state, trx_started, trx_query
FROM information_schema.innodb_trx;
data_locks 与 data_lock_waits 展示的是快速变化的内部状态,不能把不同时间的查询结果当成一份完全一致的快照。它们的价值在于把事务编号、表、索引和锁模式补到业务日志旁边,帮助确认“看起来相同的 SQL”是否实际走了不同索引。
修复访问顺序,应用侧重试整笔事务
最直接的修复是规定统一顺序:所有会同时改订单和库存的路径都先锁订单,再锁库存;批量更新多行时按同一业务键排序。其次缩短事务,把网络调用、人工确认和无关查询移到事务外,并为过滤条件补合适索引以减少锁住的记录范围。
死锁受害者已经回滚,所以重试边界必须包住完整事务:
// 事务失败时整体回滚,并用有限次数退避重试;不要只重放最后一条 UPDATE。
for attempt := 0; attempt
重试不是掩盖高频死锁的理由。如果报告持续出现,应回到 SQL 顺序、索引和事务边界查根因;只有偶发死锁且事务具备幂等性时,有限退避才是合理的恢复手段。
常见问题
锁等待超时和死锁日志是一回事吗?
不是。死锁是等待关系形成闭环,InnoDB 可以立即选受害者;普通锁等待没有闭环,可能一直等到 innodb_lock_wait_timeout。
打开 innodb_print_all_deadlocks 后要一直保持吗?
不建议。它适合短期取样;定位完成后关闭,并保留必要的错误日志与业务请求标识。
只加大事务超时时间能解决死锁吗?
不能。超时改变等待时长,不会消除交叉加锁;优先统一访问顺序、缩小锁范围并让应用能够重试整笔事务。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习