
批量写入如何兼顾吞吐与回滚成本:事务大小实测方法
来源:17golang原创
时间:2026-10-08 16:31:36 160浏览 收藏
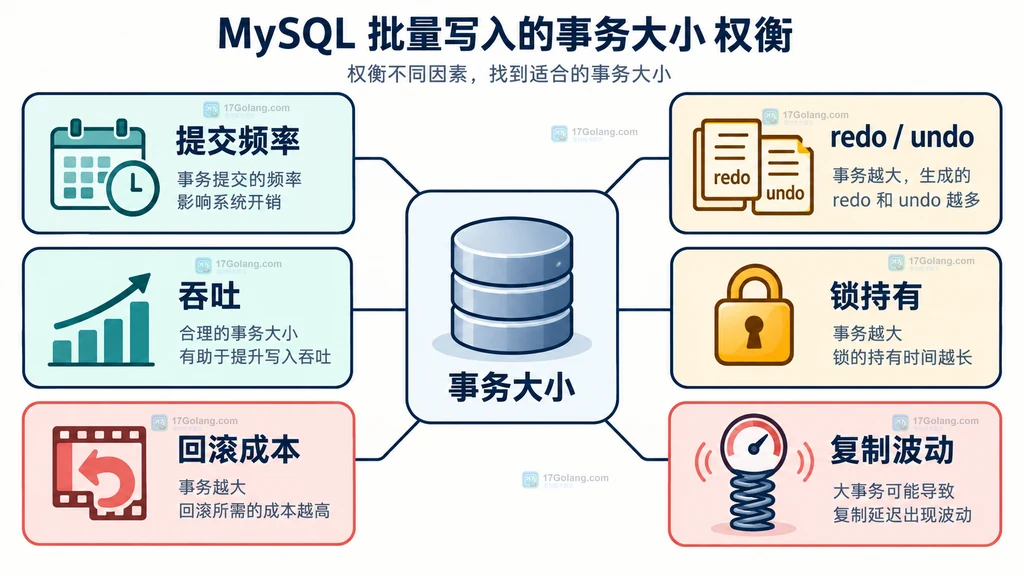
MySQL 批量写入的事务不是越大越好。小事务需要更频繁地提交,固定开销更明显;超大事务虽然可能把吞吐推高,却会拉长锁持有时间、放大 redo/undo 压力,并让失败回滚变得昂贵。正确做法是:固定总数据量与环境,用一组事务大小同时测成功路径和失败路径,再选择满足业务门槛的最小事务。
MySQL 8.4 Reference Manual:https://dev.mysql.com/doc/refman/8.4/en/optimizing-innodb-transaction-management.html
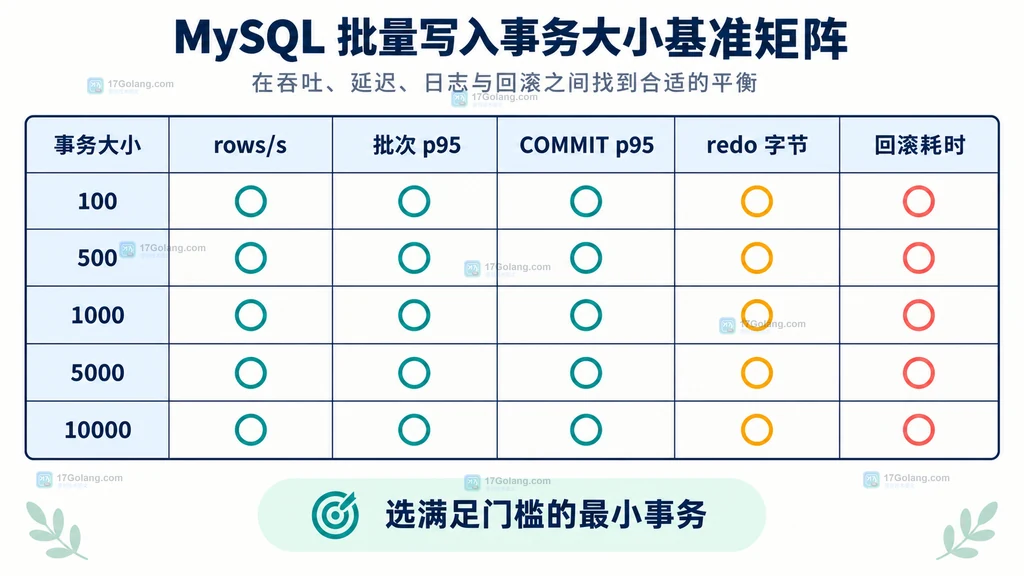
- 候选值从 100、500、1000、5000、10000 行开始。
- 成功路径记录 rows/s、批次 p95、COMMIT p95 与 redo 增量。
- 失败路径在写入 70% 后主动回滚,记录回滚耗时。
- 吞吐达到目标后,选择回滚和尾延迟仍在预算内的最小事务。
消息是什么:官方建议本质上是寻找平衡点
MySQL 8.4 文档在 InnoDB 事务优化章节中明确指出,事务处理要在事务特性的开销与服务器工作负载之间取得平衡。默认 autocommit=1 会让每次修改都单独提交;对繁忙写入场景,把相关修改放进显式事务,可以减少提交次数。但文档也提醒,不要在插入、更新或删除海量行之后再回滚,因为大事务的回滚可能比原修改耗时更长。
因此,事务大小同时改变四类成本:
| 维度 | 事务变大时的常见变化 | 需要测什么 |
|---|---|---|
| 提交开销 | 每行分摊的 COMMIT 次数减少 | COMMIT p50/p95、rows/s |
| 日志与刷盘 | 单事务产生更多 redo,可能逼近日志与 checkpoint 边界 | redo 字节增量、吞吐波动 |
| 并发影响 | 锁和连接占用时间可能变长 | 批次 p95、锁等待、死锁 |
| 故障恢复 | 失败时需要撤销更多修改 | 主动回滚时间、重试范围 |
这也是为什么不能照搬“每批 1000 行”或“每批 1 万行”。同样的行数,在窄表与宽表、无二级索引与多个二级索引、单连接与高并发、普通磁盘与高速 NVMe 上,成本并不相同。
适用场景:先确认这次测试解决什么问题
这套方法适用于离线导入、消息消费落库、同步任务、历史数据回填和应用层批量插入。目标应写成可判断的门槛,例如:
- 持续吞吐不少于 2 万行/秒;
- 单批 p95 不超过 300 毫秒;
- 注入失败后的回滚不超过 2 秒;
- 并发业务的锁等待与复制延迟不超过既定告警线。
以上数字只是说明门槛的写法,不是 MySQL 的通用推荐值。实际值应来自你的 SLO、重试超时和运维恢复要求。
快速试用一:准备隔离测试表
不要直接在生产表跑回滚实验。建立结构相近的隔离表,保留主键、关键二级索引和接近真实的行宽;否则只测到了一个过于理想的插入模型。
-- 创建独立测试库,避免影响业务数据
CREATE DATABASE IF NOT EXISTS batch_lab
  CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci;
USE batch_lab;

-- 模拟带业务键和二级索引的写入表
CREATE TABLE IF NOT EXISTS batch_probe (
  id BIGINT NOT NULL,
  batch_key VARCHAR(64) NOT NULL,
  payload VARCHAR(256) NOT NULL,
  created_at DATETIME(6) NOT NULL,
  PRIMARY KEY (id),
  KEY idx_batch_key (batch_key),
  KEY idx_created_at (created_at)
) ENGINE=InnoDB;
测试前记录配置,但不要为了跑分临时降低生产可靠性。尤其要固定 innodb_flush_log_at_trx_commit、sync_binlog、binlog 格式、redo 容量、隔离级别和连接并发。
-- 记录会改变提交与日志成本的关键配置
SELECT @@version,
       @@innodb_flush_log_at_trx_commit,
       @@sync_binlog,
       @@binlog_format,
       @@transaction_isolation,
       @@innodb_redo_log_capacity;

-- 记录测试前的 redo 累计字节数,测试后取差值
SHOW GLOBAL STATUS LIKE 'Innodb_os_log_written';

-- 记录当前行锁等待数量,便于并发复测时对照
SHOW GLOBAL STATUS LIKE 'Innodb_row_lock_current_waits';
Innodb_os_log_written 是实例全局累计值。要用它比较候选事务大小,应在没有其他写流量的隔离实例执行,或至少保证每轮的后台负载一致。
快速试用二:用同一脚本跑事务梯度
下面脚本固定总行数为 10 万,只改变每个事务包含的行数。每个候选值都会清空测试表、分批写入并记录总吞吐、批次延迟和提交延迟;随后用未落库的新主键写入候选批次的 70%,主动执行 ROLLBACK 并记录耗时。
# 安装 MySQL 官方 Python 连接器
python3 -m pip install mysql-connector-python

# 使用隔离测试账号执行,不要指向生产库
export MYSQL_HOST='127.0.0.1'
export MYSQL_PORT='3306'
export MYSQL_USER='batch_lab_user'
export MYSQL_PASSWORD='请替换为测试密码'
python3 batch_probe.py
import csv
import os
import statistics
import time
from datetime import datetime

import mysql.connector

# 固定总数据量,只改变每个事务的行数
TOTAL_ROWS = 100_000
BATCH_SIZES = [100, 500, 1_000, 5_000, 10_000]


def percentile(values, ratio):
    # 使用最近秩法计算分位数,避免引入额外依赖
    ordered = sorted(values)
    index = max(0, min(len(ordered) - 1, int(len(ordered) * ratio) - 1))
    return ordered[index]


def redo_bytes(cursor):
    # 读取实例累计 redo 字节数;应在隔离实例中取差值
    cursor.execute("SHOW GLOBAL STATUS LIKE 'Innodb_os_log_written'")
    return int(cursor.fetchone()[1])


def make_rows(start_id, count, batch_size):
    # 生成确定性的行,保证各候选值的数据形态一致
    now = datetime.now()
    return [
        (row_id, f"size-{batch_size}", "x" * 200, now)
        for row_id in range(start_id, start_id + count)
    ]


def run_success(conn, batch_size):
    cursor = conn.cursor()
    cursor.execute("TRUNCATE TABLE batch_probe")
    redo_start = redo_bytes(cursor)
    batch_seconds = []
    commit_seconds = []
    started = time.perf_counter()

    for offset in range(0, TOTAL_ROWS, batch_size):
        current = min(batch_size, TOTAL_ROWS - offset)
        rows = make_rows(offset + 1, current, batch_size)
        batch_started = time.perf_counter()
        conn.start_transaction()
        cursor.executemany(
            "INSERT INTO batch_probe "
            "(id, batch_key, payload, created_at) VALUES (%s, %s, %s, %s)",
            rows,
        )

        # 单独记录 COMMIT,观察事务增大后的尾延迟
        commit_started = time.perf_counter()
        conn.commit()
        commit_seconds.append(time.perf_counter() - commit_started)
        batch_seconds.append(time.perf_counter() - batch_started)

    elapsed = time.perf_counter() - started
    redo_delta = redo_bytes(cursor) - redo_start
    cursor.close()
    return {
        "batch_size": batch_size,
        "rows_per_second": TOTAL_ROWS / elapsed,
        "batch_p50_ms": statistics.median(batch_seconds) * 1000,
        "batch_p95_ms": percentile(batch_seconds, 0.95) * 1000,
        "commit_p95_ms": percentile(commit_seconds, 0.95) * 1000,
        "redo_bytes": redo_delta,
    }


def run_rollback(conn, batch_size):
    cursor = conn.cursor()
    rollback_rows = max(1, int(batch_size * 0.7))
    rows = make_rows(TOTAL_ROWS + 1, rollback_rows, batch_size)
    conn.start_transaction()
    cursor.executemany(
        "INSERT INTO batch_probe "
        "(id, batch_key, payload, created_at) VALUES (%s, %s, %s, %s)",
        rows,
    )

    # 主动注入失败路径,只测撤销时间,不提交这些数据
    started = time.perf_counter()
    conn.rollback()
    elapsed_ms = (time.perf_counter() - started) * 1000
    cursor.close()
    return rollback_rows, elapsed_ms


conn = mysql.connector.connect(
    host=os.environ["MYSQL_HOST"],
    port=int(os.environ.get("MYSQL_PORT", "3306")),
    user=os.environ["MYSQL_USER"],
    password=os.environ["MYSQL_PASSWORD"],
    database="batch_lab",
    autocommit=False,
)

# 结果保存为 CSV,至少重复三轮后再比较中位数与 p95
with open("batch-results.csv", "w", newline="", encoding="utf-8") as handle:
    fieldnames = [
        "batch_size", "rows_per_second", "batch_p50_ms",
        "batch_p95_ms", "commit_p95_ms", "redo_bytes",
        "rollback_rows", "rollback_ms",
    ]
    writer = csv.DictWriter(handle, fieldnames=fieldnames)
    writer.writeheader()
    for size in BATCH_SIZES:
        result = run_success(conn, size)
        rollback_rows, rollback_ms = run_rollback(conn, size)
        result.update({"rollback_rows": rollback_rows, "rollback_ms": rollback_ms})
        writer.writerow(result)

conn.close()
第一轮通常包含连接建立、缓存预热和文件扩展等噪声。正式比较时建议每个候选值至少重复三轮,随机化候选顺序,并同时观察冷缓存与稳态结果。若总行数不能被批次整除,脚本会自动处理最后一个较小事务。
怎么读结果:先找拐点,再套业务门槛
不要只按 rows/s 排名。将每轮结果汇总后,按下面顺序判断:
- 找吞吐拐点:事务从 100 增到 500、1000 时吞吐可能明显提升;继续增大后若收益已经很小,就没有必要继续放大失败半径。
- 检查尾延迟:平均值看起来平稳时,批次 p95 和 COMMIT p95 可能已经抬升。在线链路更应优先看尾延迟。
- 检查日志压力:比较每行 redo 字节与吞吐波动。若大事务让 checkpoint 压力周期性显现,应同时核对 redo 容量和刷盘能力,而不是只调批次行数。
- 检查回滚预算:把
rollback_ms与任务超时、消息可见性超时、连接池占用预算对照。 - 选择最小达标值:如果 1000 行已达到吞吐目标,而 5000 行只多出少量吞吐却显著提高回滚 p95,就选择 1000,而不是追逐峰值。
和旧方案对比:逐条提交、中等事务、超大事务
| 方案 | 优点 | 主要问题 | 适用边界 |
|---|---|---|---|
| 逐条自动提交 | 失败半径最小,逻辑直观 | 提交与日志同步次数多,吞吐容易受限 | 低频写入、每条必须独立确认 |
| 中等大小显式事务 | 能分摊提交成本,回滚与重试边界清晰 | 需要基准、幂等键和批次检查点 | 大多数应用层批量导入与消费 |
| 一个超大事务 | 提交次数最少 | 日志、锁、purge、复制和回滚风险集中 | 仅在充分验证且可接受大失败半径时考虑 |
多值 INSERT 与事务大小是两个不同维度:一条 SQL 可以写多行,一个事务也可以包含多条多值 SQL。测试时应固定 SQL 形态,只改变事务包含的总行数,否则无法区分收益来自减少网络往返,还是来自减少 COMMIT 次数。
采用风险一:长事务不仅影响自己
官方文档指出,长事务可能阻止 purge 清理其他事务产生的旧版本;并发读取还可能需要做更多工作来重建历史版本。写入涉及热点索引或更新已有行时,锁持有时间也会扩大对其他会话的影响。因此,单连接隔离基准通过后,还要在接近生产的并发下复测锁等待、死锁、业务查询 p95 与连接池占用。
采用风险二:持久化参数必须保持一致
innodb_flush_log_at_trx_commit 与 sync_binlog 会直接改变提交成本和故障时的数据保证。若一轮使用严格持久化,另一轮为了速度降低落盘要求,比较结果没有意义。性能实验只能在业务允许的可靠性配置下进行;不要把“可能丢失最近已提交事务”当作免费优化。
采用风险三:回滚测试不等于崩溃恢复
脚本测的是会话主动 ROLLBACK,可以量化应用错误或校验失败的撤销代价。它不能替代进程崩溃、主机断电、复制切换或 crash recovery 演练。若批量任务是关键链路,应另外在受控环境验证实例重启、主从延迟与重放行为。
把事务做小之后,还要补上幂等与检查点
把大任务切成多个事务意味着前面批次可能已经提交,后面批次才失败。应用层应给每个导入任务分配稳定的 batch_key,给每条业务记录设置唯一键,并在提交后保存检查点。重试时从最后一个成功检查点继续,让“缩小事务”不会变成“重复写入”。
-- 业务唯一键让重试能够识别已经写入的记录
ALTER TABLE batch_probe
  ADD UNIQUE KEY uk_batch_item (batch_key, id);

-- 重试时可按业务规则选择忽略或更新,不能盲目重复插入
INSERT INTO batch_probe (id, batch_key, payload, created_at)
VALUES (100001, 'job-20261008', 'payload', NOW(6))
ON DUPLICATE KEY UPDATE
  payload = VALUES(payload),
  created_at = VALUES(created_at);
最终选择清单
- 固定总行数、行宽、索引、并发、SQL 形态和持久化配置。
- 每个候选值至少重复三轮,记录中位数与 p95。
- 成功路径同时看吞吐、批次延迟、提交延迟与 redo。
- 失败路径测主动回滚,并另行安排崩溃恢复演练。
- 在接近生产的并发下复测锁等待、死锁和复制延迟。
- 选择满足全部门槛的最小事务,而不是 rows/s 最高的事务。
事务大小是一个业务恢复边界,不只是吞吐参数。只要把成功速度与失败代价放进同一张结果表,MySQL 批量写入的选择就会从经验数字变成可重复、可解释的工程决策。
延伸阅读:https://dev.mysql.com/doc/refman/8.4/en/optimizing-innodb-logging.html
锁与事务模型:https://dev.mysql.com/doc/refman/8.4/en/innodb-locking-transaction-model.html
-
374 收藏
-
499 收藏
-
384 收藏
-
184 收藏
-
265 收藏
-
337 收藏
-
420 收藏
-
153 收藏
-
313 收藏
-
351 收藏
-
112 收藏
-
127 收藏
-
291 收藏
-
500 收藏
-
169 收藏
-
255 收藏
-
数据库 · MySQL | 1天前 | MySQL · 数据库运维 · MySQL备份 MySQL Clone CLONE LOCAL DATA DIRECTORY 本地克隆 clone_status285 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习