
Python 日志 QueueHandler 解决多进程写入争用
来源:17golang原创
时间:2026-10-08 20:11:52 186浏览 收藏
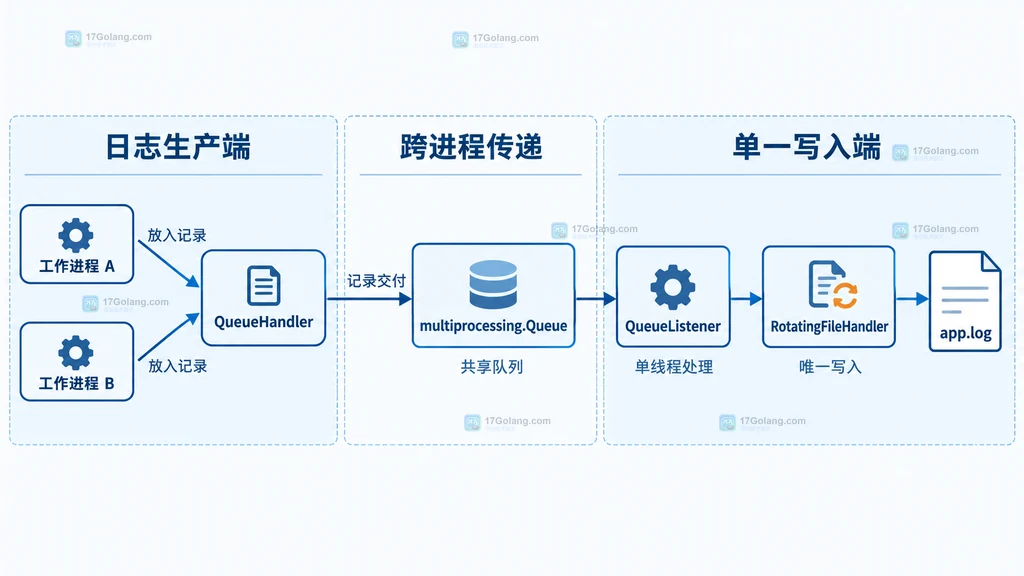
Python 多进程同时写一个日志文件时,不要让每个进程各自创建 FileHandler 或 RotatingFileHandler。标准 logging 只保证同一进程内的线程安全,没有提供让多个进程安全串行写同一文件的共享锁。更稳妥的结构是:工作进程只用 QueueHandler 把 LogRecord 放进 multiprocessing.Queue,主进程中的 QueueListener 负责从队列取出记录,再交给唯一的文件处理器写盘。
这样能把“多个文件写入者争用”改成“多个日志生产者加一个文件写入者”。文件打开、格式化、轮转和关闭都集中在监听端,工作进程不接触日志文件。
QueueHandler 官方文档:https://docs.python.org/3.14/library/logging.handlers.html#queuehandler
多进程日志 Cookbook:https://docs.python.org/3.14/howto/logging-cookbook.html#logging-to-a-single-file-from-multiple-processes
multiprocessing 队列文档:https://docs.python.org/3.14/library/multiprocessing.html#pipes-and-queues
- 多个进程不再同时打开、写入或轮转同一个文件。
- 工作进程只负责产生日志,慢速文件 I/O 集中到监听端。
- 日志格式、级别、轮转与保留策略只配置一次。
- 退出时可以先收完工作进程的记录,再停止监听器和关闭队列。
先确认争用来自多进程文件处理器
logging 的处理器带有线程锁,因此同一进程中的多个线程可以共享一个 FileHandler。但多个进程拥有各自的 Python 运行时、锁和文件描述符,某个进程的处理器锁不能约束另一个进程。直接让多个进程写同一文件,常见风险包括:
- 不同进程的记录在文件中交错,较长记录可能被拆开;
- 两个 RotatingFileHandler 同时判断需要轮转,重命名或删除互相冲突;
- 一个进程仍持有旧文件描述符,日志继续写入已经轮转的文件;
- 进程异常退出时,缓冲数据没有完整写出。
给每个进程再加一个普通 threading.Lock 没有作用,因为它不是进程共享锁。可以自行用 multiprocessing.Lock 包装文件处理器,但日志轮转、错误处理和退出协议会变复杂。QueueHandler 方案把文件 I/O 收口到一个写入端,更容易维护。
建立单写入者日志结构
工作进程中的根日志器只挂载 QueueHandler。每条记录经过 prepare() 处理后进入进程安全的 multiprocessing.Queue。主进程启动一个 QueueListener,监听器内部线程取出记录,并串行调用唯一的 RotatingFileHandler。
| 组件 | 所在位置 | 唯一职责 |
|---|---|---|
| 业务 Logger | 每个工作进程 | 创建包含级别、名称、消息和上下文的 LogRecord |
| QueueHandler | 每个工作进程 | 整理并把记录放入共享队列 |
| multiprocessing.Queue | 父进程创建,传给工作进程 | 序列化并跨进程传递记录 |
| QueueListener | 主进程 | 在监听线程中取出记录并分发给下游处理器 |
| RotatingFileHandler | 仅主进程 | 格式化、写入和轮转日志文件 |
编写可直接复用的完整示例
下面的示例使用 spawn 上下文,便于在 Windows、macOS 和 Linux 上保持相近的启动语义。共享队列在主进程创建,并显式传给工作进程。每个子进程重新配置根日志器,避免重复挂载处理器。
from __future__ import annotations

import logging
import multiprocessing as mp
from logging.handlers import QueueHandler, QueueListener, RotatingFileHandler
from pathlib import Path


def configure_worker(log_queue: mp.Queue) -> None:
    """让工作进程只把日志记录放入共享队列。"""
    root = logging.getLogger()
    root.handlers.clear()  # spawn 子进程中也显式清理,避免重复处理器
    root.setLevel(logging.INFO)
    root.addHandler(QueueHandler(log_queue))


def worker(worker_id: int, log_queue: mp.Queue) -> None:
    """模拟一个只产生日志、不直接写文件的工作进程。"""
    configure_worker(log_queue)
    logger = logging.getLogger(f"worker.{worker_id}")

    for task_id in range(5):
        # 结构化字段通过 extra 加入 LogRecord,便于监听端统一格式化。
        logger.info(
            "任务处理完成",
            extra={"worker_id": worker_id, "task_id": task_id},
        )


def build_file_handler(log_path: Path) -> RotatingFileHandler:
    """只在主进程创建唯一的轮转文件处理器。"""
    handler = RotatingFileHandler(
        log_path,
        maxBytes=2 * 1024 * 1024,  # 单个日志文件上限为 2 MiB
        backupCount=3,             # 最多保留三个历史文件
        encoding="utf-8",
    )
    handler.setLevel(logging.INFO)
    handler.setFormatter(
        logging.Formatter(
            "%(asctime)s %(processName)s %(name)s "
            "%(levelname)s worker=%(worker_id)s task=%(task_id)s %(message)s"
        )
    )
    return handler


def main() -> None:
    """启动监听器和工作进程,并按安全顺序完成清理。"""
    ctx = mp.get_context("spawn")
    log_queue = ctx.Queue(-1)  # 多进程场景使用 multiprocessing.Queue
    file_handler = build_file_handler(Path("app.log"))
    listener = QueueListener(
        log_queue,
        file_handler,
        respect_handler_level=True,  # 遵守下游处理器的 INFO 级别
    )

    listener.start()
    processes = [
        ctx.Process(
            target=worker,
            args=(worker_id, log_queue),
            name=f"Worker-{worker_id}",
        )
        for worker_id in range(4)
    ]

    try:
        for process in processes:
            process.start()
        for process in processes:
            process.join()  # 先等待生产端结束,确保记录已经进入队列

        failed = [p.name for p in processes if p.exitcode != 0]
        if failed:
            raise RuntimeError(f"工作进程异常退出: {failed}")
    finally:
        listener.stop()       # 再让监听器消费到停止哨兵
        file_handler.close()  # 最后关闭唯一的文件写入端
        log_queue.close()
        log_queue.join_thread()  # 等待队列后台线程刷新缓冲数据


if __name__ == "__main__":
    # spawn 模式必须使用 main 保护,防止子进程重复创建进程。
    main()
示例把 worker_id 和 task_id 作为扩展字段,因此 Formatter 可以在监听端统一输出它们。实际项目如果有些记录不带这些字段,应使用 Filter 补默认值,或改用不依赖自定义字段的基础格式,避免格式化阶段抛出 KeyError。
运行后怎样核对结构是否正确
将示例保存为 queue_logging_demo.py 后,可以从普通命令行启动。下面只是复现命令,不是本文配图或本地运行证据。
# 启动四个工作进程,日志由主进程中的监听器统一写入 app.log
python queue_logging_demo.py

# 查看当前日志及可能生成的轮转文件,只用于核对文件结构
ls -lh app.log app.log.* 2>/dev/null
核对时不要只看“文件存在”。还应检查三个结果:
- 每行都包含
Worker-0到Worker-3中的进程名,以及对应 worker 和 task 字段。 - 按示例参数,每个工作进程写 5 条记录,正常结束时总数应为 20 条。
- 业务进程中没有 FileHandler,日志文件只由主进程中的 RotatingFileHandler 打开。
如果记录数量不足,先检查工作进程退出码,再检查是否在工作进程结束前调用了 listener.stop(),以及是否使用 terminate() 强制杀死仍在写队列的进程。官方 multiprocessing 文档提醒,进程在使用 Queue 时被强制终止,队列可能损坏。
处理队列容量与异常记录
QueueHandler.enqueue() 默认调用 put_nowait()。使用有上限的队列时,如果队列已满,会进入 logging 的 handleError():生产环境中可能静默丢弃记录,也可能在开发模式输出到 stderr。选择容量时,要明确是允许丢低级别日志、短暂阻塞业务,还是把日志转移到独立服务。
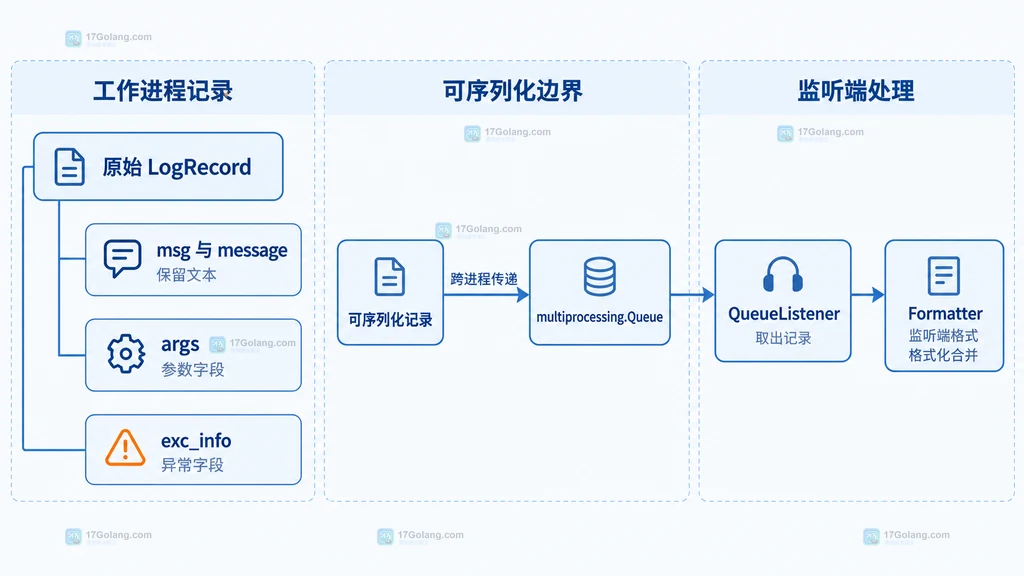
另一个容易忽略的点是序列化。multiprocessing.Queue 会 pickle 放入其中的对象。QueueHandler 的默认 prepare() 会先合并消息和参数,并把 args、exc_info、exc_text 等字段调整为可序列化形式。因此:
extra中不要放打开的文件、锁、连接、生成器等不可 pickle 对象;- 默认 prepare 会改变异常字段,监听端不一定还能自定义异常堆栈格式;
- 需要保留结构化异常信息时,应继承 QueueHandler,返回一个可 pickle 的记录副本或字典;
- 过滤级别尽量在工作进程完成,避免把最终会被丢弃的大量 DEBUG 记录跨进程传输。
如果日志绝不能丢,可以继承 QueueHandler,让入队操作带有限时阻塞;但这会把日志拥塞反向传给业务线程,必须同时设置监控和降级策略。
from logging.handlers import QueueHandler
from queue import Full


class BlockingQueueHandler(QueueHandler):
    """在短时间内等待队列空位,超时后交给 logging 错误处理。"""

    def enqueue(self, record) -> None:
        try:
            # 最多等待 0.2 秒,避免日志拥塞无限阻塞业务。
            self.queue.put(record, block=True, timeout=0.2)
        except Full:
            # 统一走 Handler.handleError,具体是否输出取决于 logging 配置。
            self.handleError(record)
避开 multiprocessing 内部日志递归
multiprocessing 有自己的内部 logger。multiprocessing.Queue 在放入对象时可能产生 DEBUG 日志;如果这个内部 logger 又挂载了一个指向同一 Queue 的 QueueHandler,就会再次触发入队,形成死锁或无限递归。
实用规则是:
- 不要把
multiprocessing.get_logger()配置成使用业务日志的同一个 QueueHandler; - 不要为了排查队列而把 multiprocessing 内部 logger 调成 DEBUG 后再送回同一队列;
- 内部诊断如确有需要,使用独立的 stderr 处理器或另一条队列;
- 多进程日志队列使用
multiprocessing.Queue,官方文档明确建议避免在这里使用 SimpleQueue。
按正确顺序停止监听器
退出顺序决定最后一批日志能否落盘。推荐顺序是:
- 通知工作进程停止产生新任务和新日志;
join()所有工作进程,确认它们已经退出;- 调用
listener.stop(),让 QueueListener 消费到停止哨兵; - 关闭文件处理器;
- 关闭 Queue,并调用
join_thread()等待后台 feeder 线程结束。
不要先 stop 监听器再等待工作进程,否则工作进程仍可能继续入队,而已经没有消费者。也不要随意对正在使用队列的进程调用 terminate();这不只是丢几条日志,还可能让共享队列本身进入损坏状态。
常见问题
QueueListener 必须放在独立进程吗?
不必须。它内部使用线程,可以放在主进程中,配合唯一文件处理器完成串行写入。若主进程生命周期不稳定、日志吞吐很高或需要独立部署,也可以采用官方 Cookbook 中的独立 listener 进程方案。
为什么不直接给 FileHandler 加 multiprocessing.Lock?
可以自定义这种方案,但要同时正确处理锁共享、格式化、异常、轮转、进程崩溃和关闭。QueueHandler 结构把这些职责集中到一个写入端,通常更容易验证和扩展。
使用无界 Queue 就一定不会丢日志吗?
不能这样保证。无界队列减少“队列满”的问题,但监听端过慢时会持续占用内存;进程被强制终止、机器宕机或记录无法 pickle 仍可能造成丢失。生产环境还要监控队列积压、监听端异常和磁盘空间。
能在监听端按 logger 名称写不同文件吗?
可以。QueueListener 可以接多个 Handler,也可以给 Handler 添加 Filter,根据 record.name、级别或业务字段筛选。所有目标文件仍应各自只有一个真正写入者。
QueueHandler 的价值不只是“把日志放进队列”,而是把多进程文件争用改造成清晰的所有权结构:工作进程生产 LogRecord,共享队列负责传递,QueueListener 和唯一文件处理器负责落盘。再把序列化、队列容量、内部日志和关闭顺序补齐,这套结构才适合长期运行。
-
285 收藏
-
484 收藏
-
241 收藏
-
232 收藏
-
261 收藏
-
399 收藏
-
341 收藏
-
463 收藏
-
478 收藏
-
292 收藏
-
393 收藏
-
126 收藏
-
427 收藏
-
132 收藏
-
文章 · python教程 | 1天前 | 并发 · 异常处理 · python · asyncio · CancelledError 结构化并发 ExceptionGroup Python asyncio TaskGroup asyncio gather246 收藏
-
337 收藏
-
359 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习