
JFR 事件流如何在线聚合延迟指标
来源:17golang原创
时间:2026-10-10 01:06:47 418浏览 收藏
JFR 事件流可以在线聚合延迟指标:用 RecordingStream 按事件名接收 RecordedEvent,在回调里立即取出 Duration、标签和状态,只做固定桶计数;再由独立调度器周期生成 count、平均值、错误数以及近似 P95/P99 快照。真正需要避免的是在事件回调里排序、打印大量日志或调用远程指标接口。
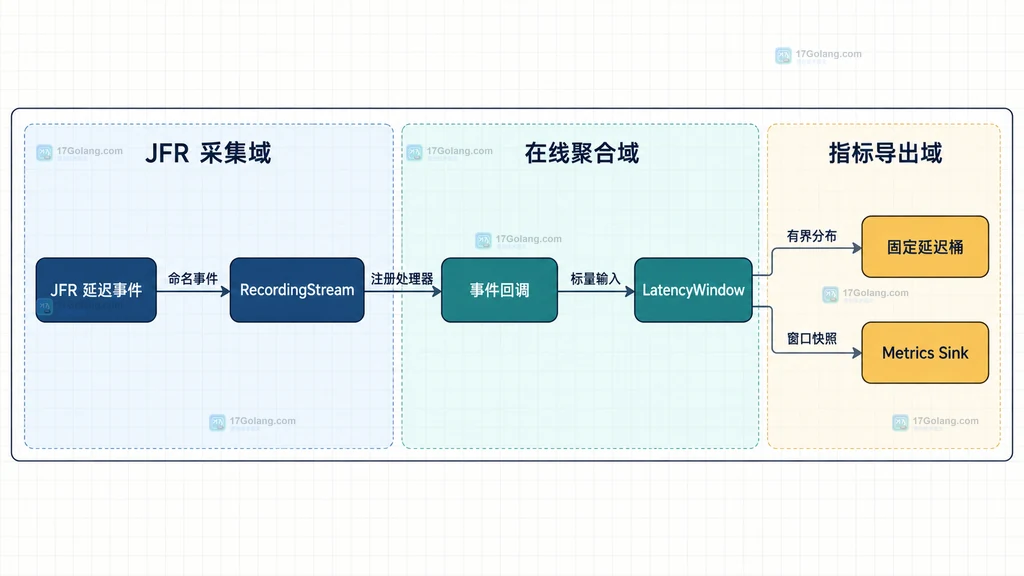
我第一次把 JFR 事件接到服务指标时,最不适应的是它看起来很像普通监听器,于是很自然地想在 onEvent 里完成所有事情。后来我把回调缩成“读取标量并累加”后,接口反而清楚了:JFR 负责采集,LatencyWindow 负责有界统计,Metrics Sink 负责输出,三者不互相承担对方的失败。
官方文档:https://docs.oracle.com/en/java/javase/25/jfapi/
先定义在线聚合接口的边界
我会先把调用关系限制成三个边界:
- JFR 采集域:启用目标事件、注册命名处理器、提取
route、status和duration; - 在线聚合域:只接受普通标量,更新固定桶、总次数、总耗时和错误次数;
- 指标导出域:周期读取窗口快照,再写日志、Prometheus 适配器或其他后端。
Oracle 的 RecordingStream 文档说明,它消费当前 JVM 的事件,并实现 AutoCloseable;startAsync() 会在一个独立线程中执行动作。因此,回调虽然不占用业务线程,但依然不适合承载无界工作。让回调只调用 record(),是我认为最重要的 API 取舍。
为延迟事件配置名称与阈值
示例先定义一个应用级事件。事件名是消费者与生产者之间的稳定契约,字段则保持少而明确。业务代码只负责 begin()、填写标签并 commit()。
import jdk.jfr.Category;
import jdk.jfr.Event;
import jdk.jfr.Label;
import jdk.jfr.Name;
import jdk.jfr.StackTrace;

@Name("com.acme.RequestLatency")
@Label("请求延迟")
@Category({"Application", "Latency"})
@StackTrace(false)
final class RequestLatencyEvent extends Event {
    @Label("路由")
    String route;

    @Label("状态码")
    int status;
}

final class ProfileService {
    String loadProfile(String userId) {
        var event = new RequestLatencyEvent();
        event.route = "profile.load";
        event.begin();
        try {
            // 这里替换成真实业务调用,示例只保留事件边界
            event.status = 200;
            return "profile:" + userId;
        } catch (RuntimeException ex) {
            // 失败状态随事件提交,聚合器据此累计 error
            event.status = 500;
            throw ex;
        } finally {
            // commit 后事件持续时间可由 RecordedEvent.getDuration() 读取
            event.commit();
        }
    }
}
消费端可以用 withThreshold(Duration) 过滤短于阈值的事件,并用 withoutStackTrace() 关闭当前指标不需要的堆栈。阈值不是越大越好:设得过高会让低延迟区间失真,设为零又可能产生过多事件。我的做法是让它与监控目标一致,例如只关心 2 毫秒以上的服务调用,就明确写成 2 毫秒。
用固定桶维护窗口指标
如果每个窗口都保存全部样本再排序,内存与暂停时间会跟事件量增长。在线聚合更适合固定桶:桶边界在创建时确定,每个事件只找到一个桶并累加。P95/P99 是桶上界近似值,不是精确分位数,但内存有界、成本稳定。
import java.time.Duration;
import java.time.Instant;
import java.util.Arrays;
import java.util.concurrent.atomic.LongAdder;

final class LatencyWindow {
    // 这些桶覆盖 1ms 到 2s,最后一个桶接收更慢的样本
    private final long[] upperBoundsNanos = {
        1_000_000L, 5_000_000L, 10_000_000L, 25_000_000L,
        50_000_000L, 100_000_000L, 250_000_000L,
        500_000_000L, 1_000_000_000L, 2_000_000_000L,
        Long.MAX_VALUE
    };

    private final LongAdder[] buckets = Arrays.stream(upperBoundsNanos)
        .mapToObj(ignored -> new LongAdder())
        .toArray(LongAdder[]::new);
    private final LongAdder count = new LongAdder();
    private final LongAdder totalNanos = new LongAdder();
    private final LongAdder errors = new LongAdder();
    private volatile Instant windowStart = Instant.now();

    void record(Duration duration, boolean error) {
        long nanos = Math.max(0L, duration.toNanos());
        count.increment();
        totalNanos.add(nanos);
        if (error) {
            // 错误计数与延迟分布分开,避免混淆失败率和耗时
            errors.increment();
        }

        for (int i = 0; i = target) {
                    // 返回命中桶的上界,因此是可解释的近似值
                    return upperBoundsNanos[i] == Long.MAX_VALUE
                        ? Double.POSITIVE_INFINITY
                        : upperBoundsNanos[i] / 1_000_000.0;
                }
            }
            return Double.POSITIVE_INFINITY;
        }
    }
}
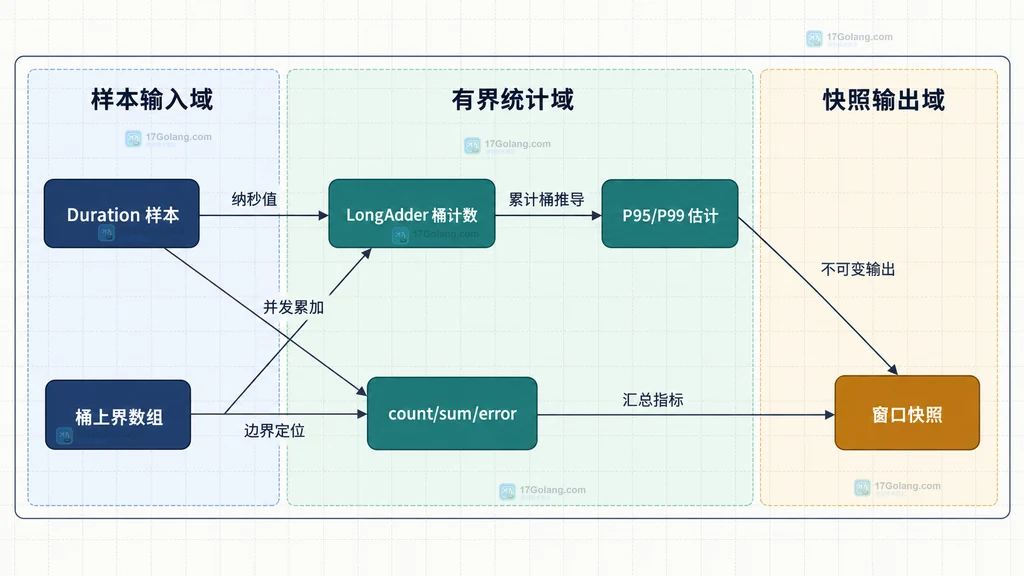
需要说明一个并发边界:LongAdder.sumThenReset() 与正在发生的更新不是原子切面,极少量样本可能落在相邻窗口。对趋势监控通常可以接受;如果你的计费、审计或 SLO 结算要求严格不丢不重,应使用队列或双缓冲窗口,而不是把监控型聚合器当作账本。
把事件回调保持为常数级工作
RecordedEvent 的 getDuration() 返回 Duration,持续时间以纳秒度量。事件字段可能随 JDK 或事件定义变化,Oracle 文档建议先用 hasField() 检查再读取。回调中完成这些字段复制后,就不要继续持有事件对象。
import jdk.jfr.consumer.RecordedEvent;

final class JfrLatencyHandler {
    private final LatencyWindow window;

    JfrLatencyHandler(LatencyWindow window) {
        this.window = window;
    }

    void accept(RecordedEvent event) {
        // 先检查字段,兼容事件定义升级或裁剪
        String route = event.hasField("route")
            ? event.getString("route")
            : "unknown";
        int status = event.hasField("status")
            ? event.getInt("status")
            : 0;

        // 当前示例按总窗口聚合;route 可用于上层维护受控标签集合
        boolean error = status >= 500;
        window.record(event.getDuration(), error);

        // 不在这里打印每个事件,也不把 event 保存到集合或异步任务
        if (route.isEmpty()) {
            // 空标签统一收敛,避免指标标签出现无意义空值
            route = "unknown";
        }
    }
}
上面的 route 只是展示字段读取边界。如果按路由聚合,应先维护一个小而稳定的路由白名单,再按键持有多个 LatencyWindow。不要直接把 URL、用户 ID、SQL 文本或异常消息当成指标标签,否则标签基数可能比事件量更难控制。
设计快照、错误与关闭语义
我最终保留了四个明确约定:
- 窗口语义:快照必须包含开始和结束时间,不能只给一组无时间边界的数字。
- 分位数语义:P95/P99 是桶上界近似值;最后无穷桶命中时输出特殊值,而不是伪造精确毫秒数。
- 错误语义:
onError必须把异常送到应用日志或健康状态,不能让事件流静默停止。 - 资源语义:
RecordingStream和调度器都有明确关闭路径,服务退出时先停止调度,再关闭事件流。
setMaxAge() 与 setMaxSize() 可以限制事件流保留的磁盘数据;官方文档提醒,如果两者都不设置,保留数据可能无限增长。它们控制的是 JFR 存储,不替代应用层窗口聚合的内存边界。
完整组装示例
import java.time.Duration;
import java.util.concurrent.Executors;
import java.util.concurrent.ScheduledExecutorService;
import java.util.concurrent.TimeUnit;
import jdk.jfr.consumer.RecordingStream;

public final class JfrLatencyMonitor implements AutoCloseable {
    private final RecordingStream stream = new RecordingStream();
    private final LatencyWindow window = new LatencyWindow();
    private final JfrLatencyHandler handler = new JfrLatencyHandler(window);
    private final ScheduledExecutorService scheduler =
        Executors.newSingleThreadScheduledExecutor();

    public JfrLatencyMonitor() {
        stream.enable("com.acme.RequestLatency")
            // 只记录达到监控价值的延迟事件
            .withThreshold(Duration.ofMillis(2))
            .withoutStackTrace();

        // 按事件名注册比在通用回调中自行过滤更直接
        stream.onEvent("com.acme.RequestLatency", handler::accept);
        stream.onError(error -> {
            // 生产环境应接入统一日志或健康检查
            System.err.println("JFR stream error: " + error.getMessage());
        });
    }

    public void start() {
        // JFR 回调在独立线程处理,不阻塞启动线程
        stream.startAsync();
        scheduler.scheduleAtFixedRate(() -> {
            var snapshot = window.snapshotAndReset();
            // 远程写入放在调度线程,避免阻塞事件处理器
            System.out.printf(
                "window=%s..%s count=%d avg=%.3fms errors=%d p95
这个接口适合“同一 JVM 内低开销观察延迟趋势”的场景:自定义事件、有限标签、固定桶、短窗口、异步导出。它不适合替代跨服务追踪,也不适合要求精确分位数和严格事件计数的结算系统。
选型与检查清单
| 设计点 | 推荐选择 | 原因 |
|---|---|---|
| 事件订阅 | onEvent(事件名, handler) | 避免消费无关事件后再过滤 |
| 事件设置 | 合理 threshold,按需关闭 stack trace | 控制事件量与采集成本 |
| 回调参数 | Duration、状态、受控标签 | 不让 RecordedEvent 逃逸 |
| 聚合结构 | 固定桶 + LongAdder | 内存有界,更新成本稳定 |
| 分位数 | 明确标注为桶上界近似 | 避免把估算值包装成精确值 |
| 导出 | 独立调度线程消费快照 | 远程 I/O 不阻塞事件线程 |
| 关闭 | 关闭调度器与 RecordingStream | 释放后台线程和底层资源 |
常见问题
可以直接对每个窗口的 Duration 排序吗?
低事件量下可以,但样本数组会随流量增长。固定桶更适合持续在线聚合;需要精确分位数时,应选择有明确误差模型的直方图或摘要算法。
为什么不在 onFlush 中输出全部指标?
onFlush 表示事件流已刷新,并不天然等于业务需要的十秒指标窗口。独立调度器能给窗口更清晰的时间语义,也能隔离导出失败。
start() 和 startAsync() 怎么选?
start() 在当前线程处理动作,直到事件流关闭;startAsync() 在独立线程处理。嵌入长期运行的服务时通常更容易用异步方式绑定应用生命周期。
应该按 route 分组吗?
只有 route 集合稳定且受控时才分组。原始 URL、用户 ID 或动态异常文本会制造高基数,应先归一化或映射到有限业务键。
对我来说,JFR 事件流最有价值的地方不是“又多一种指标 SDK”,而是能把 JVM 内已经存在或很容易提交的事件变成受控的在线统计输入。只要回调足够轻、窗口语义清楚、分位数误差透明,它就很适合补充常规指标系统看不到的应用内部延迟。
-
323 收藏
-
143 收藏
-
147 收藏
-
228 收藏
-
500 收藏
-
415 收藏
-
文章 · java教程 | 10小时前 | spring · Spring Boot · 事务管理 · Java教程 · REQUIRES_NEW Spring事务事件 TransactionalEventListener AFTER_COMMIT Spring事件126 收藏
-
文章 · java教程 | 13小时前 | 配置管理 · Java · Spring Boot · 故障排查 · Java教程 · spring boot actuator @ConfigurationProperties 配置属性绑定 PropertySource184 收藏
-
319 收藏
-
418 收藏
-
435 收藏
-
308 收藏
-
265 收藏
-
370 收藏
-
457 收藏
-
278 收藏
-
文章 · java教程 | 1天前 | Java · 异常处理 · AutoCloseable Java try-with-resources suppressed exception 关闭顺序 getSuppressed197 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习