
Java Commons CSV怎样按表头名称读取字段
来源:17golang原创
时间:2026-10-13 19:45:04 127浏览 收藏
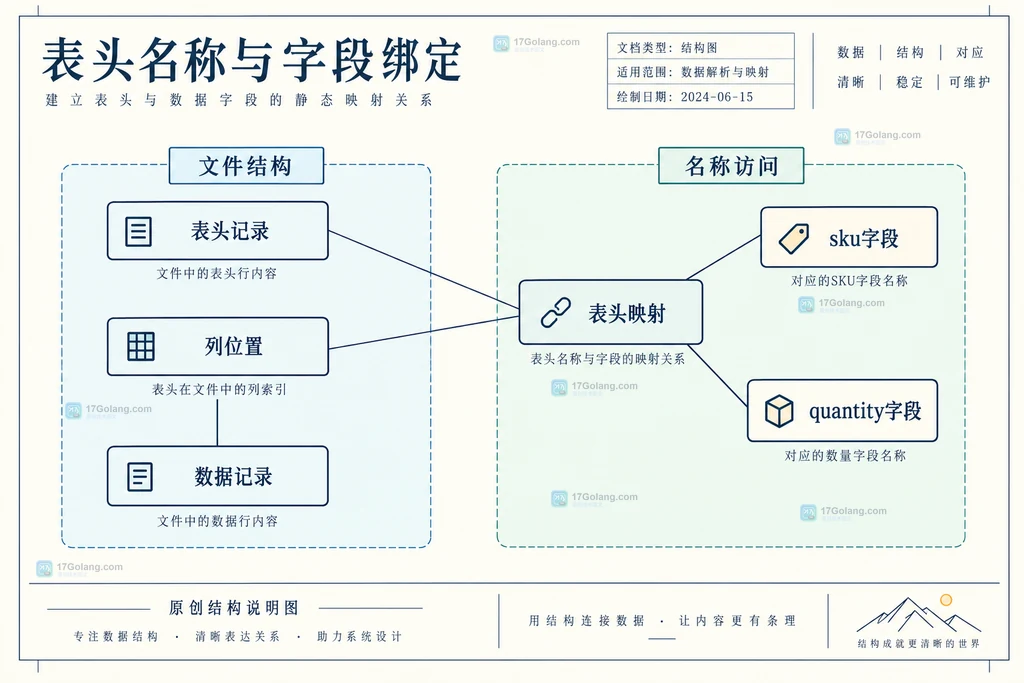
按表头名称读取:先建立映射,再使用 record.get
Java Commons CSV 按名称取字段的关键是让解析器知道表头。CSV 第一条记录就是列名时,使用无参数的 setHeader() 自动读取列名,再通过 record.get("sku") 访问字段。把表头当成数据读入,或者直接给没有表头映射的记录传名称,都不能达到这个目的。这里讨论的是上传文件落盘后,由导入工作器逐条处理的场景。
官方项目及文档:https://commons.apache.org/proper/commons-csv/。本文参考 Apache 的在线 API 文档;页面当前标注为 1.14.2-SNAPSHOT,不将其当成已发布版本号。示例采用支持 Builder.get() 的 Commons CSV API,依赖应固定为项目批准的已发布版本,而不是照抄快照标签。下面代码是实现示例,没有宣称执行过生产导入。
先确定文件契约,避免列名看起来相同却取不到
设想供应方导出的订单明细有 sku、quantity 两列,有时交换顺序,有时追加 remark。业务需要按名字绑定必需字段,同时允许额外列。示例约定第一条记录是表头、英文列名大小写精确匹配、逗号分隔、UTF-8 且不带 BOM;quantity 为非负整数。不符合这些约定的输入应明确拒绝或交给另一套格式规则。
| 方案 | 适用输入 | 主要边界 |
|---|---|---|
| 自动 setHeader() | 文件自带可靠列名,列顺序会变化 | 仍需检查必需列和重复列 |
| 手动 setHeader("sku","quantity") | 无表头且位置契约固定 | 名字由程序按位置赋予,不能自动识别文件真实列名 |
| get(0)、get(1) | 稳定、明确的位置契约 | 调换列可能产生业务错配 |
有表头的上传文件推荐自动识别。手动列名配合跳过首条记录,只是在已知位置契约下忽略一条输入,不能替代读取真实表头。不要为了消除报错随意切换这两种模式。
一个逐条处理的 Java 示例
下面示例使用 Java 11 及以上语法。传入的接收器可以负责写入暂存区或有界批次,但不能把每条记录永久追加到无限增长的集合。完整文件预先载入内存并不是按名称读取的必要条件。
import java.io.IOException;
import java.io.Reader;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.function.BiConsumer;
import org.apache.commons.csv.CSVFormat;
import org.apache.commons.csv.CSVParser;
import org.apache.commons.csv.CSVRecord;
import org.apache.commons.csv.DuplicateHeaderMode;

public final class CsvOrderImport {
    public static long read(Path path, BiConsumer sink)
            throws IOException {
        // 从文件自身读取表头,拒绝重复名称和空列名
        CSVFormat format = CSVFormat.RFC4180.builder()
                .setHeader()
                .setSkipHeaderRecord(true)
                .setDuplicateHeaderMode(DuplicateHeaderMode.DISALLOW)
                .setAllowMissingColumnNames(false)
                .get();

        // 读取器和解析器的生命周期限制在本次导入中
        try (Reader reader = Files.newBufferedReader(path, StandardCharsets.UTF_8);
             CSVParser parser = format.parse(reader)) {
            if (!parser.getHeaderNames().contains("sku")
                    || !parser.getHeaderNames().contains("quantity")) {
                throw new IllegalArgumentException("缺少必需表头");
            }
            long count = 0;
            for (CSVRecord record : parser) {
                // 此规则要求每条数据记录与表头的列数一致
                if (!record.isConsistent()) {
                    throw new IllegalArgumentException(
                            "记录列数不一致,记录号:" + record.getRecordNumber());
                }
                String sku = record.get("sku").strip();
                String text = record.get("quantity").strip();
                if (sku.isEmpty() || text.isEmpty()) {
                    throw new IllegalArgumentException(
                            "必需值为空,记录号:" + record.getRecordNumber());
                }
                int quantity;
                try {
                    // 数量的类型转换是业务责任,不由 CSV 解析器完成
                    quantity = Integer.parseInt(text);
                } catch (NumberFormatException ex) {
                    throw new IllegalArgumentException(
                            "数量不是有效整数,记录号:" + record.getRecordNumber(), ex);
                }
                if (quantity
正常的带引号字段应交给 CSV 解析器处理,不用 split(",") 拆行。示例没有配置 nullString,因此按普通文本处理字段;若另行配置空值标记,需要在 strip() 之前明确处理 null。空文件或仅有表头的文件是否允许,属于导入接口的业务规则,可根据返回计数决定。
解析器与业务工作器各负责什么
解析配置负责分隔符、引号和表头等文件语法;业务代码负责必需字段、数值范围以及接收结果的持久化。getHeaderNames() 是列名列表,适合在开始处理数据前检查输入契约。名称精确匹配策略最容易解释;只有明确允许大小写差异时,才配置忽略表头大小写,避免把命名冲突隐藏起来。
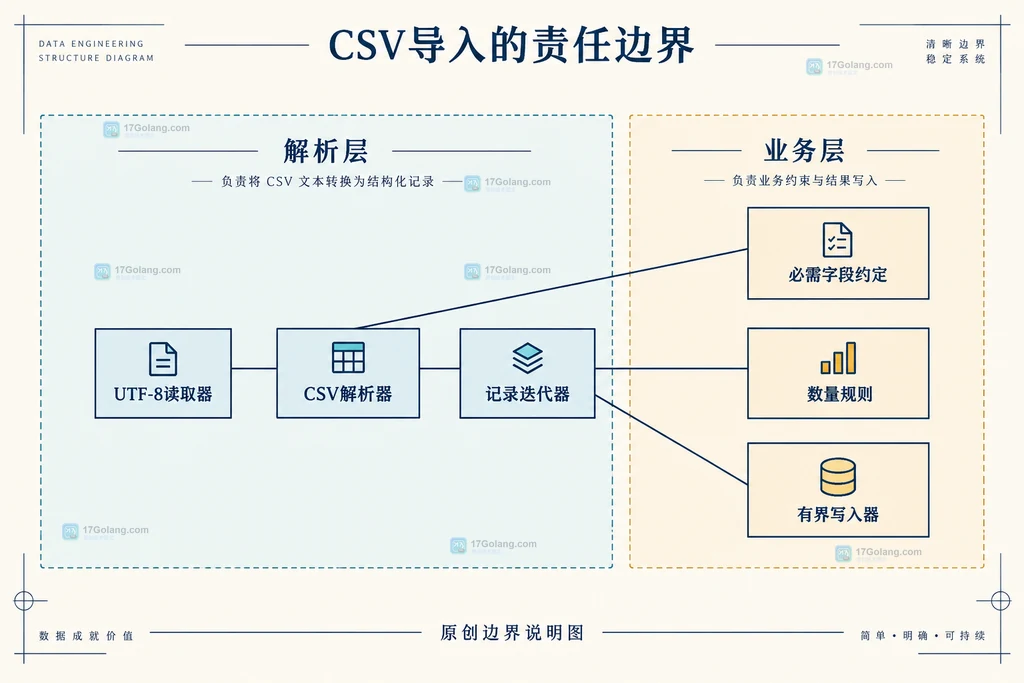
示例采用遇到错误即停止的策略,但“停止读取”不等于“此前写入自动回滚”。若 sink 已经提交部分结果,应由导入任务使用暂存表、批次状态或明确的事务边界,决定整批提交还是保留部分成功。工作器重试还需业务唯一键或导入批次键保证幂等;Commons CSV 不负责数据库事务或重复写入控制。
容易混淆的几个问题
isMapped 与 isSet 能判断字段为空吗?
不能。isMapped 判断名称是否在映射中;isSet 还涉及当前记录是否具有对应位置。字段实际是空字符串,仍可能满足这些条件。必填值、空白和数值范围需要单独判断。
重复表头会怎样?
本文明确使用 DISALLOW 拒绝重复名称,避免同名字段的访问歧义。不应把默认行为当成业务规则,也不要通过 toMap() 自动消除重复列后假设数据完整。
为什么带 BOM 的文件可能找不到第一列?
本文的 UTF-8 Reader 示例不移除 BOM。若来源可能产生 BOM,应在创建 Reader 前增加明确的 BOM 处理,例如使用 Commons IO 的 BOMInputStream;它是另一个库,不能仅添加 Commons CSV 依赖就假设已经处理。不要在业务字段查找失败后盲目替换列名。
记录号是不是文件行号?
不是可靠的一一对应关系。引号内字段可能跨物理行,错误定位应标为记录号;不要把 getRecordNumber() 直接称为文件行号。日志尽量记录任务标识和记录号,不输出整行客户数据。
部署前的输入与失败策略清单
- 固定依赖版本,确认当前使用的 Builder API 可用。
- 明确编码、BOM、分隔符、列名大小写和必需列。
- 拒绝重复表头;明确额外列、缺列和多列的处理政策。
- 限制文件大小、单字段规模及业务批次缓存;逐条迭代不等于绝对恒定内存。
- 将读取器关闭、写入失败、任务重试和事务提交分别设计。
可进一步参考官方 API:https://commons.apache.org/proper/commons-csv/apidocs/org/apache/commons/csv/CSVFormat.Builder.html、https://commons.apache.org/proper/commons-csv/apidocs/org/apache/commons/csv/CSVRecord.html、https://commons.apache.org/proper/commons-csv/apidocs/org/apache/commons/csv/CSVParser.html。结论是让文件表头建立名称映射,让业务约定判断数据是否可用,二者不能互相替代。
-
文章 · java教程 | 1个月前 | Java · 异常处理 · 资源管理 · java try-with-resources AutoCloseable close suppressed exception501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
370 收藏
-
文章 · java教程 | 1小时前 | 字符串 · Java · java stringutils defaultIfBlank defaultIfEmpty Apache Commons Lang201 收藏
-
165 收藏
-
274 收藏
-
205 收藏
-
497 收藏
-
285 收藏
-
383 收藏
-
298 收藏
-
415 收藏
-
304 收藏
-
190 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习