
AI 评测集怎样避免训练数据泄漏
来源:17golang原创
时间:2026-10-14 11:29:58 146浏览 收藏
AI 评测集最容易出现的误判,是把“测试分数高”直接等同于“模型泛化好”。我处理这类数据时,先不急着换指标,而是沿着样本来源反查:同一份文档、同一个用户、同一段会话或相邻时间窗口,是否被随机拆到了不同集合;归一化词表、检索索引和阈值,是否偷偷读过验证集或测试集;公开基准是否早已进入模型训练语料。真正稳妥的做法是先按来源实体分组,再划分 train、validation 和冻结 test,最后只用一次盲测得出报告。
官方地址:https://huggingface.co/docs/evaluate/
避免训练数据泄漏的关键不是迷信某个 8:1:1 比例,而是让“谁能看什么数据、什么时候能看”成为明确的数据边界。
- 先按用户、文档、会话、设备或时间窗口形成 source_group,再做 split。
- 词表、归一化参数、检索索引、采样规则和阈值只从训练集拟合。
- validation 可以反复反馈,test 必须冻结;测试结果一旦参与调参,就不再是盲测。
- 精确哈希只能抓完全重复,还要结合规范化文本、来源清单和公开基准污染审计。
先分清五种会抬高分数的泄漏
数据泄漏不是只有“把测试集复制进训练集”这一种。实际项目里,我会先把风险分成五类,因为每一类的修复位置不同。
| 风险 | 典型表现 | 优先修复 |
|---|---|---|
| 精确重复 | 同一条文本或同一问答对出现在多个 split | 规范化后做哈希去重 |
| 同源重复 | 同一文档的不同切片、同一用户的多轮会话被拆开 | 先按 source_group 分组 |
| 处理越界 | 全量数据一起拟合词表、均值、索引或阈值 | 只在 train 拟合并固化参数 |
| 反馈泄漏 | 反复看 test 分数后修改提示词、阈值或样本 | 把开发反馈移到 validation |
| 公开污染 | 基准题已广泛发布,模型可能在训练阶段见过原题 | 增加新题、私有题或低曝光题,并披露限制 |
Hugging Face 的评测说明把 train、validation、test 分别对应训练、超参数验证和最终评估,并提醒在同一 split 上训练和评估会误导结果。这个原则也解释了为什么只调用一次随机切分并不等于完成了数据治理。
先按来源实体分组,再做拆分
随机抽行最方便,却很容易把同一来源拆散。文本分类要关注原始文档、用户和会话;问答或指令数据要关注问题模板、答案来源和生成批次;时间敏感任务还要把未来窗口隔离出去。我的最低规则是:一个 source_group 只能落入一个 split,宁可牺牲一点样本量,也不要让模型在训练时看到测试对象的近邻。
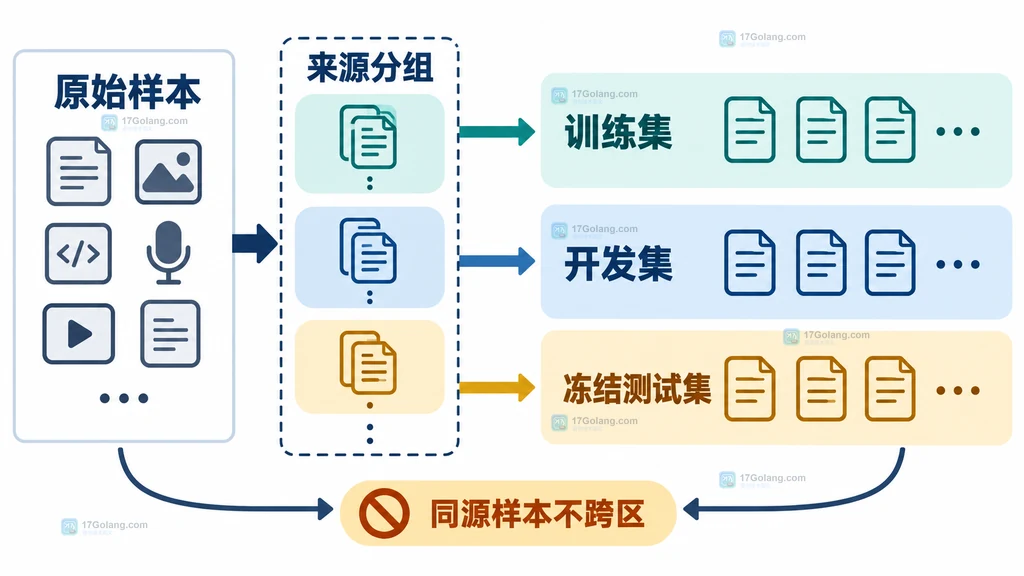
如果数据暂时没有来源字段,可以先补一列稳定的 source_group:文档用文档 ID,会话用会话 ID,用户数据用脱敏后的用户 ID,时间序列用业务实体加时间窗口。不要用随机行号代替来源标识,那只能让拆分看起来可复现,不能让来源真正隔离。
from datasets import Dataset

# 先按来源组切分,避免同一文档或会话跨越不同 split。
def group_split(rows, train_groups, validation_groups, test_groups):
    # 用集合表达已冻结的来源分配,便于在流水线中审计。
    assignments = {}
    for group in train_groups:
        assignments[group] = "train"
    for group in validation_groups:
        assignments[group] = "validation"
    for group in test_groups:
        assignments[group] = "test"

    splits = {"train": [], "validation": [], "test": []}
    for row in rows:
        split = assignments.get(row["source_group"])
        if split is None:
            # 未分配的来源不应悄悄进入训练集,先让数据负责人处理。
            raise ValueError(f"未分配来源组: {row['source_group']}")
        splits[split].append(row)
    return {name: Dataset.from_list(items) for name, items in splits.items()}
Hugging Face Datasets 的 train_test_split() 默认会打乱数据,适合没有来源分组要求的基础切分;一旦存在同源、时间或实体约束,就应该先生成分组,再把分组结果写入三个集合,而不是先随机抽行再补救。
只用训练集拟合预处理规则
第二个常见坑是“数据没重复,所以没泄漏”。例如你把全量文本一起统计词频、建立检索索引、选择最大长度、计算均值方差,测试集的信息已经参与了模型输入空间的设计。即使没有一条文本原样复制,评测仍然会被测试分布反向影响。
我会把数据处理拆成两种动作:fit 只读取 train,transform 可以作用于 train、validation 和 test。把这个边界写进代码接口,比靠口头约定更可靠。
from collections import Counter

class TrainOnlyVocabulary:
    def __init__(self, min_count=2):
        self.min_count = min_count
        self.token_to_id = {}

    def fit(self, train_texts):
        # 词表只从训练文本统计,不能把验证或测试文本传进来。
        counts = Counter(token for text in train_texts for token in text.split())
        self.token_to_id = {
            token: index + 1
            for index, (token, count) in enumerate(counts.items())
            if count >= self.min_count
        }
        return self

    def transform(self, texts):
        # 已冻结的词表可以转换其他 split,但不能在这里新增词。
        unknown_id = 0
        return [
            [self.token_to_id.get(token, unknown_id) for token in text.split()]
            for text in texts
        ]

vocabulary = TrainOnlyVocabulary(min_count=2).fit(train_texts)
train_ids = vocabulary.transform(train_texts)
validation_ids = vocabulary.transform(validation_texts)
test_ids = vocabulary.transform(test_texts)
同样的原则适用于归一化参数、标签映射、检索向量库、提示词模板、置信度阈值和样本权重。validation 可以用于选择这些参数的候选值,但最终参数一旦确定,就要冻结后再接触 test。
让 validation 承担开发反馈,冻结 test
实际开发不会只训练一次。我们会改模型、提示词、检索策略、阈值和数据清洗规则。每一次根据分数做选择,都是一次“看过评测反馈”。因此,能反复看的只能是 validation;test 需要像一次尚未拆封的验收包,直到方案已经锁定才打开。
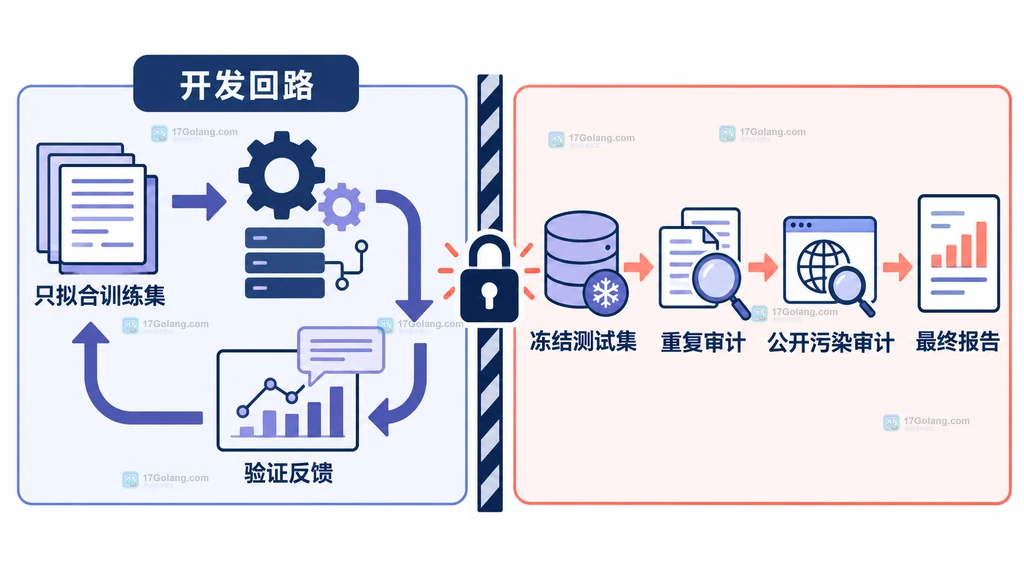
Hugging Face Evaluator 支持显式指定 split,所以发布评测脚本时不要省略它,让“究竟评了哪套数据”成为请求参数的一部分。报告中至少保存数据集版本、split 名称、样本数、指标、随机种子和模型版本。
from datasets import load_dataset
from evaluate import evaluator

# 最终评测显式指定冻结的 test,避免工具自动猜测 split。
data = load_dataset("org/project-eval", split="test")
task_evaluator = evaluator("text-classification")

result = task_evaluator.compute(
    model_or_pipeline="org/model-candidate",
    data=data,
    metric="accuracy",
    # 让标签映射固定,避免不同报告之间出现口径漂移。
    label_mapping={"NEGATIVE": 0, "POSITIVE": 1},
)
print(result)
如果 test 分数已经被看过很多次,最诚实的处理不是继续叫它“最终测试集”,而是把它降级为 validation,重新准备一份新的冻结集合。测试集的价值来自它没有参与决策,而不是来自文件名里写了 test。
用三层审计发现重复与公开污染
精确哈希是第一层:对统一 Unicode、空白和大小写后的文本计算哈希,抓完全相同的样本。第二层是近重复:同一文档改了标点、换了顺序或被切成相邻片段时,精确哈希可能失效,需要用 n-gram、编辑距离或向量近邻抽样复核。第三层是来源审计:记录数据的公开时间、采集时间、原始链接、生成模型和清洗版本,检查 test 是否来自已经公开并可能进入训练语料的题库。
NIST/CAISI 的近期模型评测报告在选择软件工程基准时,专门加入较少被广泛使用的任务,以降低模型曾经见过这些题目的概率。这不是保证零污染,而是提醒我们:公开度本身就是评测可信度的一个变量,必须在报告里披露。
import hashlib
import re
import unicodedata

def normalized_hash(text):
    # 统一 Unicode、大小写和空白,只用于发现明显重复,不替代近重复审计。
    normalized = unicodedata.normalize("NFKC", text).lower()
    normalized = re.sub(r"\s+", " ", normalized).strip()
    return hashlib.sha256(normalized.encode("utf-8")).hexdigest()

def find_cross_split_duplicates(split_to_texts):
    # 记录哈希出现过的 split,发现跨集合重复就返回样本摘要。
    locations = {}
    for split, texts in split_to_texts.items():
        for index, text in enumerate(texts):
            digest = normalized_hash(text)
            locations.setdefault(digest, []).append((split, index))
    return {
        digest: hits
        for digest, hits in locations.items()
        if len({split for split, _ in hits}) > 1
    }
审计结果不要只输出一个“通过/失败”。我更关心三张表:跨 split 的重复样本清单、同源组跨 split 清单、公开基准或训练语料重合的风险说明。每张表都要带数据版本和处理脚本版本,后续才能解释为什么一次分数变化不是模型能力变化。
一套可落地的评测数据架构
把前面的动作合起来,可以得到一条比较稳的链路:原始数据进入版本化仓库;先生成脱敏的 source_group;再做精确和近重复清理;按照来源组分配 train、validation 和 test;只用 train 拟合处理器;开发阶段反复训练并看 validation;方案锁定后只读取一次 test;最终报告附带数据血缘和污染限制。
| 阶段 | 可以读取 | 必须留下的记录 |
|---|---|---|
| 数据准备 | 原始数据、来源元数据 | 版本、来源、脱敏规则、去重规则 |
| 训练 | train、训练拟合出的处理器 | 模型版本、处理器指纹、训练配置 |
| 开发 | validation、候选模型和参数 | 每轮决策、指标、失败尝试 |
| 最终评测 | 冻结 test、已锁定模型 | 一次性结果、置信区间、限制说明 |
如果项目只有很少样本,可以采用交叉验证或重复采样,但“先分组、再评估”的边界仍然成立。NIST 的评测方法还提醒我们,固定 benchmark 上的分数并不自动代表更大题目总体上的表现,所以报告不要只给一个精确百分比,也要说明样本如何抽取、可能有哪些系统性偏差。
发布前的六项检查清单
- 每条样本是否都有稳定的来源组,且一个来源组只属于一个 split?
- 是否在规范化后检查过跨 split 的精确重复,并对近重复做抽样复核?
- 词表、统计量、索引、阈值和采样策略是否只从 train 或已允许的 validation 拟合?
- 开发者是否能在不读取 test 分数的情况下完成大多数模型和提示词决策?
- test 是否已冻结版本、权限和访问日志,最终评测是否明确指定 split?
- 报告是否披露来源、版本、公开污染可能性、抽样方式和不确定性?
我自己的判断标准很简单:如果有人问“这个样本从哪里来、谁在什么时候看过它、哪段代码处理过它”,团队能在几分钟内回答,评测集才算进入可维护状态。否则,分数再漂亮,也只能说明这套数据和这套流程彼此熟悉。
常见问题
训练集和测试集没有完全相同的文本,还会泄漏吗?
会。同一文档的切片、同一用户的相邻会话、同一模板的改写都可能让模型提前见到测试对象的结构,应该按来源实体或业务时间窗口分组。
可以先随机切分,再把重复样本删掉吗?
只能补救精确重复,不能可靠修复同源关系。更稳妥的顺序是先生成来源组并做审计,再按组切分。
测试集被看过一次就完全不能用了么?
如果看过结果并据此改了方案,它就不再是严格意义上的盲测,可以降级为 validation,并重新冻结一份新的最终测试集。
公开 benchmark 一定不能用吗?
不是。公开 benchmark 仍可用于可比性,但要披露它的公开程度、模型可能接触过的风险,并用较新的、低曝光或私有题集补充泛化评估。
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
354 收藏
-
371 收藏
-
386 收藏
-
448 收藏
-
203 收藏
-
140 收藏
-
328 收藏
-
365 收藏
-
197 收藏
-
278 收藏
-
395 收藏
-
492 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习