
前端怎样统计静态资源等待时间
来源:17golang原创
时间:2026-10-18 02:47:53 215浏览 收藏
页面里“某个静态资源很慢”通常不是一个单一数字:从开始抓取到收到首字节,反映的是请求等待;从首字节到最后一个字节,反映的是传输;如果还要把重定向算进去,则要看整条资源计时记录。前端可以用 PerformanceResourceTiming 配合 PerformanceObserver 直接统计这些时间,不需要改写 、 或
官方资料:https://developer.mozilla.org/en-US/docs/Web/API/PerformanceResourceTiming
最实用的做法是:页面尽早扩大 resource 缓冲区,再用一个 buffered 的 PerformanceObserver 读取历史和新增条目;用responseStart - requestStart表示首字节前等待,用responseEnd - fetchStart表示最终资源抓取时长,并把跨源字段为 0 单独标记为“计时信息不可见”,不要直接当成 0 毫秒。
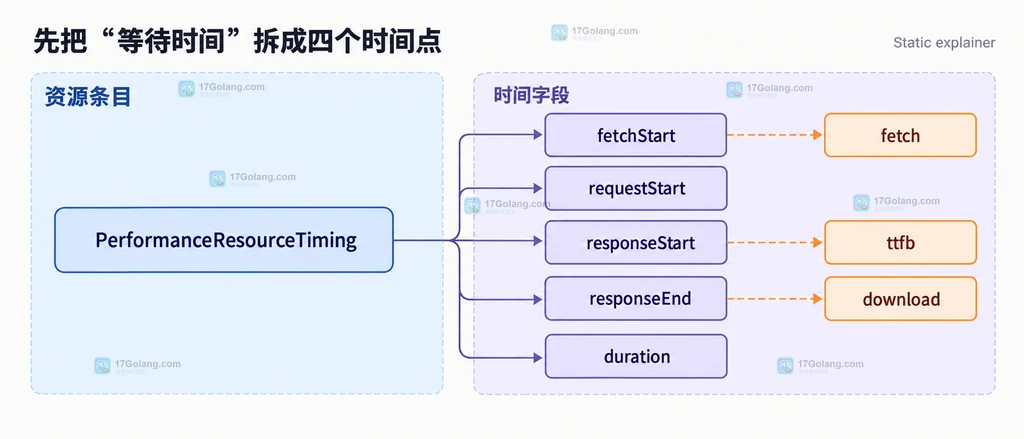
先把“等待时间”拆成四个时间点
一条静态资源记录的关键时间点可以先这样理解:
| 字段 | 含义 | 适合计算 |
|---|---|---|
fetchStart | 浏览器开始抓取最终资源的时间 | 与 responseEnd 相减,得到最终资源的抓取时长 |
requestStart | 浏览器开始发出资源请求的时间 | 与 responseStart 相减,观察首字节前等待 |
responseStart | 收到响应第一个字节的时间 | 判断服务端响应、网络等待是否偏长 |
responseEnd | 收到最后一个字节,或传输连接关闭前的时间 | 观察剩余内容下载耗时 |
因此,本文把“静态资源等待时间”定义成一个可拆分的数据集合,而不是强行只返回一个字段:
ttfb = responseStart - requestStart:首字节前等待。值为 0 时,要检查缓存、取消请求或跨源限制。download = responseEnd - responseStart:从首字节到最后字节的传输区间。fetch = responseEnd - fetchStart:不含重定向的最终资源抓取时长。duration:资源条目的整体持续时间;如果页面只关心完整计时链路,可以保留它作为总时长参考。
用 PerformanceObserver 接住已经产生的条目
如果只在页面加载完成后调用 performance.getEntriesByType('resource'),你能看到调用时已经存在的条目,但不容易持续接收后续加载的资源。更适合监控模块的方式是创建 PerformanceObserver,并设置 buffered: true,这样观察器创建前已经记录的资源也会进入回调。
// 先扩大资源计时缓冲区,避免长页面很快超过默认容量。
performance.setResourceTimingBufferSize(500);

const resourceObserver = new PerformanceObserver((list) => {
  for (const entry of list.getEntries()) {
    // 只保留常见静态资源,避免把所有资源都上报给业务接口。
    const staticTypes = new Set(["script", "link", "css", "img", "image", "font"]);
    if (!staticTypes.has(entry.initiatorType)) {
      continue;
    }

    const ttfb = entry.responseStart - entry.requestStart;
    const download = entry.responseEnd - entry.responseStart;
    const fetch = entry.responseEnd - entry.fetchStart;

    // 跨源资源可能因缺少 Timing-Allow-Origin 而返回 0,先标成不可见。
    const timingHidden = entry.requestStart === 0 || entry.responseStart === 0;
    const record = {
      name: entry.name,
      initiatorType: entry.initiatorType,
      ttfb: timingHidden ? null : Math.max(0, ttfb),
      download: timingHidden ? null : Math.max(0, download),
      fetch: timingHidden ? null : Math.max(0, fetch),
      duration: entry.duration,
      transferSize: entry.transferSize,
      timingHidden,
    };

    // 这里可以替换为采样上报;示例只输出结构,不代表真实运行结果。
    console.log("resource-timing", record);
  }
});

// buffered 让观察器同时接收创建前已经记录的 resource 条目。
resourceObserver.observe({ type: "resource", buffered: true });
这里没有把 console.log 的内容写死成某个数值,因为真正的耗时取决于浏览器缓存、网络、服务器和资源大小。实际接入时,可以把 record 交给采样器,并在上报前去掉完整查询参数,避免把用户数据带入监控。
把 URL、类型和大小整理成可行动数据
只有时间差还不够定位问题。name 可以帮助你定位资源,initiatorType 可以区分脚本、样式、图片和字体,transferSize、encodedBodySize 与 decodedBodySize 则可以帮助判断响应体和传输体量。建议先在浏览器内做轻量整理,再决定是否上报。
// 将资源条目整理成页面级汇总,适合在页面退出前做一次采样。
function summarizeResources(entries) {
  const summary = new Map();

  for (const entry of entries) {
    const type = entry.initiatorType || "unknown";
    const current = summary.get(type) || {
      count: 0,
      totalFetch: 0,
      totalTransfer: 0,
      hiddenTiming: 0,
    };

    current.count += 1;
    // duration 是条目自身的时间范围,不能替代跨源不可见字段的判断。
    current.totalFetch += entry.duration;
    current.totalTransfer += entry.transferSize;
    if (entry.requestStart === 0 || entry.responseStart === 0) {
      current.hiddenTiming += 1;
    }
    summary.set(type, current);
  }

  return [...summary.entries()].map(([initiatorType, value]) => ({
    initiatorType,
    ...value,
  }));
}

// 读取当前已存在的资源条目;观察器仍负责接收后续新增条目。
const currentResources = performance.getEntriesByType("resource");
const resourceSummary = summarizeResources(currentResources);
console.log("resource-summary", resourceSummary);
汇总时不要把不同类型简单相加后称为“页面加载时间”。脚本、字体和图片可能并行加载,类型汇总更适合回答“哪一类资源最慢、哪一类资源体积最大”,不能直接推导用户端的完整首屏体验。
处理缓冲区满和跨源字段为零
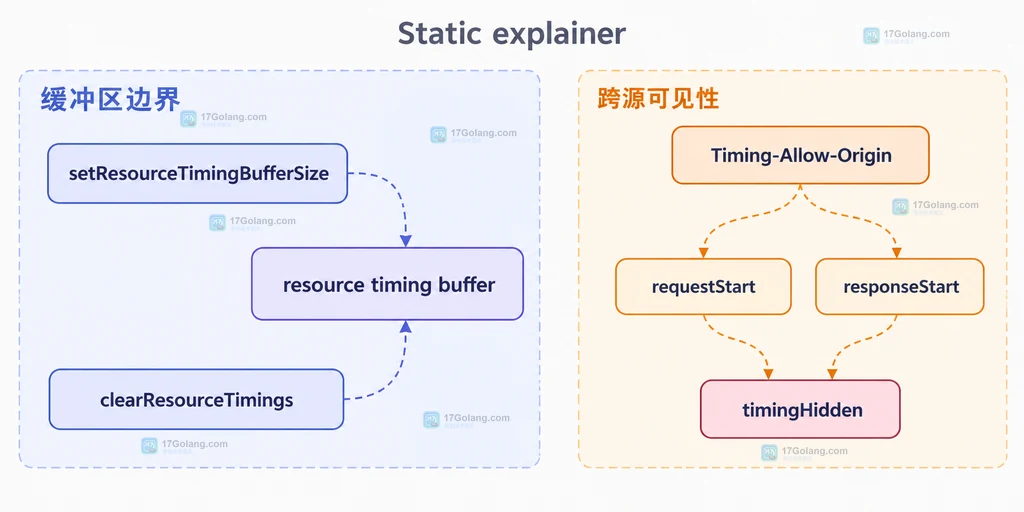
资源条目写入浏览器的 resource timing buffer。MDN 说明该缓冲区初始容量至少为 250;页面资源较多时,应该在尽早的位置调用 setResourceTimingBufferSize()。如果需要周期性采集,也要考虑采集后调用 clearResourceTimings(),否则旧条目会持续占用缓冲区。
// 缓冲区满时只做轻量通知;清理动作要与采样周期配合。
performance.addEventListener("resourcetimingbufferfull", () => {
  console.warn("resource timing buffer is full");
  // 清理会移除已有 resource 条目,清理前应先完成需要的汇总或上报。
  performance.clearResourceTimings();
});

// 让后续的页面资源拥有更大的记录空间。
performance.setResourceTimingBufferSize(1000);
另一个常见误判来自跨源资源。requestStart、responseStart 等字段在没有 Timing-Allow-Origin 时可能是 0;这表示页面看不到对应的计时细节,不代表服务器瞬间响应。若资源由你控制,可以让资源响应带上合适的 Timing-Allow-Origin;否则应保留 timingHidden 标志,不要把这些记录混进耗时平均值。
从页面采集到可复用的小项目结构
可以把上面的代码拆成三个职责:采集器只接收条目,归一化函数只计算字段,上报层再做采样和脱敏。这样后续切换到日志、性能平台或自建接口时,不需要重新理解浏览器计时字段。
- 在应用入口尽早设置缓冲区大小,并安装唯一的
PerformanceObserver。 - 在回调中先过滤
initiatorType,再计算ttfb、download和fetch。 - 把
requestStart或responseStart为 0 的条目标记为不可见,不参与跨源耗时平均。 - 上报时只保留资源主机、路径模板或哈希后的标识,避免把完整查询参数和业务数据带出页面。
- 采集周期结束后再清理资源条目,确保清理不会让同一批数据重复计入。
这个结构能回答“哪类静态资源等待长”“等待发生在首字节前还是下载阶段”“是不是跨源计时不可见”,但它不会自动回答“用户看到了什么”。如果要分析首屏或交互,还需要把资源计时和导航、绘制、长任务等指标放在同一套性能模型中。
常见问题
为什么 responseStart 是 0,但资源明明加载成功?
最常见原因是资源跨源且响应没有提供 Timing-Allow-Origin,也可能是缓存命中、请求被取消等情况。先结合 name、transferSize 和资源归属判断,不要直接把 0 当成 0 毫秒。
responseEnd - fetchStart 能代表用户等待时间吗?
它代表最终资源的抓取时长,不等同于资源从页面开始加载到用户真正看到内容的时间。渲染阻塞、解码、布局和主线程任务都可能发生在资源接收之后。
为什么观察器创建后还要设置 buffered?
页面早期资源可能在监控模块初始化前就已经完成。设置 buffered: true 可以让观察器读取已经记录的 resource 条目,再继续接收后续条目。
总结来说,静态资源等待统计的核心不是记住一个“总耗时”字段,而是稳定保存资源条目、明确时间差口径、区分缓冲区丢失和跨源不可见。先把数据边界做对,再谈平均值、分位数和告警阈值,结果才不会被几个 0 毫秒误导。
-
130 收藏
-
188 收藏
-
278 收藏
-
362 收藏
-
197 收藏
-
478 收藏
-
417 收藏
-
162 收藏
-
262 收藏
-
458 收藏
-
389 收藏
-
479 收藏
-
329 收藏
-
243 收藏
-
301 收藏
-
490 收藏
-
493 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习