
前端 PerformanceResourceTiming 怎样定位资源响应时间
来源:17golang原创
时间:2026-10-20 02:52:02 150浏览 收藏
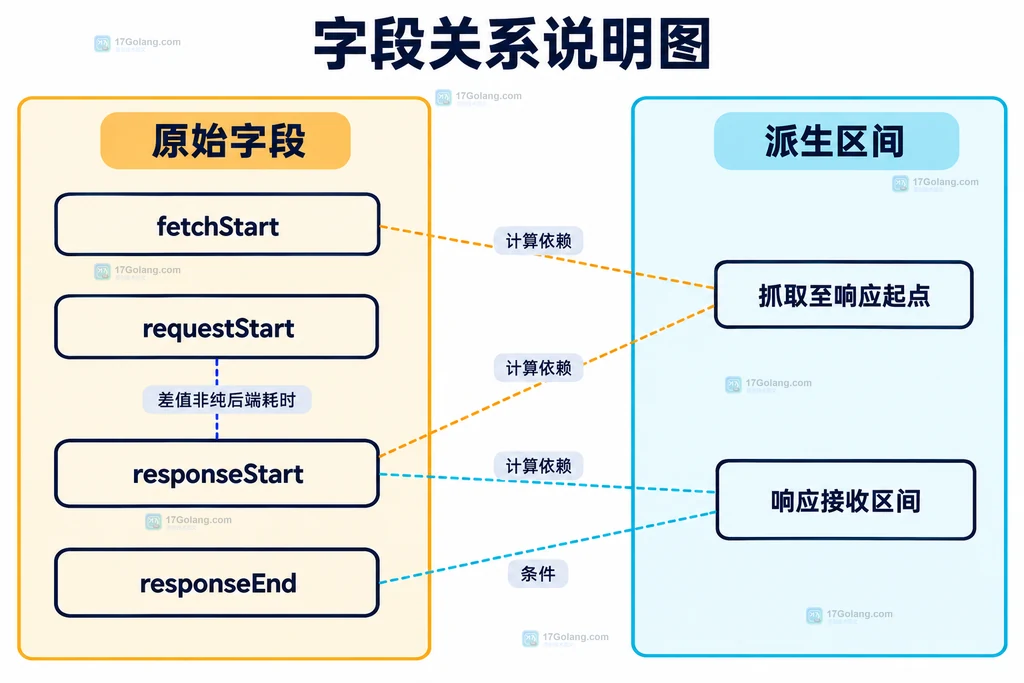
定位单个资源的响应时间,我会先找到对应的 PerformanceResourceTiming 条目,再计算区间:responseStart - fetchStart 表示从抓取起点到响应起点的间隔,responseEnd - responseStart 表示响应接收区间。responseStart 本身是时间戳,不是“服务器花了多少毫秒”;字段为零或不可见时,不能硬做差值。
面对“图片慢了,是不是接口慢”的问题,我更愿意先给采集结果加上可解释的名字,而不是立刻给后端定责。下面是一份有限采集方案和我的判断取舍,不包含生产经历、压测数字或已执行结果。规范地址:https://www.w3.org/TR/resource-timing/
我会先锁定资源而不是给后端定责
目标先缩小到一个真实资源 URL,例如商品页封面,而不是页面全部网络请求。name 用来识别资源,initiatorType 提供发起类型线索,startTime 帮助区分同名条目的不同加载记录。同一地址可能多次出现,也可能因复用已有加载而没有为每个元素生成独立记录,不能把条目数当点击数。
我的第一项取舍是保留原始字段,同时给派生指标明确命名。资源慢只能说明需要继续定位;DNS、连接、调度、缓存、Service Worker 和服务端都可能影响浏览器观察到的区间。本文只解释 Resource Timing 字段,不把客户端区间当作服务端追踪。
把时间戳换成有名字的区间
| 名称 | 计算 | 阅读限制 |
|---|---|---|
| 资源条目总耗时 | duration | 不是绘制或脚本执行耗时 |
| 抓取至响应起点 | responseStart - fetchStart | 并非纯服务端处理时间 |
| 请求至响应起点 | responseStart - requestStart | 仍包含网络及其他等待因素 |
| 响应接收区间 | responseEnd - responseStart | 不能直接当作链路带宽测速 |
这些字段通常以当前性能时间原点为基准、单位为毫秒,不是 Unix 时间。跨页面直接比较绝对值没有意义。responseStart 指浏览器收到来自服务器、缓存或本地资源的响应首字节附近的时点,不能只凭名字排除缓存来源;详见 responseStart 文档。
用有限采集保留原始字段
我会优先采用观察者收集已完成的 resource 条目,设置明确数量上限,再在页面模块卸载时断开。下面只精确匹配同源地址,不改缓存、不发测试请求、不清理全局缓冲区;请将占位路径改成业务资源。回调只输出诊断对象,没有自动上传服务。
// 仅观察指定同源资源,不发起额外请求、不修改资源缓冲区
function watchResource(path, onRecord, limit = 30) {
  const target = new URL(path, location.href);
  if (target.origin !== location.origin) throw new Error("示例只采集同源资源");
  if (!Number.isInteger(limit) || limit  100) {
    throw new RangeError("采集上限需为 1 到 100");
  }
  let observer = null;
  let stopped = false;
  let count = 0;

  function stop() {
    stopped = true;
    observer?.disconnect(); // 页面模块卸载或达到上限时释放观察者
  }
  function consume(entry) {
    if (stopped || entry.name !== target.href) return;
    const raw = {
      startTime: entry.startTime,
      fetchStart: entry.fetchStart,
      requestStart: entry.requestStart,
      responseStart: entry.responseStart,
      responseEnd: entry.responseEnd,
      duration: entry.duration,
      transferSize: entry.transferSize,
      encodedBodySize: entry.encodedBodySize,
      decodedBodySize: entry.decodedBodySize
    };
    // 零响应起点视为未知,不把受限字段计算成零耗时
    const visible = Number.isFinite(raw.responseStart) && raw.responseStart > 0;
    const span = (end, start) =>
      Number.isFinite(end) && Number.isFinite(start) && end >= start
        ? end - start : null;
    const record = {
      sample: ++count,
      initiatorType: entry.initiatorType,
      raw,
      fetchToResponseMs: visible ? span(raw.responseStart, raw.fetchStart) : null,
      requestToResponseMs: visible && raw.requestStart > 0
        ? span(raw.responseStart, raw.requestStart) : null,
      responseIntervalMs: visible ? span(raw.responseEnd, raw.responseStart) : null,
      responseVisibility: visible ? "available" : "unknown"
    };
    if (count >= limit) stop();
    onRecord(record); // 回调应保持轻量,不在这里逐条发网络上报
  }

  const supported = globalThis.PerformanceObserver?.supportedEntryTypes;
  if (supported?.includes("resource")) {
    observer = new PerformanceObserver(list => {
      list.getEntries().forEach(consume);
    });
    try {
      observer.observe({type: "resource", buffered: true});
    } catch (error) {
      observer.disconnect();
      observer = null;
      console.warn("实时观察不可用,改读现存条目", error.name);
      performance.getEntriesByType("resource").forEach(consume);
    }
  } else {
    // 降级只读当前已有条目,不冒充持续采集
    performance.getEntriesByType("resource").forEach(consume);
  }
  return stop;
}

// 修改为当前项目的真实资源地址;该地址只是示例占位
const stopResourceWatch = watchResource(
  "/assets/catalog-cover.webp",
  record => console.log("资源诊断", record)
);
// 页面模块卸载或结束诊断时调用 stopResourceWatch()
buffered 用于接收浏览器当前仍保留的既有条目,不保证找回所有历史记录。没有新日志时,先确认目标确实被加载、地址是否匹配、是否观察了正确文档,而不是直接认定请求未发生。降级分支仅获取调用时已有条目,覆盖范围比实时观察更小。
示例把未知区间记为 null,这一点对我比“每行都有漂亮数字”更重要。null 可以让下游排除不可解释的样本;填成 0 则会把缺失数据混进“极快”的分组。计时精度、缓存状态和浏览器差异也应跟随样本说明,不宜拿单次小数差异判断优化胜负。
遇到零值先处理可见性和缓存
跨域资源的细粒度字段可能受 Timing-Allow-Origin 限制。资源提供方需要按实际页面来源配置响应策略,不能仅在前端 fetch 参数里“解锁”;CORS 读取许可与计时字段可见性不是同一个问题。即使有相关响应头,也应按实际暴露字段判断,不把全部零值解释为成功授权。
transferSize 是字节量,不是耗时,不能与 responseStart 相减。它为 0 可能与本地缓存有关,也可能是跨域信息受限;只看这一项就贴上“缓存命中”标签,我认为风险太大。可结合 decodedBodySize、来源、响应策略及资源类型继续判断,参考 transferSize 文档。本例仍保留 encodedBodySize 和 decodedBodySize,但不输出自动缓存结论。
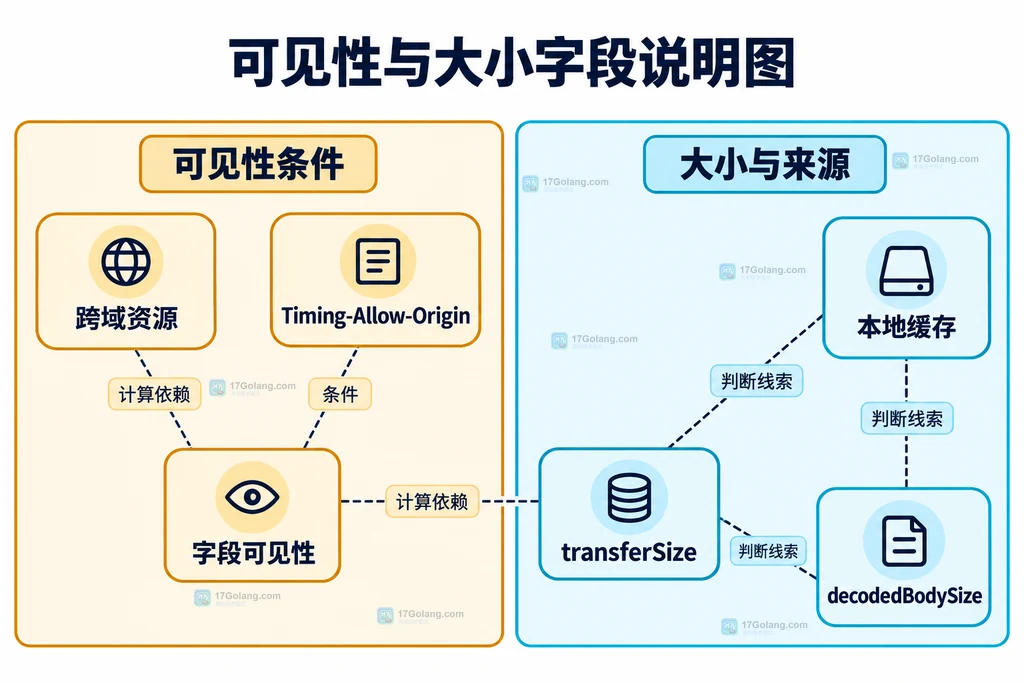
若有 Service Worker,客户端条目可能反映与它的交互,而非它内部所有网络活动。不要把这段间隔直接用来追责源站。相关跨域和 Service Worker 语义可查看 Resource Timing 规范,并结合目标浏览器实际支持情况使用。
让异常提示带着条件进入复盘
将采集接入自动诊断时,我会先分“字段可解释”和“字段未知”,再按资源类别、部署版本与缓存条件比较。阈值应来自自身基线,不在示例里编造通用告警线。超过阈值只触发调查,报告应保留区间名称、原始字段、样本量和缺失比例,不能直接写“后端超时”。
如果诊断造成日志噪声或回调开销,可以停用功能入口并调用 stopResourceWatch;这不会取消业务资源请求。扩展到线上上报时,只采用业务白名单资源标识,不记录 URL 中的令牌和用户参数,避免全量收集完整地址。
为什么没有找到资源条目?
可能是观察时机、缓冲区保留范围、地址匹配、所在文档或请求未进入时间线等原因。没有条目不等于加载耗时为零。
duration 很短,页面为什么仍然卡?
资源计时没有覆盖全部解析、执行、解码和渲染工作。本文的字段只能支持资源级问题定位,不能替代页面体验指标。
这套方案适合谁?
适合希望给单个资源建立可解释观测的前端开发者。若需要服务端精确处理时长或完整分布式因果链,就需要另外的服务端证据;我的结论是先把浏览器能说明和不能说明的部分分开,再谈优化。
-
502 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
284 收藏
-
432 收藏
-
432 收藏
-
464 收藏
-
379 收藏
-
295 收藏
-
182 收藏
-
204 收藏
-
114 收藏
-
306 收藏
-
184 收藏
-
404 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习