
MySQL 8.4 生成列索引优化怎样判断是否命中
来源:17golang原创
时间:2026-10-23 06:07:40 127浏览 收藏
我最近排查一条 JSON 条件查询时,发现表上明明有生成列索引,EXPLAIN 却没有把它放进实际执行计划。这个问题通常不是“索引完全失效”,而是查询表达式没有和生成列定义精确匹配。
MySQL 8.4 的判断方法很直接:先看 EXPLAIN 的 possible_keys 和 key,再用 SHOW WARNINGS 查看优化器是否把原表达式改写成生成列。官方资料入口:
官方地址:https://dev.mysql.com/doc/refman/8.4/en/generated-column-index-optimizations.html
看到索引名出现在possible_keys只能说明它有机会被使用;只有key真的选中该索引,才算当前计划命中。若两列都为空,优先检查表达式是否逐字等价、结果类型是否一致,以及比较运算符是否在支持范围内。
先把生成列表达式固定下来
先用一个最小表表达订单金额筛选场景。这里把 amount + 1 保存为生成列,并为生成列建立索引。实际项目中也可以选择 VIRTUAL,但需要确认存储引擎和索引方案;STORED 会保存计算值,同时索引也会占用空间。
-- 生成列保存稳定表达式,并为它创建索引
CREATE TABLE orders (
    id BIGINT PRIMARY KEY,
    amount DECIMAL(12, 2) NOT NULL,
    amount_plus_one DECIMAL(12, 2)
        GENERATED ALWAYS AS (amount + 1) STORED,
    INDEX idx_amount_plus_one (amount_plus_one)
);

-- 让查询表达式与生成列定义保持同一计算形式
EXPLAIN SELECT id, amount
FROM orders
WHERE amount + 1 > 100;
不要先把生成列写成一个表达式、再在查询里随意改写。官方规则要求表达式本身相同,并且结果类型也要相同;例如 amount + 1 与 1 + amount 不应当当成完全等价的匹配写法。
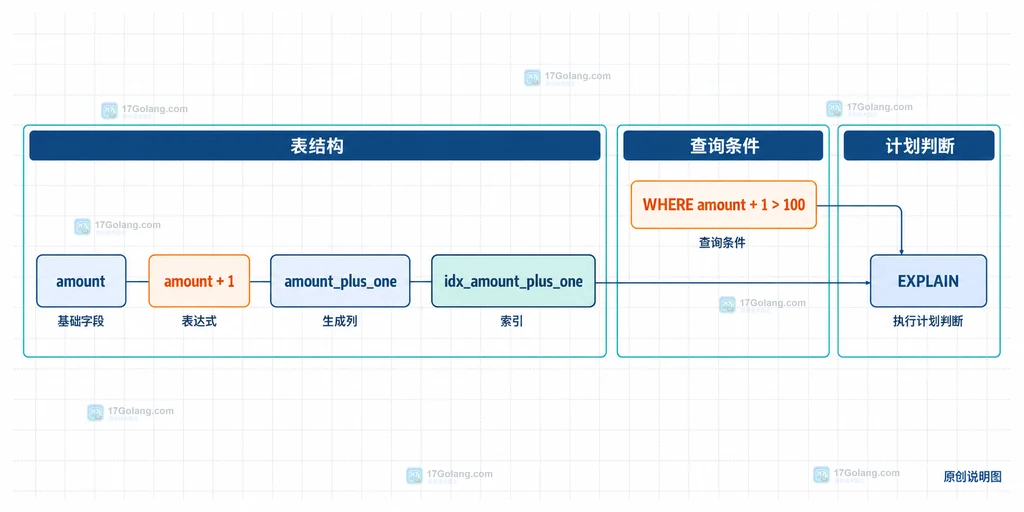
EXPLAIN 要同时看 possible_keys 和 key
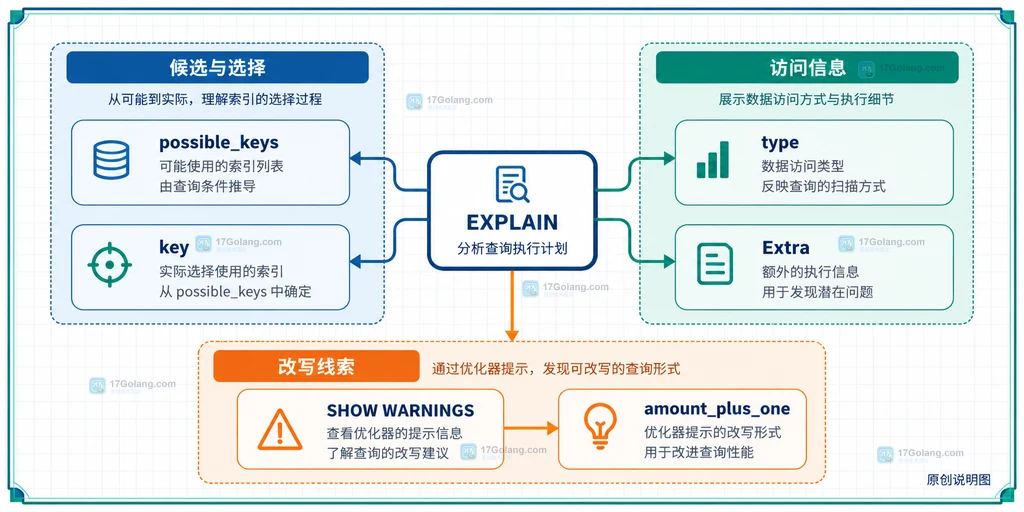
我判断是否命中时不会只看一列。possible_keys 表示优化器认为可能有用的索引,key 表示当前计划实际选择的索引。下面是阅读重点:
| 字段 | 含义 | 判断 |
|---|---|---|
possible_keys | 候选索引 | 出现索引名,说明表达式至少进入候选范围 |
key | 实际使用的索引 | 等于生成列索引名,才是当前计划选中 |
type | 访问方式 | 结合 range、ref 等判断访问形态 |
Extra | 附加信息 | 关注是否出现索引条件下推等信息,但不要只凭它下结论 |
-- 先观察候选索引与实际索引,不要只看 rows
EXPLAIN SELECT id, amount
FROM orders
WHERE amount + 1 > 100;

-- 扩展信息可以帮助判断优化器如何理解这条条件
SHOW WARNINGS;
如果结果类似 possible_keys: idx_amount_plus_one、key: idx_amount_plus_one,说明索引既可用又被当前计划采用。若只有 possible_keys 有值,代表索引是候选项,但成本模型选择了别的路径;若两者都为空,则应先回到表达式匹配问题。
SHOW WARNINGS 能揭示有没有改写
MySQL 8.4 在识别到匹配的生成列索引时,可能把查询中的表达式理解为对生成列的引用。执行 EXPLAIN 后紧接着执行 SHOW WARNINGS,可以看到扩展的改写说明。
-- EXPLAIN 之后立刻查看优化器给出的扩展说明
EXPLAIN SELECT id
FROM orders
WHERE amount + 1 > 100;

-- 注意:SHOW WARNINGS 读取的是上一条语句的扩展信息
SHOW WARNINGS;
阅读时重点确认条件是否出现了生成列名,例如 amount_plus_one > 100。这比只看一段估算行数更容易解释“为什么选中”或“为什么没有识别”。不过执行计划仍然受数据分布、成本估算和其他索引影响,所以“识别到生成列”与“最终选择该索引”是两个不同问题。
这四类差异最容易让索引不命中
1. 运算顺序不同
生成列定义为 amount + 1 时,查询最好也写成 amount + 1。不要把 1 + amount 当成可以自动归一化的同一表达式。
2. 比较值改变了结果类型
表达式匹配除了结构相同,还要求结果类型一致。数字表达式不要在关键比较处混入字符串字面量;出现类型转换时,先检查生成列的数据类型和查询参数绑定类型。
3. 运算符不在优化范围
文档列出的常见支持运算符包括 =、、、>、>=、BETWEEN 和 IN()。其中 BETWEEN、IN() 对可替换的位置还有额外限制,不能只凭普通比较的经验推断。
4. JSON 字符串没有去掉引号
如果生成列从 JSON 中提取字符串,定义中通常需要使用 JSON_UNQUOTE(JSON_EXTRACT(...)),否则索引查找的字符串值可能无法按预期匹配。示例写法如下:
-- JSON 字符串索引需要明确去掉 JSON 字符串引号
CREATE TABLE user_docs (
    id BIGINT PRIMARY KEY,
    jdoc JSON NOT NULL,
    doc_name VARCHAR(100)
        GENERATED ALWAYS AS (
            JSON_UNQUOTE(JSON_EXTRACT(jdoc, '$.name'))
        ) STORED,
    INDEX idx_doc_name (doc_name)
);

-- 查询中的表达式要与生成列保持同一语义
EXPLAIN SELECT id
FROM user_docs
WHERE JSON_UNQUOTE(JSON_EXTRACT(jdoc, '$.name')) = 'Alice';
最后用一张表做判断
| 现象 | 先看什么 | 处理方向 |
|---|---|---|
possible_keys 和 key 都为空 | 表达式、结果类型、生成列定义 | 统一表达式与比较类型 |
只有 possible_keys 有值 | 数据分布和成本选择 | 结合其他索引与实际查询计划判断,不要误称“未识别” |
key 是生成列索引 | SHOW WARNINGS | 确认改写信息,并记录计划变化 |
| JSON 条件没有命中 | JSON_UNQUOTE 与返回类型 | 让生成列和查询都使用一致的字符串语义 |
我自己的排查顺序是“先看结构,再看候选,再看实际选择,最后看改写”。这样能把“索引没建好”“表达式没匹配”和“索引可用但成本不划算”分开处理。生成列索引并不是只要存在就会生效,真正可靠的判断必须落到当前查询的执行计划上。
相关问题
生成列一定要使用 STORED 吗?
不一定。MySQL 允许虚拟生成列和存储生成列,但是否可索引、占用多少空间以及读写成本要结合存储引擎和实际场景决定。本文重点是优化器识别表达式索引的条件。
为什么 key 有索引名但查询仍然慢?
命中只说明计划选择了这个索引,不等于所有查询都足够快。还要结合扫描范围、返回行数、回表成本、数据分布和其他过滤条件判断。
-
374 收藏
-
499 收藏
-
384 收藏
-
184 收藏
-
265 收藏
-
306 收藏
-
361 收藏
-
321 收藏
-
374 收藏
-
218 收藏
-
400 收藏
-
399 收藏
-
161 收藏
-
219 收藏
-
316 收藏
-
461 收藏
-
329 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习