
Linux cgroup v2 怎样读取进程 CPU 使用量
来源:17golang原创
时间:2026-10-23 09:01:32 250浏览 收藏
如果你已经拿到一个 Linux 进程 PID,最稳妥的 cgroup v2 读法不是猜服务目录,而是先读取 /proc/,再把其中的相对路径拼到 cgroup2 挂载点,最后读取目标目录里的 cpu.stat。其中 usage_usec 是累计 CPU 时间,单位是微秒;它统计的是该 cgroup 以及后代 cgroup 中的进程,不天然等于某一个 PID 的独占时间。
一句话结论:cgroup v2 适合回答“这个进程所在资源组用了多少 CPU”;如果要回答“单个进程用了多少 CPU”,应让它独占一个 cgroup,或改读进程级接口。
先确认 cpu.stat 统计的对象
cgroup v2 使用统一层级,每个进程都属于一个 cgroup。内核文档说明,/proc/PID/cgroup 中的 v2 行格式是 0::/相对路径;目标 cgroup 目录下的 cpu.stat 无论 CPU controller 是否启用都会存在。
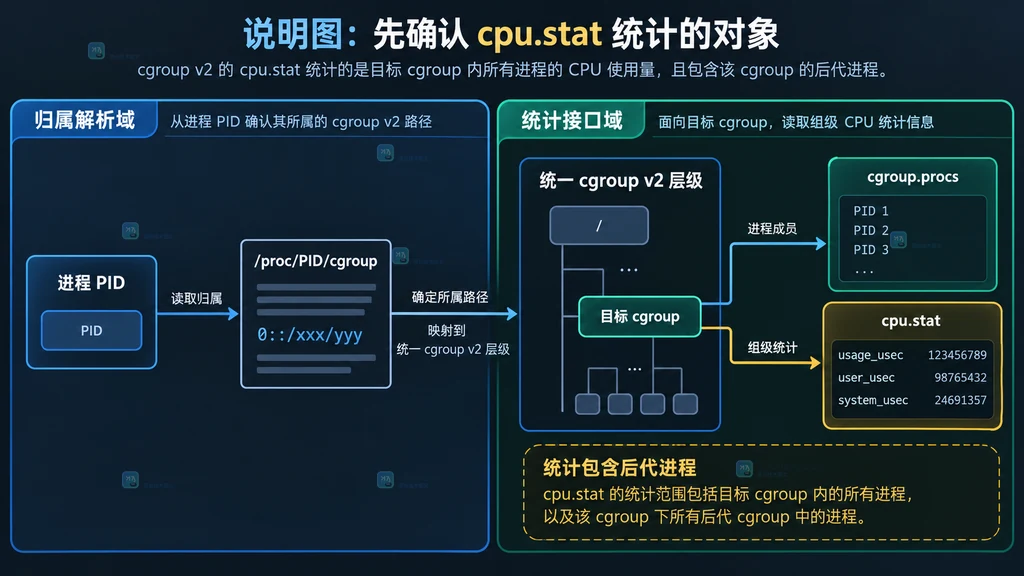
cpu.stat 始终提供 usage_usec、user_usec、system_usec 三项,三者都会包含该 cgroup 后代中的进程。启用 CPU controller 后,还可能看到周期和限流相关字段,例如 nr_periods、nr_throttled 与 throttled_usec;这些 CFS 带宽统计只反映本 cgroup 自己的带宽限制,不包含祖先 cgroup 造成的限流。
根据 PID 读取累计 CPU 时间
下面的脚本只做文件读取和路径拼接,不代表在本文写作环境中执行。它兼容 v2 的统一层级写法,并在找不到 v2 行时直接报错,避免把 v1 路径误当成 v2 路径。
#!/usr/bin/env bash
set -eu

# 传入目标 PID;实际使用时替换成需要观察的进程号。
pid="${1:?请传入 PID,例如 1234}"
cgroup_root="${CGROUP_ROOT:-/sys/fs/cgroup}"

# v2 的 cgroup 行固定以 0:: 开头,第三列是相对路径。
relative_path="$(awk -F: '$1 == "0" { print $3; exit }' "/proc/$pid/cgroup")"
if [ -z "$relative_path" ]; then
  echo "未找到 cgroup v2 归属:$pid" >&2
  exit 1
fi

# 根 cgroup 的相对路径是 /,拼接时要避免出现双斜杠影响可读性。
if [ "$relative_path" = "/" ]; then
  cgroup_dir="$cgroup_root"
else
  cgroup_dir="$cgroup_root$relative_path"
fi

# cpu.stat 是键值文本;同时查看进程列表,确认统计范围并非单个 PID。
echo "cgroup: $cgroup_dir"
cat "$cgroup_dir/cgroup.procs"
cat "$cgroup_dir/cpu.stat"
输出中的 usage_usec 是从该 cgroup 开始统计以来的累计值,不能直接当作“当前百分比”。user_usec 和 system_usec 可帮助区分用户态与内核态 CPU 时间,但三者不是三个互不重叠的总量。
用两次采样估算 CPU 使用率
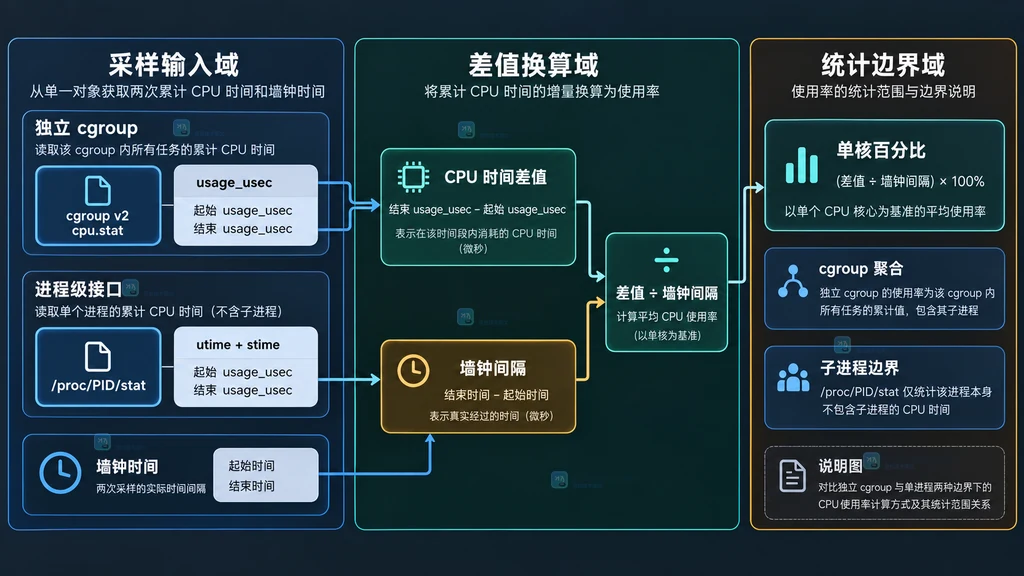
要得到一段时间内的占用率,需要记录两个时刻的 usage_usec,再用 CPU 时间差除以墙钟时间差。下面的示例按一秒采样,结果是以单个 CPU 为 100% 的比例;如果组内有多个并行进程,结果可能超过 100%。
#!/usr/bin/env bash
set -eu

# 复用前一个脚本的思路,先把 PID 映射到目标 cgroup 目录。
pid="${1:?请传入 PID}"
cgroup_root="${CGROUP_ROOT:-/sys/fs/cgroup}"
relative_path="$(awk -F: '$1 == "0" { print $3; exit }' "/proc/$pid/cgroup")"
[ -n "$relative_path" ] || { echo "没有 cgroup v2 路径" >&2; exit 1; }
[ "$relative_path" = "/" ] && cgroup_dir="$cgroup_root" || cgroup_dir="$cgroup_root$relative_path"

# 只取 usage_usec;未找到键时返回错误,避免把空值参与计算。
read_usage() {
  awk '$1 == "usage_usec" { print $2; found = 1 } END { if (!found) exit 1 }' "$cgroup_dir/cpu.stat"
}

# 记录两次累计值;sleep 期间不假设进程一定持续运行。
start_usage="$(read_usage)"
start_ns="$(date +%s%N)"
sleep 1
end_usage="$(read_usage)"
end_ns="$(date +%s%N)"

# 微秒差除以墙钟微秒差,再乘 100 得到单核视角的百分比。
awk -v du="$((end_usage - start_usage))" \
    -v dw="$(((end_ns - start_ns) / 1000))" \
    'BEGIN { if (dw
这段计算只能说明采样窗口内该 cgroup 的累计 CPU 活动。它不修正进程在采样窗口中退出、子 cgroup 增删或父级限流等变化;生产监控通常还会同时记录 cgroup 路径、进程生命周期和采样间隔。
组级统计和单进程统计怎样区分
最常见的误读是把 PID 当成统计粒度。PID 只是定位入口,cpu.stat 的统计粒度仍然是 cgroup。若目标服务与多个 worker 共用同一个 cgroup,读取到的 usage_usec 会把它们合在一起;如果目标 cgroup下面还有子 cgroup,后代进程也会被纳入。
需要单独观察一个进程时,优先在服务启动阶段把它放进一个只承载该进程的叶子 cgroup,再读取该组的 cpu.stat。如果无法改变 cgroup 拓扑,就使用 /proc/PID/stat 等进程级接口,并自行处理 PID 回收和字段解析。两种数据不能直接混为一个指标:前者适合资源组监控,后者适合单进程诊断。
四个容易踩坑的判断
- 找不到 cpu.stat:先确认拼出的目录确实位于 cgroup v2 挂载点;不要只凭服务名猜路径。
- usage_usec 不增长:可能是采样窗口内没有 CPU 活动,也可能 PID 已退出;先查看
cgroup.procs和cgroup.events的 populated 状态。 - 限流字段为空:基础三项始终存在,CFS 带宽字段需要 CPU controller 对该层级生效;不要把字段缺失当成 CPU 时间为零。
- 百分比超过 100%:这通常表示多个 CPU 并行消耗,或组内同时运行多个进程;百分比基准应在监控说明中写清楚。
总结:先问清楚你要测哪一个边界
读取 Linux cgroup v2 CPU 使用量可以归纳为三件事:从 /proc/PID/cgroup 找到统一层级下的相对路径,读取目标目录的 cpu.stat,再用两次 usage_usec 差值换算采样窗口内的组级占用。要做单进程监控,就让进程拥有独立 cgroup,或者改用进程级统计接口。把统计边界写进指标名称,往往比单纯增加采样频率更能避免误判。
相关问题
cpu.stat 的时间单位是什么? CPU 接口文档规定时间长度使用微秒,usage_usec 等字段应先转成统一单位再计算。
为什么 cpu.stat.local 读到的 throttled_usec 不一样? cpu.stat 的值关注本 cgroup 自己的 CFS 带宽限制,cpu.stat.local 反映本地运行队列实际遭遇的限流,可能包含祖先 cgroup 带来的影响。
cgroup v2 能直接按 PID 过滤 cpu.stat 吗? 不能。PID 用来定位归属,统计仍按 cgroup 聚合;想隔离单进程需要改变分组或读取进程级接口。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
240 收藏
-
387 收藏
-
179 收藏
-
284 收藏
-
336 收藏
-
384 收藏
-
490 收藏
-
126 收藏
-
201 收藏
-
128 收藏
-
420 收藏
-
189 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习