
MySQL histogram 怎样辅助没有合适索引的列估算
来源:17golang原创
时间:2026-10-26 01:23:47 386浏览 收藏
当一张订单表的 status 列没有合适的单列索引时,MySQL 仍然需要估算“这个条件大概会命中多少行”。这时可以用 histogram 保存列值分布,让优化器在选择连接顺序、过滤方式和扫描计划时少一些盲猜。
官方资料:https://dev.mysql.com/doc/refman/8.4/en/optimizer-statistics.html
- histogram 是列值分布统计,不是索引;它改善的是基数估算,不能直接让全表扫描变成索引查找。
- 对没有合适索引的列,可以用
ANALYZE TABLE ... UPDATE HISTOGRAM建立统计,再从INFORMATION_SCHEMA.COLUMN_STATISTICS查看。 - 最终要用
EXPLAIN对照rows、过滤条件和访问路径;统计过期、采样过低或条件不适用时,估算仍可能失真。
histogram 解决的是“估算错”,不是“增加索引”
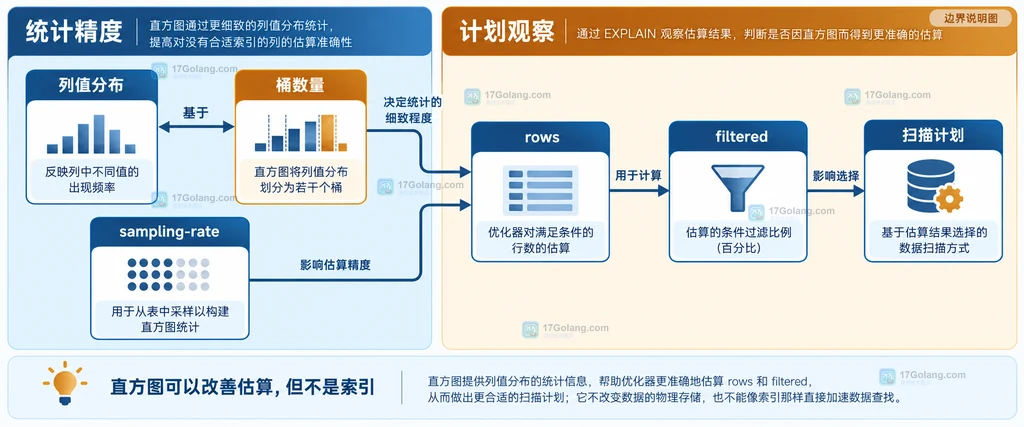
先把职责分开。索引提供一条可访问的数据结构,histogram 则记录某个列的值分布。没有合适索引时,优化器仍可能选择扫描,但它可以借助分布统计估算过滤后的行数,从而更合理地比较扫描、连接顺序和后续过滤成本。
MySQL 官方文档明确把 histogram 主要定位在非索引列上;对于已经有索引的列,优化器可能通过 index dive 或 range optimizer 得到更直接的估算,histogram 不一定更有用。因此,不能把“建立 histogram”写成“给列补上了索引”,也不能只看到统计信息存在就断言查询一定变快。
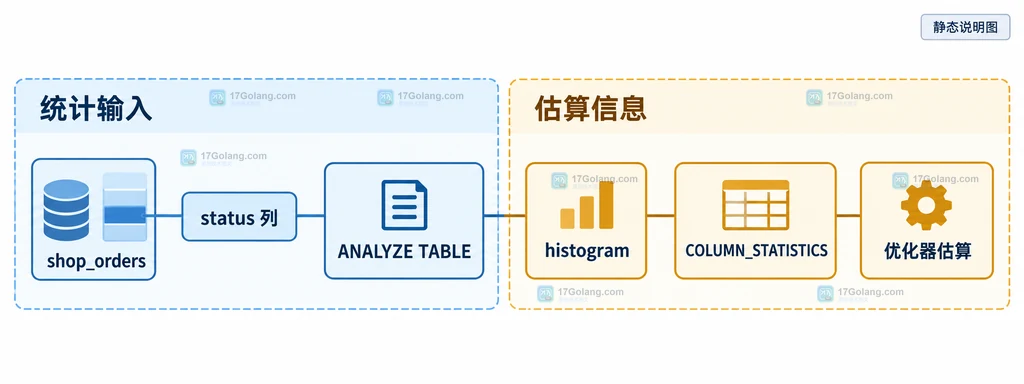
下面把订单表的 status 当作示例列。假设业务查询经常筛选它,但当前没有合适的单列索引;这篇只观察估算信息,不把示例输出描述成已经在某台机器上实测的结果。
用 ANALYZE TABLE 建立并查看 histogram
先为目标列生成一个有限数量的桶。桶数量不是越大越好:它需要在分布表达能力和统计维护成本之间取平衡。MySQL 8.4 中 N 的范围是 1 到 1024,省略时默认使用 100。
-- 为没有合适单列索引的状态列建立持久化分布统计。
ANALYZE TABLE shop_orders
  UPDATE HISTOGRAM ON status WITH 32 BUCKETS;

-- 查看统计类型、桶数量和采样率,判断统计是否真的存在。
SELECT SCHEMA_NAME,
       TABLE_NAME,
       COLUMN_NAME,
       HISTOGRAM->>'$."histogram-type"' AS histogram_type,
       HISTOGRAM->>'$."number-of-buckets-specified"' AS bucket_count,
       HISTOGRAM->>'$."sampling-rate"' AS sampling_rate
FROM INFORMATION_SCHEMA.COLUMN_STATISTICS
WHERE TABLE_NAME = 'shop_orders'
  AND COLUMN_NAME = 'status';
COLUMN_STATISTICS 暴露的是一个 JSON 形式的 histogram。这里的查询只做观察,不要求先把完整 JSON 复制出来;重点是确认列名、类型、桶数量和采样率是否与当前维护动作相符。
用 EXPLAIN 判断估算有没有被改善
建立 histogram 后,应该回到实际查询的执行计划。示例查询只用于展示观察入口:
-- 用执行计划观察过滤行数估算,不把示例输出当作实测结论。
EXPLAIN SELECT id, created_at, total_amount
FROM shop_orders
WHERE status = 'PAID'
  AND created_at >= '2026-01-01';
重点看三件事:第一,访问路径是否仍然是预期的表扫描或其他路径;第二,rows 是否反映了 status = 'PAID' 的实际分布,而不是把每个状态都当成差不多;第三,filtered 与其他条件叠加后,估算是否出现明显偏差。没有合适索引时,histogram 不能消除扫描本身,但更可信的行数会影响优化器对连接顺序和中间结果规模的判断。
| 观察项 | 能说明什么 | 不能说明什么 |
|---|---|---|
rows | 优化器预计检查的行数范围 | 不是实际返回行数,也不是耗时 |
| 访问类型与键列 | 计划选择了哪种访问路径 | 不能单独证明 histogram 造成了变化 |
filtered | 剩余条件的估算过滤比例 | 不是业务数据的精确统计报表 |
如果前后计划差异很小,也不代表 histogram 无效:可能是当前条件本身已经容易估算,或者 range optimizer 已经优先处理了这个条件。更稳妥的做法是保存建立统计前后的 EXPLAIN 结果,再结合真实数据分布和查询目标判断。
采样、自动更新和删除都要有边界
histogram 不是永久正确的快照。数据持续变化后,列值分布会逐渐偏离上次统计;如果生成时受 histogram_generation_max_mem_size 限制而采用采样,还要关注 sampling-rate。采样率较低时,稀有值和突变分布可能更容易被估算遗漏。
-- 让后续 ANALYZE TABLE 或 InnoDB 持久化统计重算时更新该 histogram。
ANALYZE TABLE shop_orders
  UPDATE HISTOGRAM ON status WITH 32 BUCKETS AUTO UPDATE;

-- 业务不再需要这份列统计时,显式删除它。
ANALYZE TABLE shop_orders
  DROP HISTOGRAM ON status;
AUTO UPDATE 是 MySQL 8.4 提供的管理方式;没有指定时默认是 MANUAL UPDATE。另外,histogram 不能用于所有列:官方文档列出了 JSON、空间类型、临时表和单列唯一索引等限制。对数据变化快的状态列,更新时机要和发布、归档或批量导入节奏一起设计。
常见问题
没有索引时建立 histogram,会不会让查询直接走索引?
不会。histogram 只提供列值分布统计,不创建 B-Tree 或其他访问结构;它可能改善优化器的行数估算,但最终仍可能选择扫描。
桶数量设置得越大,估算就一定越准吗?
不一定。桶更多可以表达更细的分布,但也会增加统计维护成本;应结合数据规模、分布变化和 EXPLAIN 的估算偏差调整。
为什么 COLUMN_STATISTICS 有记录,计划却没有明显变化?
优化器可能已经有更适合的 range 估算,或者当前条件不属于 histogram 的有效使用场景。记录存在只证明统计已保存,不证明每条查询都会采用它。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
159 收藏
-
181 收藏
-
185 收藏
-
342 收藏
-
232 收藏
-
347 收藏
-
347 收藏
-
数据库 · MySQL | 1小时前 | MySQL · JSON · 数据库 · 查询优化 · mysql 索引 explain JSON json_extract 生成列 JSON_VALUE JSON_UNQUOTE475 收藏
-
443 收藏
-
372 收藏
-
188 收藏
-
165 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习