
Java HttpResponse.BodyHandlers 怎样流式消费响应
来源:17golang原创
时间:2026-10-26 23:45:58 220浏览 收藏
处理下载、导出或大 JSON 响应时,HttpResponse.BodyHandlers.ofInputStream() 的关键价值是:响应头读取完成后就能拿到 HttpResponse,正文随后从流中逐块到达,不必先把完整响应装进内存。实际使用时要把读取放进 try-with-resources,持续读到 EOF;如果业务提前停止,也必须显式关闭流。
官方文档:https://docs.oracle.com/en/java/javase/25/docs/api/java.net.http/java/net/http/HttpResponse.BodyHandlers.html
ofInputStream()返回的是延迟消费的InputStream,不是已经读完的字节数组。- 循环读到
-1才表示正常结束;提前退出要关闭流。 - 它解决的是响应体的消费方式,不会替你判断 HTTP 状态码,也不会自动限速或解析 JSON。
BodyHandlers.ofInputStream 的返回时机
BodyHandler 决定响应体如何转换成泛型 T。选择 ofInputStream() 后,客户端在拿到响应状态和响应头时就可以返回 HttpResponse,但响应体可能仍在网络传输。真正的内容消费发生在 response.body() 返回的输入流上。
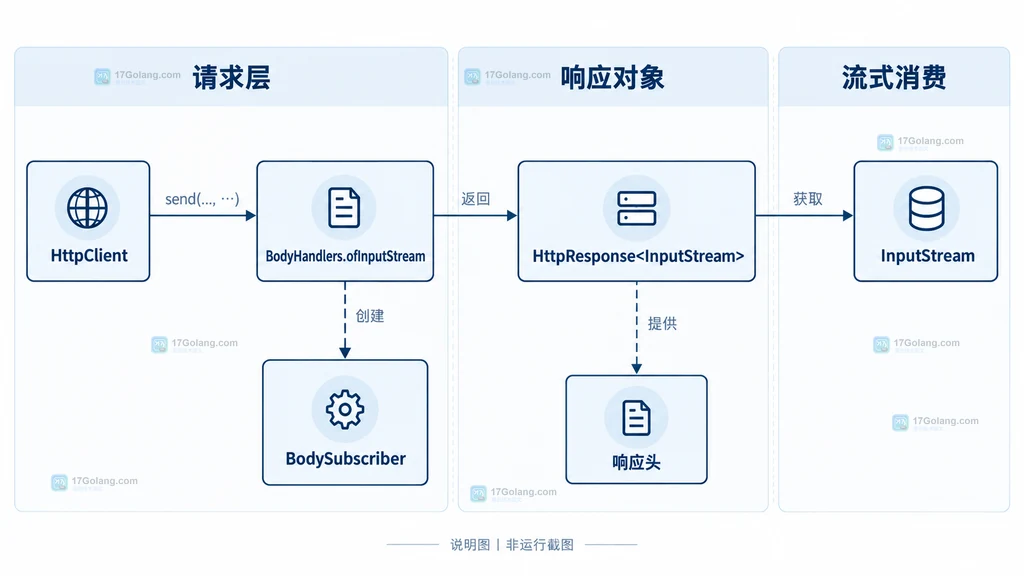
这和 ofString() 的体验不同:后者适合体量可控且需要直接拿文本的响应;流式处理则把读取时机交给调用方,更适合文件、压缩包或持续增长的响应。
用固定缓冲区消费响应体
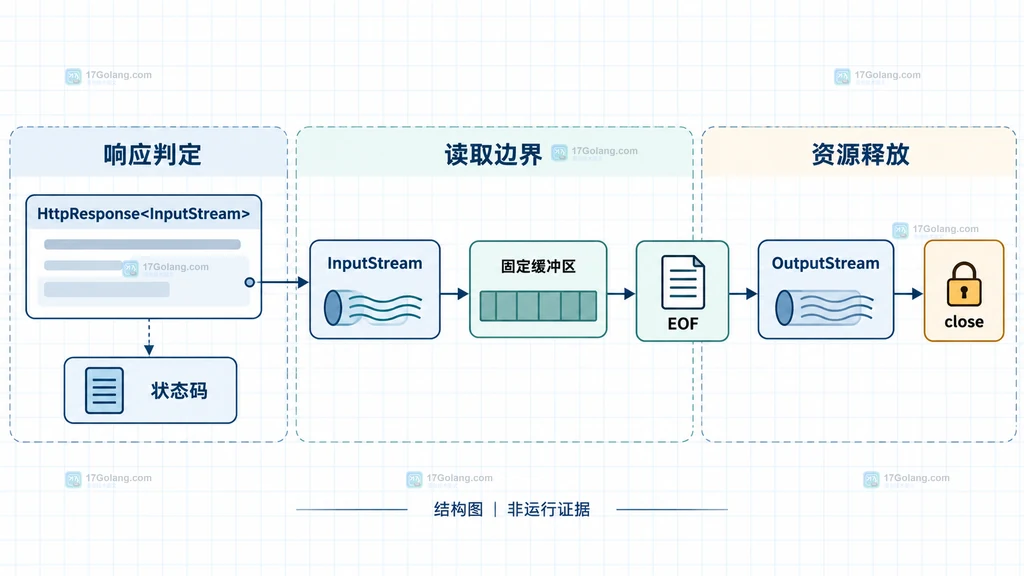
下面的示例只展示消费边界,不假设远端一定返回 2xx。先检查状态码,再读取流;每次只保留一个缓冲区,写入目标文件时不会按响应总大小增长堆内存。
import java.io.IOException;
import java.io.InputStream;
import java.io.OutputStream;
import java.net.URI;
import java.net.http.HttpClient;
import java.net.http.HttpRequest;
import java.net.http.HttpResponse;
import java.nio.file.Files;
import java.nio.file.Path;

public class StreamDownload {
    public static void main(String[] args) throws IOException, InterruptedException {
        HttpClient client = HttpClient.newHttpClient();
        HttpRequest request = HttpRequest.newBuilder()
                .uri(URI.create("https://example.com/archive.bin")) // 示例地址,实际项目替换为受信任的接口
                .build();

        HttpResponse response = client.send(
                request, HttpResponse.BodyHandlers.ofInputStream()); // 只在响应头就绪后取得流

        if (response.statusCode() / 100 != 2) {
            response.body().close(); // 非成功状态也要释放响应体
            throw new IOException("HTTP status: " + response.statusCode());
        }

        Path target = Path.of("download.bin");
        try (InputStream in = response.body(); // try-with-resources 保证提前失败时也关闭
             OutputStream out = Files.newOutputStream(target)) {
            byte[] buffer = new byte[8192]; // 固定缓冲区,避免按响应大小分配内存
            int count;
            while ((count = in.read(buffer)) != -1) { // -1 表示已经到达 EOF
                out.write(buffer, 0, count); // 只写入本次实际读到的字节
            }
        }
    }
}
示例中的 InputStream 一定要在资源作用域内使用。若是把流交给另一个线程或异步任务,不能在当前方法返回时就关闭它,应改由真正的消费者拥有关闭责任,并明确超时和取消策略。
状态码、EOF 与提前关闭要分开判断
内置的 BodyHandlers 通常不会替你检查状态码,404 或 500 的响应体同样可能被交给输入流。因此,状态码是“是否接受这次响应”的判断,EOF 是“已接受的响应体是否读完”的判断,两者不能混为一谈。
| 场景 | 应做的事 | 结果判断 |
|---|---|---|
| 2xx 且读到 -1 | 关闭流并提交文件或结果 | 正常完成 |
| 非 2xx | 读取有限错误信息或关闭流 | 业务失败,不应当当作下载成功 |
| 读取抛 IOException | 保留异常上下文并关闭目标资源 | 可能是网络中断或目标写入失败 |
| 业务提前停止 | 立即关闭 InputStream | 释放本次交换,连接复用取决于客户端实现 |
Oracle 文档特别强调:如果没有读完所有字节,就要调用 InputStream.close()。关闭未耗尽的流可能使底层连接关闭,后续请求也就不能复用这条连接;这是一种资源释放代价,不应被误判成读取成功。
四种 BodyHandler 的选择边界
如果响应小、需要直接做字符串处理,ofString() 更简单;二进制体量可控时可以用 ofByteArray();目标就是落盘且不需要自定义消费逻辑时,ofFile() 更直接。需要边读边解析、写入自定义存储或在读取过程中统计进度时,才选 ofInputStream()。
- 文本接口:确认字符集和响应大小后使用
ofString()。 - 小型二进制:需要一次性签名或解码时使用
ofByteArray()。 - 文件落盘:无需介入每个字节时使用
ofFile()。 - 自定义消费:选择
ofInputStream(),自己控制缓冲、解析、限额和关闭。
常见问题
拿到 HttpResponse 时响应体一定已经完整了吗?
不一定。使用 ofInputStream() 时,响应头已就绪,但 body 可能仍在接收,完整性要由读取到 EOF 来判断。
只读取前几 KB 后返回可以吗?
可以,但必须关闭流,并把它视为主动放弃本次响应体;不要把“读到部分内容”当成完整文件。
ofInputStream() 会自动解析 JSON 吗?
不会。它只提供字节流,JSON 解码、大小限制、字符集和错误格式都需要由业务代码负责。
-
501 收藏
-
文章 · java教程 | 1个月前 | Java · 异常处理 · 资源管理 · java try-with-resources AutoCloseable close suppressed exception501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
288 收藏
-
244 收藏
-
247 收藏
-
文章 · java教程 | 1小时前 | Java · nio · HTTP客户端 · java httpclient HttpRequest BodyPublisher HTTP请求体 BodyPublishers386 收藏
-
文章 · java教程 | 1小时前 | 文件处理 · Java · 异常处理 · nio · java 文件替换 Files.move ATOMIC_MOVE REPLACE_EXISTING 原子移动290 收藏
-
497 收藏
-
162 收藏
-
450 收藏
-
249 收藏
-
359 收藏
-
397 收藏
-
293 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习