
Redis SCAN MATCH COUNT 怎样分批扫描业务键
来源:17golang原创
时间:2026-10-28 23:55:26 168浏览 收藏
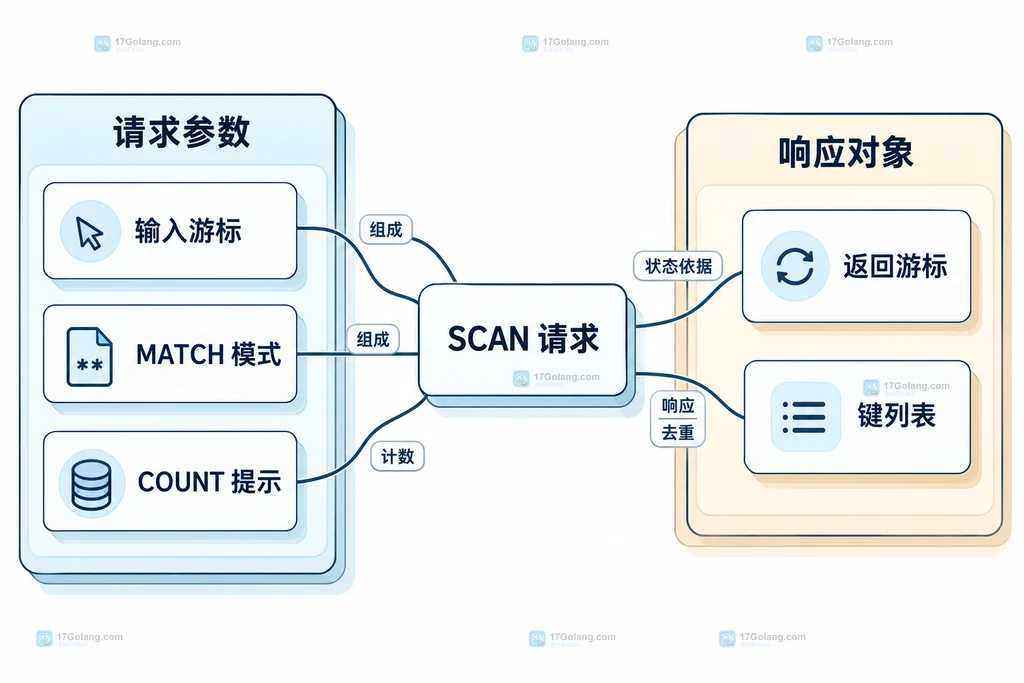
按业务前缀分批扫描 Redis 键,可以从 SCAN 0 MATCH order:* COUNT 200 开始,下一次传入上次返回的游标,直到返回游标为 0。即使某轮没有匹配键,只要游标不是 0,就要继续;COUNT 是工作量提示,不是固定页大小。
官方地址:https://redis.io/docs/latest/commands/scan/
# 只读示例:引号防止shell把星号展开成本地文件。
# 响应第一部分是下一游标,第二部分才是本轮匹配键。
redis-cli SCAN 0 MATCH 'order:*' COUNT 200
这里使用单实例当前逻辑数据库中的键空间。命令没有读取键值,也没有删除键。示例数字只表示一个可调整的起点,不能据此承诺每轮固定处理量或延迟。
为什么扫描几轮就以为没有业务键了?
常见错误是把 SCAN 当分页接口:固定传入 0、自己给游标加 1,或者遇到空数组便退出。这几种写法都没有遵守 Redis 的游标迭代协议。MATCH 使用 glob 模式匹配键名,匹配结果稀疏时,多轮空结果是正常情况。
先检查实际连接的实例和数据库,再确认前缀及大小写。模式 order:* 不是正则表达式;如果业务键名不同,即使扫描完整,也可能没有匹配项。空批次只能说明这一轮没有返回匹配键,不能说明全库没有。
| 参数或响应 | 作用 | 不代表什么 |
|---|---|---|
| 游标 | 继续本次迭代 | 页码、偏移或完成百分比 |
| MATCH | 按 glob 模式筛选键名 | 独立业务前缀索引 |
| COUNT | 提示单次扫描工作量 | 返回条数上限或固定页大小 |
| 返回游标 0 | 本轮迭代结束 | 生成了一份时间点快照 |
用一个完整循环修复提前退出
下面使用已安装 redis-py 的 Python 环境,直接连接本地独立测试实例的数据库 0。把它作为只读采集骨架;生产连接需按实际认证、TLS 和超时要求配置,凭据不应写进正文或输出文件。处理函数仅把键名编码成 JSON 行,不访问键值。
import base64
import json
import sys
import time
import redis

# 保留二进制键名,避免假设所有Redis键都能直接按UTF-8解码。
client = redis.Redis(
    host="127.0.0.1", port=6379, db=0,
    decode_responses=False,
    socket_connect_timeout=3, socket_timeout=3,
)
cursor = 0
calls = 0
returned = 0
deadline = time.monotonic() + 60
completed = False
exit_code = 0

try:
    while True:
        # 必须使用上一轮返回的cursor;不自行递增。
        cursor, keys = client.scan(
            cursor=cursor, match=b"order:*", count=200
        )
        calls += 1
        for key in keys:
            # 每行保存一个键名;Base64也能表示换行等特殊字节。
            print(json.dumps({
                "key_b64": base64.b64encode(key).decode("ascii")
            }))
            returned += 1

        # 先处理最后一批键,再判断完整迭代是否结束。
        if cursor == 0:
            completed = True
            break
        if time.monotonic() >= deadline:
            raise TimeoutError("达到扫描任务时间预算,结果尚不完整")
        time.sleep(0.02)  # 只给批次间加入小间隔,不保证服务器响应时长。
except (redis.RedisError, TimeoutError) as exc:
    print(str(exc), file=sys.stderr)
    exit_code = 1
finally:
    # 这是实际运行时生成的状态;本文没有伪造扫描统计值。
    print(json.dumps({
        "completed": completed, "last_cursor": cursor,
        "calls": calls, "returned_occurrences": returned
    }), file=sys.stderr)
    client.close()

raise SystemExit(exit_code)
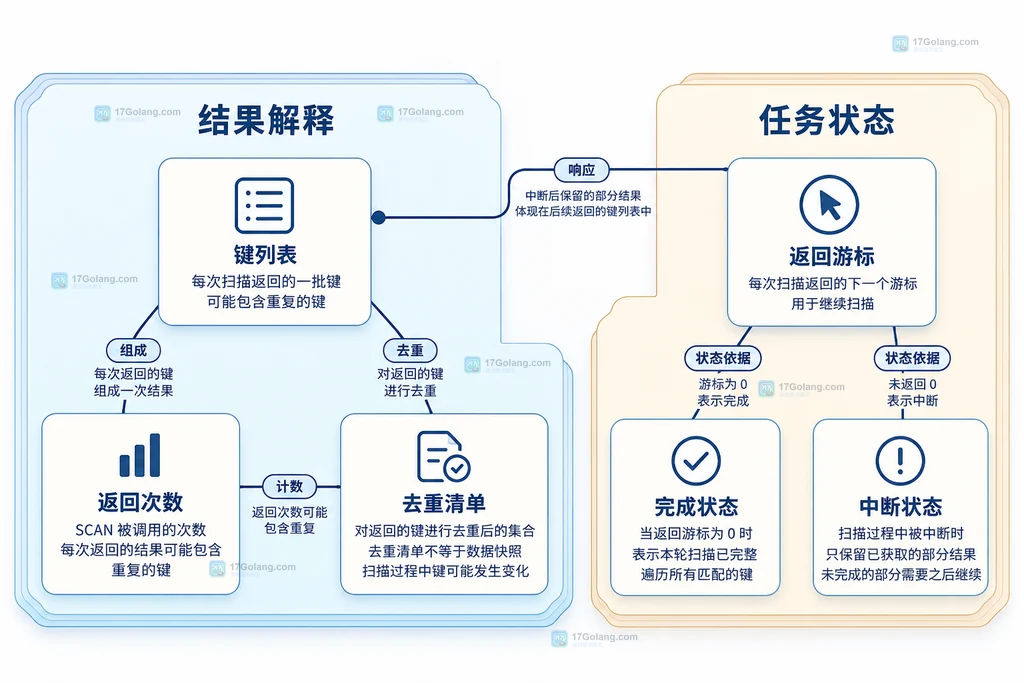
这段代码把三类判断分开:键列表决定本轮要处理什么,游标决定迭代是否结束,时间预算决定任务是否应中断。达到预算会报“未完成”,而不是把已经拿到的一部分键冒充完整清单。预算在批次之间检查,单次网络等待仍受连接和读取超时约束,并非严格的总墙钟上限。
代码没有把全部键攒进内存,因此 returned_occurrences 统计的是返回次数,包含可能的重复,不是去重后的业务键总数。输出包含键名信息,应按业务数据敏感程度存放,不要直接发送到公开日志。
修好循环后,为什么还会看见重复或变化?
SCAN 允许同一键重复返回,处理端应去重或保证重复处理没有副作用。只读导出可在后续存储中按原始键字节去重;需要执行写操作时,仅靠扫描阶段去重并不足够,仍要处理键被改写、过期或重新创建的情况。
它也不是快照。完整扫描期间持续存在的匹配键有相应遍历保证,而期间新增、消失或变化的对象不能按某个固定时间点的集合理解。扫描结束后立即 GET,一个键也可能已经不存在;这不自动证明 SCAN 出错。
怎样调整 COUNT,才不会把分批变成大请求?
先记录每轮耗时和返回量,再结合 Redis 延迟与应用压力调整。COUNT 可以在同一次迭代的不同调用间改变,但下一轮游标仍必须来自上一轮。更高 COUNT 可能减少往返,也可能增加单次工作量;没有适合所有键空间的固定数字。
对于常规单实例扫描,不要把 MATCH 想成一个能直接定位所有前缀键的索引。业务只匹配少数键时,总扫描成本仍值得关注。如果需要高频精确查询某类对象,应考虑维护明确的业务索引,而不是不断重扫整个键空间。
本文代码不是 Redis Cluster 全集群枚举器。集群场景需根据拓扑和客户端行为明确每个节点的扫描范围及迁移期间的结果语义;不要把一个普通连接的游标跨节点续用,也不要把单节点完成误报成全局完成。
怎么核对扫描程序写对了?
在独立测试实例放入有限且保持稳定的已知键集合,既包含匹配前缀,也包含不匹配前缀。完整扫描后按键字节去重,与预设集合比较;同时记录空批次是否被跳过、最后一批是否处理,以及 completed 是否只在返回游标 0 时成立。本文不把这项读者测试建议当作已经执行的证据。
能用游标实现前端“上一页、下一页”吗?
不宜把它当稳定分页方案。键不保证业务排序,结果可能重复且没有快照语义;有排序与翻页要求时需要匹配的业务数据结构。
任务中断后保存游标就能永久可靠续扫吗?
游标应结合原实例、数据库和任务条件理解,不能当长期稳定的检查点。连接目标、服务状态或拓扑变化后应重新评估;需要可靠遍历任务时,保留重复处理能力,并明确重启扫描与未完成记录的策略。
-
325 收藏
-
397 收藏
-
342 收藏
-
331 收藏
-
348 收藏
-
275 收藏
-
371 收藏
-
154 收藏
-
468 收藏
-
176 收藏
-
338 收藏
-
238 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习