
可以。浏览器端把文本流压成 gzip,最清晰的做法是拆成两段:先用 TextEncoderStream 把字符串块转成 UTF-8 字节,再用 CompressionStream("gzip") 把字节块压缩。两者都属于流式转换,适合边产生边处理,不必先把整篇文本拼成一个超大的字符串。
最终得到的是压缩后的二进制字节流,不是可直接显示的文本。如果把它作为 HTTP 请求体发送,服务端还需要根据 Content-Encoding: gzip 解码;这个头描述的是请求体已经采用的内容编码,不是普通的响应压缩开关。
先分清文本、字节与压缩流
CompressionStream 不负责理解 JavaScript 字符串,它接收的是字节。文本输入因此需要先编码。可以把整个过程看成下面四个节点:
- 文本块:例如日志行、JSON 片段或用户输入的增量内容。
- UTF-8 字节:由
TextEncoderStream产生,编码结果是Uint8Array。 - gzip 压缩流:由
CompressionStream("gzip")产生。 - 压缩字节:可以收集为
Uint8Array,再交给 Blob、文件或请求体。
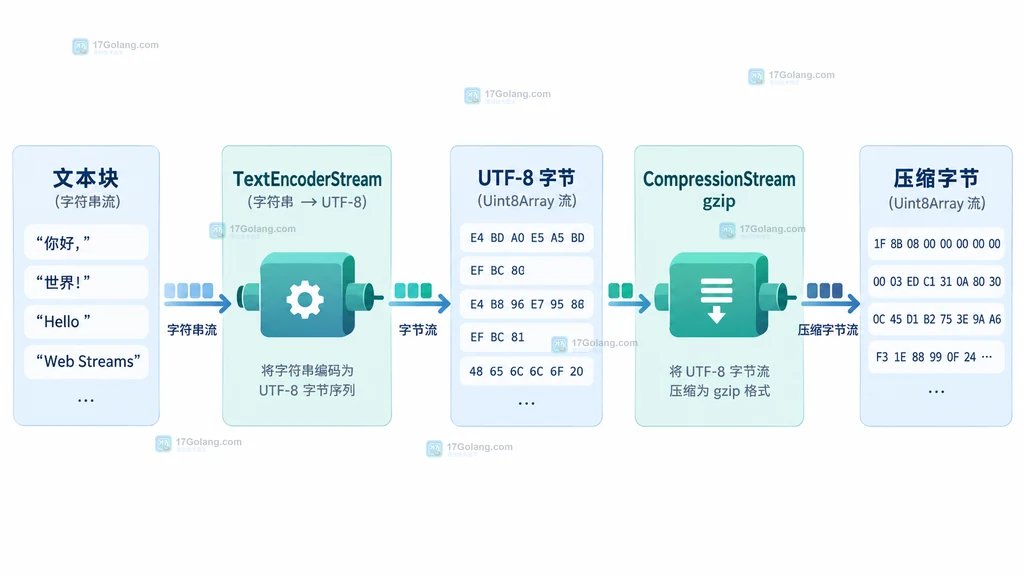
这里不要把 TextEncoderStream 和 TextDecoderStream 混用:前者是字符串到 UTF-8 字节,后者是字节到字符串。压缩发生在字节阶段。
把文本流接成 gzip 管道
如果文本来源本身就是一个 ReadableStream,可以连续调用 pipeThrough()。下面的函数接收字符串块,并返回已经压缩的 ReadableStream:
function gzipTextStream(textStream) {
  // 第一段只做 UTF-8 编码,把字符串块变成 Uint8Array。
  const utf8Stream = textStream.pipeThrough(new TextEncoderStream());

  // 第二段只做 gzip 压缩,输出仍然是二进制字节块。
  return utf8Stream.pipeThrough(new CompressionStream("gzip"));
}
这个函数没有立即读取数据。流是按需传递的:下游开始读取时,上游才会逐步产生并转换数据。压缩格式只写成 gzip 或 deflate 这类 API 支持的格式,不要把 MIME 类型或文件扩展名传给构造函数。
读取压缩结果并处理结束
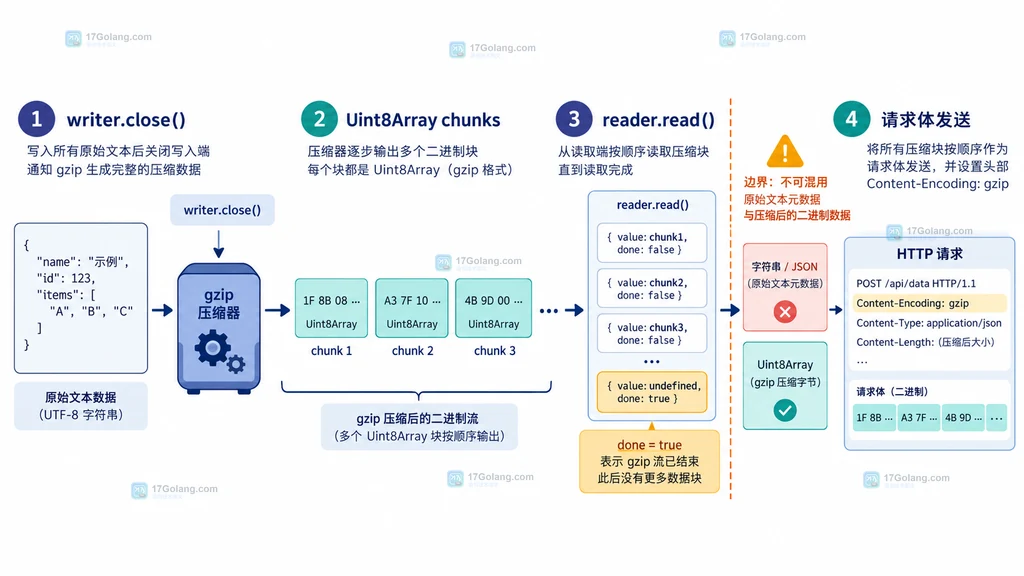
为了保存或查看压缩结果,可以从返回流取得 reader,逐块收集字节。关键点是等待写端关闭后再等待读取端结束,否则只读到部分结果就开始组装 Blob。
async function compressTextChunks(chunks) {
  const source = new ReadableStream({
    start(controller) {
      // 按顺序推入文本块,结束时必须关闭源流。
      for (const chunk of chunks) controller.enqueue(chunk);
      controller.close();
    },
  });

  const compressed = gzipTextStream(source);
  const reader = compressed.getReader();
  const output = [];

  try {
    while (true) {
      const { value, done } = await reader.read();
      // done=true 表示压缩器已经把尾部字节也交给读取端。
      if (done) break;
      if (value) output.push(value);
    }
  } finally {
    // 发生异常时释放 reader 锁,避免后续无法接管该流。
    reader.releaseLock();
  }

  // Blob 会按给定顺序拼接每个 Uint8Array 压缩块。
  return new Blob(output, { type: "application/gzip" });
}
done 是读取生命周期的边界,不代表原文里出现了某个特殊字符串。只有源流被关闭、压缩器完成收尾并把最后的 gzip 数据推出后,读取端才会得到 done: true。
上传时不要把压缩字节当普通文本
压缩结果可以作为请求体发送,但请求头要表达内容编码。下面示例直接发送 Blob;它只演示客户端的流转关系,服务端必须实际支持 gzip 请求体解码。
async function uploadGzipText(chunks, endpoint) {
  const blob = await compressTextChunks(chunks);

  // Content-Encoding 表示请求体已经是 gzip 编码,不能省略或写成普通文本类型。
  const response = await fetch(endpoint, {
    method: "POST",
    headers: {
      "Content-Type": "text/plain; charset=utf-8",
      "Content-Encoding": "gzip",
    },
    body: blob,
  });

  // HTTP 错误不一定会抛异常,显式检查状态并保留响应体用于排障。
  if (!response.ok) {
    throw new Error(`upload failed: ${response.status}`);
  }
  return response;
}
Content-Type 描述解压后原始内容的媒体类型,Content-Encoding 描述传输中的编码方式。两者不是二选一:服务端先按 gzip 解码,再按文本类型处理内容。
兼容性与常见误区
| 现象 | 常见原因 | 处理方式 |
|---|---|---|
| 结果无法显示 | 把 gzip 字节当字符串读取 | 保存为 Blob 或 Uint8Array,读取端使用对应的解压逻辑 |
| 只收到半个文件 | 源流未关闭,或没有等待 reader 返回 done | 在生产者完成后调用 close,并等待完整读取 |
| 服务端返回解码错误 | 请求头缺少或错误设置 Content-Encoding | 确认服务端按 gzip 解析请求体 |
| 旧浏览器没有构造函数 | Compression Streams API 支持范围不足 | 根据目标浏览器矩阵准备降级方案或压缩库 |
Compression Streams API 的常见实现已经覆盖主流浏览器,但项目仍应按自己的浏览器矩阵确认兼容性。文章中的管道是浏览器 API 的使用示意,不把静态说明图当作运行截图或兼容性证明。
小结
记住顺序即可:字符串块先经过 TextEncoderStream 变成 UTF-8 字节,再经过 CompressionStream("gzip") 变成压缩字节;读取端等待 done=true,上传端用 Content-Encoding: gzip 告诉服务端如何还原。这样既保留了流式处理的低峰值特性,也避免把文本、字节和压缩编码混成一个概念。
相关问题
CompressionStream 能直接压缩 JavaScript 字符串吗?
不能直接把字符串当作它的输入契约。先用 TextEncoder 或 TextEncoderStream 转成 UTF-8 字节,再进入压缩流。
gzip 压缩结果应该用什么类型保存?
可以收集为 Uint8Array,也可以把字节块组成 Blob。不要用普通字符串保存,否则会破坏二进制数据。
请求头里的 Content-Type 要写 gzip 吗?
不应该。Content-Type 写解压后内容的类型,例如 text/plain;Content-Encoding 才写 gzip。




