
MySQL INFORMATION_SCHEMA.TABLES 怎样区分表大小与索引大小
来源:17golang原创
时间:2026-10-31 23:15:33 175浏览 收藏
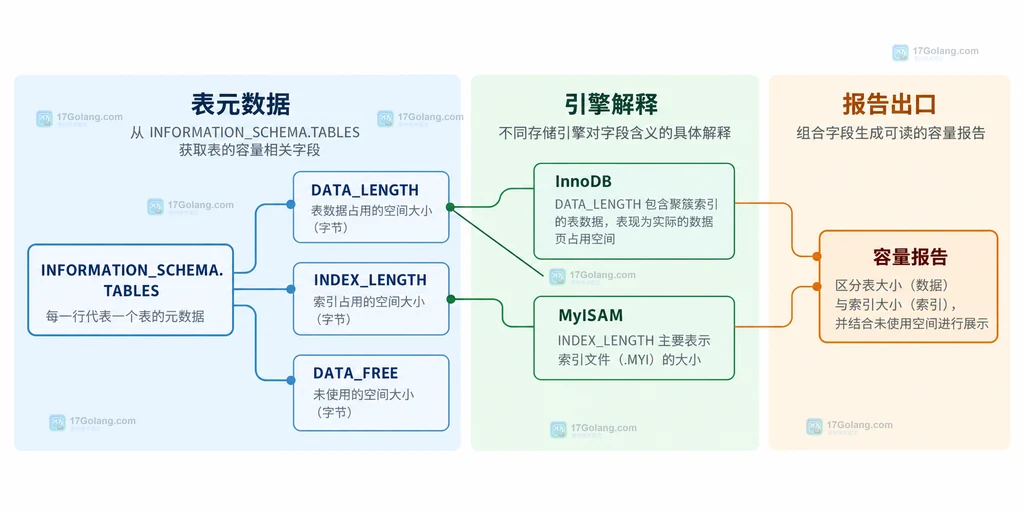
做 MySQL 容量盘点时,不能把“表大小”简单理解成一个磁盘数字。更稳妥的做法是先从 INFORMATION_SCHEMA.TABLES 读取 DATA_LENGTH、INDEX_LENGTH 和 DATA_FREE,再结合存储引擎、分区方式解释结果:对 InnoDB,前者近似聚簇索引占用空间,后者近似非聚簇索引占用空间;对 MyISAM,它们更接近数据文件和索引文件长度。
官方地址:https://dev.mysql.com/doc/refman/8.4/en/information-schema-tables-table.html
这组数据适合做库表排序、容量趋势和索引占比分析,但不应直接当成操作系统目录的精确文件大小。
先分清三个容量字段到底代表什么
DATA_LENGTH、INDEX_LENGTH 都以字节为单位,但含义受存储引擎影响。DATA_FREE 表示已分配但暂未使用的空间,InnoDB 共享表空间场景下还可能反映所属表空间的可用空间,而不是某一张表独占的空洞。
| 字段 | 盘点时的用途 | 需要留意的边界 |
|---|---|---|
DATA_LENGTH | 观察表数据或 InnoDB 聚簇索引的近似空间 | 不是所有引擎都表示同一种物理对象 |
INDEX_LENGTH | 观察非聚簇索引或 MyISAM 索引文件的近似空间 | 没有索引时可能为 0,数值也可能是估算 |
DATA_FREE | 发现已分配但未使用的空间 | 共享表空间下不能直接归因到单表 |
按库汇总数据与索引空间
先查询单表明细,再做汇总,最容易发现“索引占比异常高”的对象。下面的 SQL 只读取元数据,不扫描业务表行。
-- 先按表查看数据、索引和空闲空间,便于定位大对象
SELECT
    TABLE_SCHEMA,
    TABLE_NAME,
    ENGINE,
    COALESCE(DATA_LENGTH, 0) AS data_bytes,
    COALESCE(INDEX_LENGTH, 0) AS index_bytes,
    COALESCE(DATA_FREE, 0) AS free_bytes,
    COALESCE(DATA_LENGTH, 0) + COALESCE(INDEX_LENGTH, 0) AS used_bytes
FROM INFORMATION_SCHEMA.TABLES
WHERE TABLE_SCHEMA NOT IN ('information_schema', 'mysql', 'performance_schema', 'sys')
  AND TABLE_TYPE = 'BASE TABLE'
ORDER BY used_bytes DESC
LIMIT 30;
如果需要按库看总量,可以把同样的字段聚合起来。这里用 COALESCE 把可能的 NULL 统一成 0,避免总和被空值影响。
-- 按业务库汇总表数据与索引空间,并计算索引占比
SELECT
    TABLE_SCHEMA,
    SUM(COALESCE(DATA_LENGTH, 0)) AS data_bytes,
    SUM(COALESCE(INDEX_LENGTH, 0)) AS index_bytes,
    SUM(COALESCE(DATA_LENGTH, 0) + COALESCE(INDEX_LENGTH, 0)) AS used_bytes,
    ROUND(
        100 * SUM(COALESCE(INDEX_LENGTH, 0)) /
        NULLIF(SUM(COALESCE(DATA_LENGTH, 0) + COALESCE(INDEX_LENGTH, 0)), 0),
        2
    ) AS index_ratio_pct
FROM INFORMATION_SCHEMA.TABLES
WHERE TABLE_TYPE = 'BASE TABLE'
GROUP BY TABLE_SCHEMA
ORDER BY used_bytes DESC;
为什么 InnoDB 的“数据大小”不等于纯行数据
在 InnoDB 中,官方文档把 DATA_LENGTH 解释为聚簇索引占用空间的近似值,INDEX_LENGTH 则近似表示非聚簇索引占用空间。由于主键记录就在聚簇索引中,所以把 DATA_LENGTH 直接叫“纯数据文件大小”会误导容量判断。
反过来,MyISAM 的两个字段分别更接近数据文件和索引文件长度。迁移或混合存储引擎的环境,报告中应该保留 ENGINE 列,不能只输出两个数字。
此外,TABLE_ROWS 对 InnoDB 只是优化器使用的粗略估计;如果需要精确行数,应单独执行 COUNT(*),不要用容量表的估算行数反推平均记录大小。
分区表要把总表视图和分区明细分开看
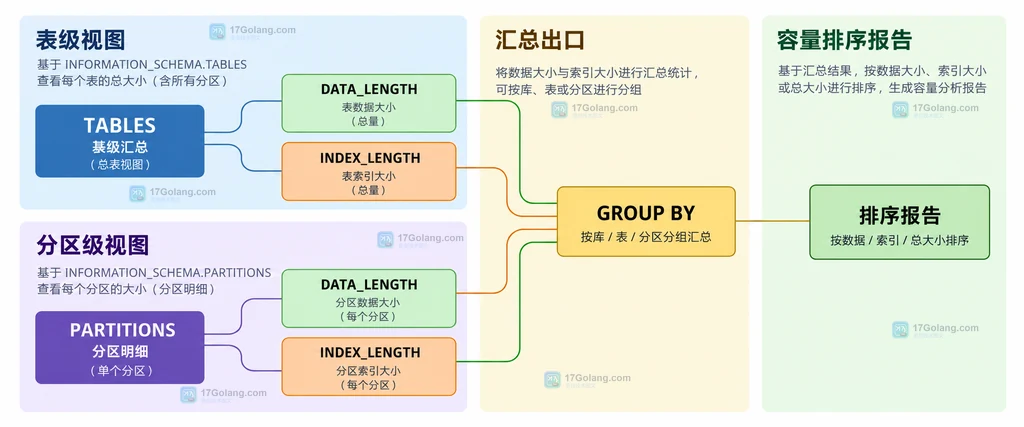
普通表可以直接按 TABLES 汇总。分区表需要进一步查看 INFORMATION_SCHEMA.PARTITIONS,因为每个分区都有自己的数据长度和索引长度;分析冷热分区、归档分区或异常膨胀时,分区级数据比单个总数更有解释力。
-- 分区表按分区查看数据和索引空间,定位单个分区的容量变化
SELECT
    TABLE_SCHEMA,
    TABLE_NAME,
    PARTITION_NAME,
    COALESCE(DATA_LENGTH, 0) AS data_bytes,
    COALESCE(INDEX_LENGTH, 0) AS index_bytes,
    COALESCE(DATA_LENGTH, 0) + COALESCE(INDEX_LENGTH, 0) AS used_bytes
FROM INFORMATION_SCHEMA.PARTITIONS
WHERE TABLE_SCHEMA = 'app'
  AND TABLE_NAME = 'orders'
  AND PARTITION_NAME IS NOT NULL
ORDER BY used_bytes DESC;
若只关心表级结果,可继续使用 TABLES;若要解释某个分区为什么突然变大,再结合分区边界、数据写入时间和索引设计分析。不要把 DATA_FREE 直接当成“可以马上释放的空间”。
容量报告的四个实用边界
- 保留
ENGINE、表名和统计时间,避免不同引擎的同名字段被混合解读。 - 把
DATA_LENGTH + INDEX_LENGTH当作元数据口径的已用近似值,不与du或表空间文件大小直接画等号。 - 分区表排查异常时查看
PARTITIONS,不要只看整表一行。 - 需要验证报告口径时,可用
SHOW TABLE STATUS对照;它与INFORMATION_SCHEMA.TABLES的相关字段是等价入口,但仍共享存储引擎和统计估算边界。
常见问题
为什么 INDEX_LENGTH 很大就一定有坏索引吗?
不一定。它首先表示索引空间近似值,索引数量、主键宽度、二级索引列宽度和数据分布都会影响结果。应结合索引定义、查询负载和历史趋势判断。
怎样得到操作系统层面的精确文件大小?
INFORMATION_SCHEMA.TABLES 解决的是 MySQL 元数据口径。若要核对文件或表空间,需要结合具体存储引擎、表空间布局和操作系统工具,不能把本文字段直接当成文件系统统计。
把 DATA_LENGTH 看成数据侧近似、把 INDEX_LENGTH 看成索引侧近似,并始终保留存储引擎与分区维度,容量报告就能从“一个数字”变成可解释的排查线索。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
118 收藏
-
306 收藏
-
271 收藏
-
368 收藏
-
335 收藏
-
374 收藏
-
154 收藏
-
432 收藏
-
232 收藏
-
287 收藏
-
233 收藏
-
417 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习