
当一个 Python 命令行工具同时提供 list、add、remove 等动作时,继续把所有参数堆在同一个 ArgumentParser 里,很快就会遇到帮助信息混乱、参数互相冲突和分支难以维护的问题。argparse 的 subparsers 可以把它拆成一棵命令树:根解析器负责公共入口,每个子解析器负责一个具体命令。
官方文档:https://docs.python.org/3/library/argparse.html
组织多命令 CLI 时,建议同时明确三个契约:用dest保存命令名,用required=True防止漏选命令,再用set_defaults(handler=...)把命令直接路由到处理函数。这样解析层只负责得到结构化参数,业务层不必继续猜用户输入的是哪条命令。
先把根解析器和命令树分开
add_subparsers() 返回的是子命令集合。随后用 add_parser() 为每个命令创建自己的解析器。下面的最小配方只讨论两个命令:读取任务列表的 list,以及新增任务的 add。
import argparse

# 根解析器只描述程序入口和公共帮助信息。
parser = argparse.ArgumentParser(prog="taskctl", description="任务命令行工具")

# dest 会把用户选中的子命令写入 Namespace.command。
subparsers = parser.add_subparsers(
    dest="command",
    title="可用命令",
    metavar="COMMAND",
    required=True,
)

# 每个子解析器只声明本命令需要的参数,避免参数空间互相污染。
list_parser = subparsers.add_parser("list", help="列出任务")
list_parser.add_argument("--all", action="store_true", help="包含已完成任务")

add_parser = subparsers.add_parser("add", help="新增任务")
add_parser.add_argument("name", help="任务名称")
add_parser.add_argument("--priority", type=int, default=3, help="优先级,默认是 3")

args = parser.parse_args()
print(args)
输入 python taskctl.py list --all 时,解析结果大致会包含 command='list' 和 all=True;输入 python taskctl.py add "备份数据" --priority 1 时,则会得到 command='add'、name='备份数据' 和 priority=1。子命令没有声明的选项不会被它意外接收。
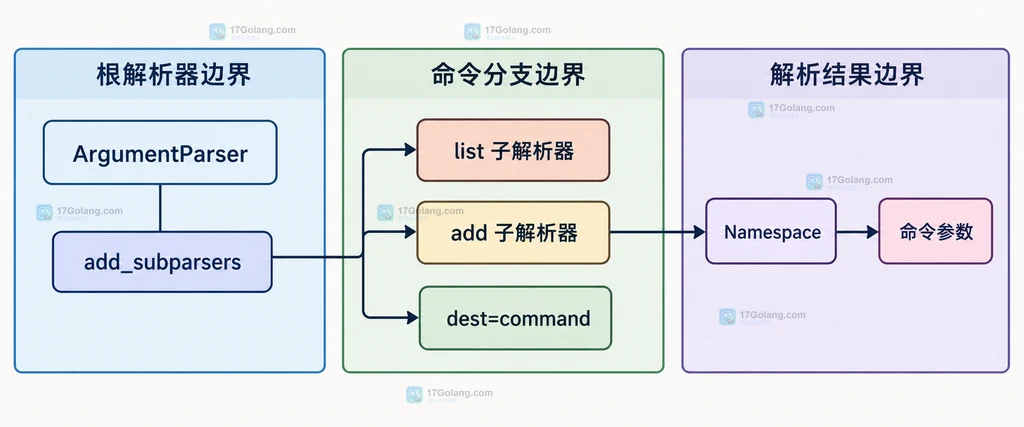
用 dest 让解析结果带上命令名
子解析器最容易被忽略的细节是命令名放在哪里。传入 dest="command" 后,parse_args() 生成的 Namespace 会保留用户选择的命令。没有这个字段时,后续代码往往只能通过“哪个属性存在”来猜分支,随着参数增加会越来越脆弱。
命令名和命令参数最好分成两类:command 只表示路由,name、priority 等字段表示该路由下的业务输入。这样即使两个命令以后出现同名参数,也不会让调用方混淆。
# 只读取解析结果,不在这里重新拼接命令字符串。
args = parser.parse_args(["add", "备份数据", "--priority", "1"])

# command 是路由字段,name 和 priority 是 add 命令的数据字段。
if args.command == "add":
    print(args.name, args.priority)
用 set_defaults 把命令路由到处理函数
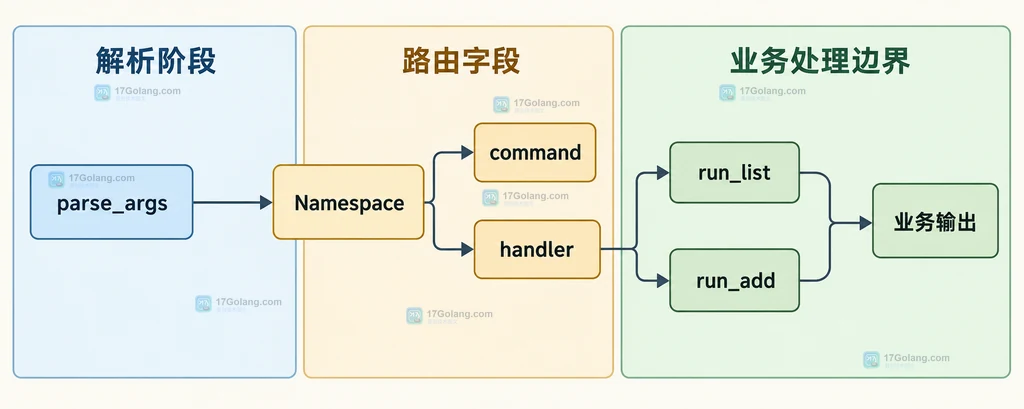
如果每增加一个子命令,就在文件底部继续扩展一长串 if/elif,解析器和业务分支会重新耦合。更易维护的做法是在创建子解析器时绑定处理函数。set_defaults() 写入的是解析结果的默认字段,因此最终可以统一调用 args.handler(args)。
import argparse

def run_list(args):
    # list 命令只读取自己的 --all,不依赖 add 命令的字段。
    scope = "全部任务" if args.all else "未完成任务"
    print(f"正在列出:{scope}")

def run_add(args):
    # 业务函数接收 Namespace,参数校验已由 argparse 完成基础工作。
    print(f"新增任务:{args.name},优先级:{args.priority}")

parser = argparse.ArgumentParser(prog="taskctl")
subparsers = parser.add_subparsers(dest="command", required=True)

list_parser = subparsers.add_parser("list", help="列出任务")
list_parser.add_argument("--all", action="store_true", help="包含已完成任务")
list_parser.set_defaults(handler=run_list)

add_parser = subparsers.add_parser("add", help="新增任务")
add_parser.add_argument("name", help="任务名称")
add_parser.add_argument("--priority", type=int, default=3, help="优先级,默认是 3")
add_parser.set_defaults(handler=run_add)

args = parser.parse_args()
# 子解析器已经提供 handler,入口只保留一个统一调用点。
args.handler(args)
这里的 handler 不是用户输入的参数,而是由子解析器写入 Namespace 的内部路由字段。它不会出现在用户命令行中,也不需要再为每个命令手写分支表。
全局参数和共享参数要放在正确层级
例如 --verbose、--config 这类选项属于整个程序,通常放在根解析器上。它们的调用位置也因此固定在子命令之前:
# 全局选项在根解析器声明,两个子命令都可以读取。
parser.add_argument("--verbose", action="store_true", help="输出更多诊断信息")

# 典型调用:全局选项位于子命令之前。
# python taskctl.py --verbose list
如果某个参数只在多个子命令之间复用,可以用一个不显示独立帮助的父解析器集中声明,再通过 parents=[common] 传给需要它的子解析器。
# 父解析器承载共享参数,避免在多个子解析器中复制同一段声明。
common = argparse.ArgumentParser(add_help=False)
common.add_argument("--format", choices=("text", "json"), default="text", help="输出格式")

# 只有需要该参数的命令才继承 common。
list_parser = subparsers.add_parser("list", parents=[common], help="列出任务")
add_parser = subparsers.add_parser("add", help="新增任务")
根级参数、共享父解析器参数和单个命令参数是三种不同职责。不要为了“方便”把所有选项都放到根解析器,否则帮助信息会失去命令边界。
用 required=True 处理没有命令的输入
如果不设置 required=True,用户只执行 python taskctl.py 时,解析器可能得到一个没有命令字段的 Namespace,程序随后才在业务层报错。把约束放在子解析器集合上,错误会更靠近输入入口:
# 没有命令时直接由 argparse 给出用法和错误,不让业务层猜测意图。
subparsers = parser.add_subparsers(
    dest="command",
    required=True,
    title="可用命令",
)

# 仍然可以用 choices 或 add_parser 的参数声明约束具体命令。
list_parser = subparsers.add_parser("list", help="列出任务")
命令存在并不代表参数一定有效。比如 --priority 的类型、可选值和必填位置仍应在对应子解析器中声明;跨字段的业务规则再交给处理函数或独立校验函数。
一个可落地的组织清单
| 问题 | 推荐放置 | 判断标准 |
|---|---|---|
| 用户选了哪个命令 | add_subparsers(dest="command") | 路由只读取一个稳定字段 |
| 命令是否必选 | required=True | 空输入立即显示 argparse 错误 |
| 命令如何进入业务函数 | 子解析器 set_defaults(handler=...) | 入口统一调用 args.handler(args) |
| 所有命令都需要的选项 | 根解析器 | 调用位置和帮助归属明确 |
| 部分命令共用的选项 | 父解析器 parents=[common] | 只被需要的子命令继承 |
最后可以把 CLI 的职责固定成三层:根解析器描述程序入口,子解析器描述命令契约,处理函数负责业务动作。这个边界比把所有参数放在一个解析器里更容易扩展,也能让 --help 输出跟着命令树自然增长。
相关问题
subparsers 的 dest 不写会怎样?
解析结果不会自动提供一个稳定的命令名字段,路由代码只能依赖某些命令参数是否存在。多命令工具建议显式设置 dest。
为什么 handler 可以放进 Namespace?
Namespace 本来就是 argparse 保存解析结果的对象,set_defaults() 可以向其中加入固定字段。函数对象作为内部字段传递,不等同于让用户输入任意可执行内容。
全局参数能不能写在子命令后面?
根解析器声明的选项通常按根解析器的参数位置使用。若希望某个选项属于特定子命令并出现在命令后面,就把它声明在该子解析器或共享父解析器上。




