
先给结论:切片元素是结构体时,for _, item := range users 中的 item 是当前元素的值副本。直接修改 item.Status 不会写回原切片;需要原地修改就使用索引,需要整体变换就显式写回。
如果切片元素是结构体,for _, item := range users中的item默认不是切片元素本身。要原地改字段,优先使用索引;如果先在副本上计算,就必须显式写回。
Go 官方规范对 range 的描述是:遍历数组或切片时,第二个迭代值来自 a[i],再赋给对应的迭代变量。下面按“现象—证据—修复—复查”的顺序排查。
先还原修改失效的现场
假设有一组待处理的用户,目标是把状态统一改成 active:
package main

import "fmt"

type User struct {
	ID     int
	Name   string
	Status string
}

func main() {
	users := []User{
		{ID: 1, Name: "林晓", Status: "pending"},
		{ID: 2, Name: "周宁", Status: "pending"},
	}

	for _, item := range users {
		// item 是当前结构体元素的值复制,修改它不会写回 users。
		item.Status = "active"
	}

	// 预期仍会看到 pending,因为上面的赋值只改了副本。
	fmt.Println(users[0].Status, users[1].Status)
}
这段代码的关键不是 := 本身,而是右侧的元素类型是 User。每轮把一个 User 值交给 item,item.Status 只是给这份值的字段赋值;它没有成为 users[i] 的可写别名。
Go 1.22 调整了部分 for 迭代变量的生命周期,Go 1.23 又扩展了 range 的数据源,但这些变化都不等于“结构体 range 变量会自动引用原元素”。判断修改是否能落到切片,仍然要先看元素是值还是指针。
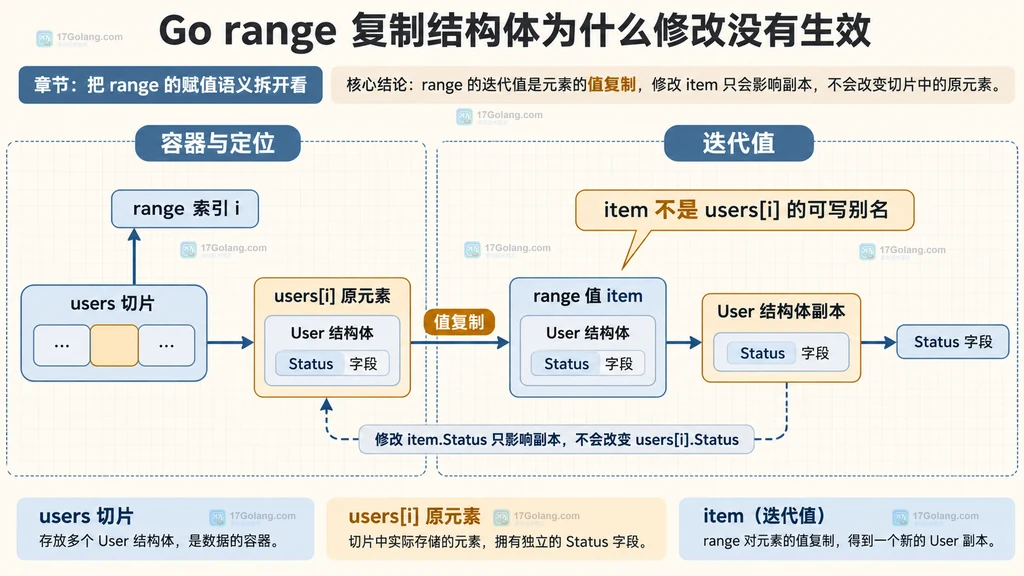
把 range 的赋值语义拆开看
遇到“改了但没生效”,我会先把循环写成带索引和值的形式,再问三个问题:
users的元素类型是User,还是*User?- 循环体修改的是
item,还是通过i访问的users[i]? - 本轮计算出来的新结构体有没有显式写回容器?
对于 []User,i 是索引,item 是对应元素值。可以把它理解为下面的关系:
for i, item := range users {
	// item 与 users[i] 类型相同,但 item 是值变量。
	// 下面的比较用于观察它们当前字段值相同,不代表两者共享存储。
	fmt.Println(i, item.ID == users[i].ID, item.Status == users[i].Status)
}
结构体里的切片、指针或 map 字段还可能让人产生“好像改到了”的错觉:外层结构体本身被复制,但它内部的引用型字段仍可能指向同一底层数据。因此,要判断是否真的原地修改,必须看你改的是结构体的普通字段,还是其中一个引用型字段。
需要原地改字段时,用索引访问
最直接的修复是保留索引,直接对 users[i] 的字段赋值。这里没有中间副本,修改目标就是切片中的那个结构体元素:
func activate(users []User) {
	for i := range users {
		// 通过索引定位真实切片元素,再修改它的字段。
		if users[i].Status == "pending" {
			users[i].Status = "active"
		}
	}
}
只需要改字段时,这种写法通常最清楚。它也让代码审查更容易:看到 users[i],就能确认赋值会落到原切片,而不是循环变量。
如果只需要索引,不需要值,可以写成 for i := range users。这样不会额外复制每个结构体;当结构体字段较多时,这种表达也能避免不必要的值拷贝。
先在副本上计算,再显式写回
有时循环体需要对当前结构体做多步变换,保留值变量反而更易读。这时要在处理结束后把结果写回同一个索引:
func normalizeNames(users []User) {
	for i, item := range users {
		// item 作为工作副本,适合承载多步计算和条件判断。
		item.Name = "用户-" + item.Name
		if item.Status == "pending" {
			item.Status = "active"
		}

		// 明确把处理后的结构体替换回原切片元素。
		users[i] = item
	}
}
这条路径的判断证据是:循环体中是否出现了 users[i] = item。如果没有这句,前面对普通字段的修改仍然只停留在副本里。
写回方式适合整体替换或需要保持“输入值—变换—输出值”边界的场景。但它也会把 item 的全部字段写回去;如果循环期间还有其他协作者修改同一切片,就要先明确并发和所有权边界,不能把写回当成并发同步方案。
元素是指针时,复制的是什么
如果切片类型是 []*User,range 复制的是指针值。多个指针变量仍然可以指向同一个 User 对象,因此修改 item.Status 通常会影响指针指向的对象:
func activatePointers(users []*User) {
	for _, item := range users {
		// item 是指针的复制品,但它仍指向原来的 User 对象。
		if item != nil && item.Status == "pending" {
			item.Status = "active"
		}
	}
}
这里真正共享的是指针指向的对象,不是 range 变量本身。这个方案可以表达“多个位置引用同一个实体”,但会引入 nil 判断、对象生命周期和共享可变状态等额外考虑。如果业务数据天然是值对象,不要为了绕过 range 复制就把所有切片改成指针切片。
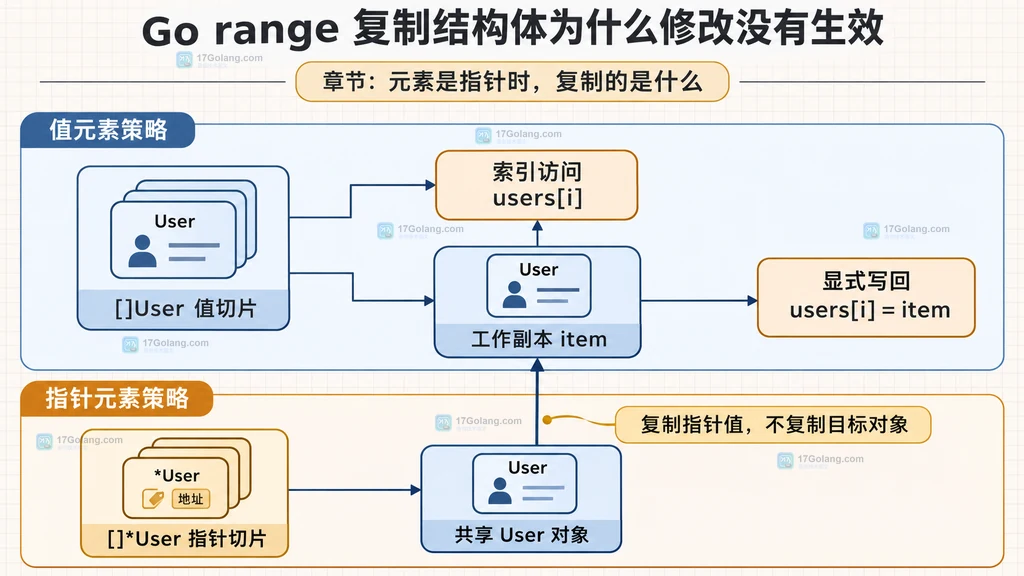
用一张排查清单做反向确认
代码改完后,不要只看循环里那一行赋值,可以沿着下面的清单复查:
- 元素是结构体值还是结构体指针?
- 如果是结构体值,修改是否通过
users[i]完成,或者是否有明确的users[i] = item? - 如果是指针切片,是否处理了 nil,并且确实允许共享修改?
- 结构体内部若含 slice、map 或 pointer 字段,当前修改的是外层字段还是内部引用对象?
- 代码是否把“值副本”和“容器写回”混在了一起,导致读者无法判断结果落点?
可以把写法记成一句话:改字段就拿索引,改完整值就写回,元素是指针就确认共享对象。这比死记“range 不能修改元素”更准确,因为 range 本身可以拿到索引,也可以遍历指针元素;真正决定结果的是迭代值的类型和赋值落点。
相关问题
为什么 range 结构体里的 map 或 slice 字段有时又能改成功?
外层结构体被复制,但 map、slice 等字段通常携带指向底层数据的引用信息。修改这些字段指向的数据,可能影响原结构体共享的底层对象;如果给外层字段重新赋一个新 slice 或新 map,则仍然只改了副本。需要把“外层结构体复制”和“内部引用数据共享”分开判断。
把 item 改成指针就一定更好吗?
不一定。指针切片适合多个位置需要指向同一实体的模型;值切片更适合独立、可整体替换的数据。先按所有权和共享需求选类型,再决定循环写法。
只读遍历也要保留索引吗?
不需要。只读场景可以使用 for _, item := range users;只有需要定位原切片元素、原地修改或建立索引关系时,才保留 i。
参考:https://go.dev/ref/spec#For_statements_with_range_clause




