
我第一次把“调用者是谁”加进 Java 工具类时,直觉是读取异常堆栈,再从数组里猜一个位置。这个办法很快就遇到了两个问题:包装层一变,位置就跟着变;而且我真正需要的是调用者的 Class,不是一段已经格式化好的文本。现在更合适的做法是用 StackWalker.getCallerClass(),但创建 walker 时必须先保留类引用。
StackWalker.getInstance(Set.of(StackWalker.Option.RETAIN_CLASS_REFERENCE))配合getCallerClass()可以在工具方法里取得直接调用者的Class;如果只想看方法名、类名或行号,则用walk()读取StackFrame。
本文只讨论调用者类和调用栈帧的读取,不把它扩展成完整线程转储或 IDE 调试教程。官方 Java SE 25 API 说明,StackWalker 从 JDK 9 开始提供,并默认不保留 Class 引用。
先确认你要的是 Class,还是一条调用栈
“获取调用者”其实有两种需求。日志诊断通常需要类名、方法名和行号;插件工厂、资源加载器或策略路由则可能需要真正的 Class 对象。前者可以读取 StackFrame,后者应直接调用 getCallerClass()。
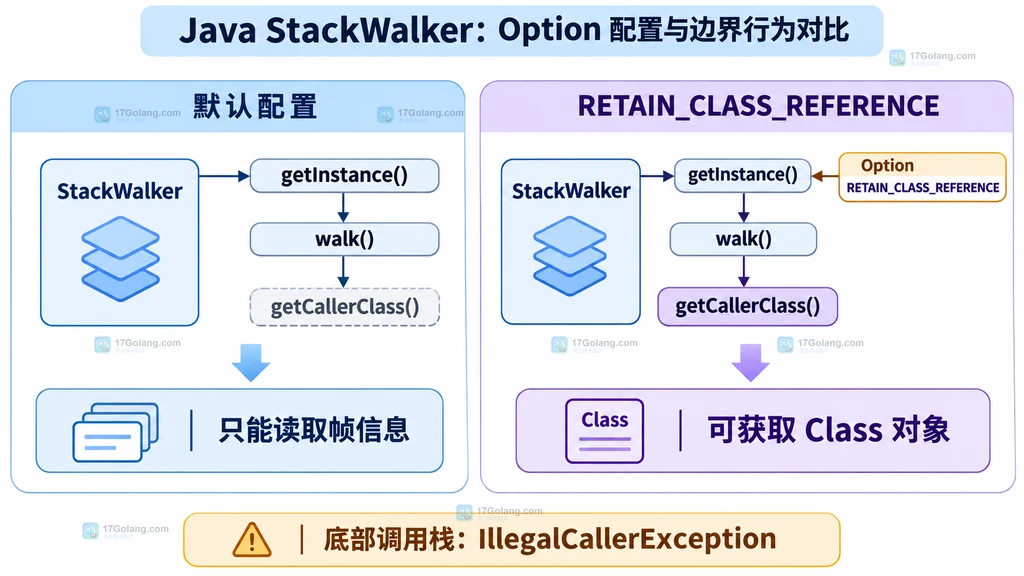
这一区分很重要:默认的 walker 能提供类名和方法信息,但不能把调用栈帧转换成可用的 Class 引用。为了拿到类对象,需要在创建时加入 RETAIN_CLASS_REFERENCE。
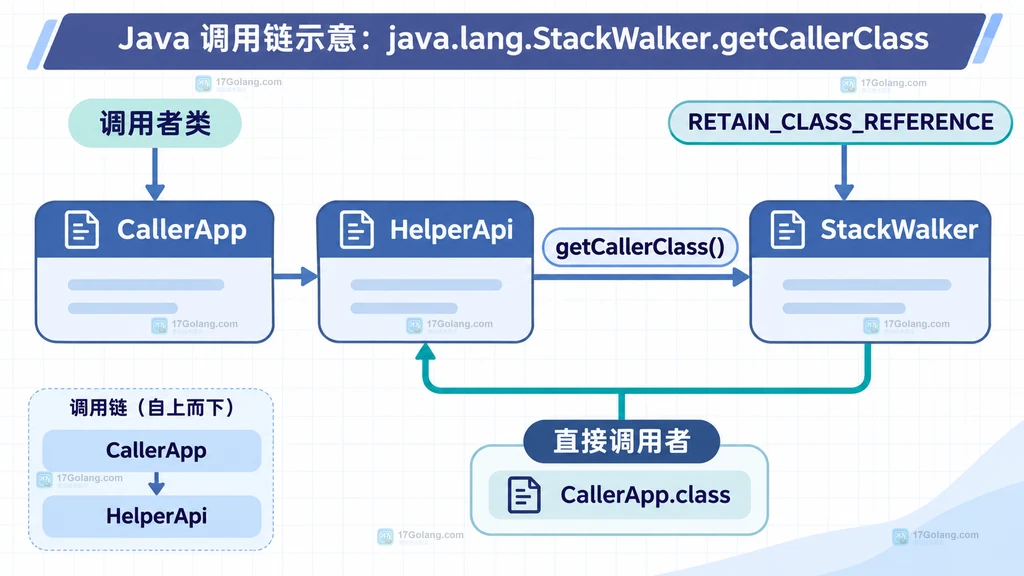
配置 RETAIN_CLASS_REFERENCE,再调用 getCallerClass
下面的工具类把 walker 设成成员变量,避免每次调用都重新创建配置。getCallerClass() 返回的是调用当前工具方法的那个类,而不是工具类自身。
import java.util.Set;

final class CallerType {
    // 在创建 walker 时保留 Class 引用,否则 getCallerClass() 不可用。
    private static final StackWalker WALKER = StackWalker.getInstance(
            Set.of(StackWalker.Option.RETAIN_CLASS_REFERENCE));

    private CallerType() {
        // 工具类不允许被实例化。
    }

    static Class directCaller() {
        // 返回直接调用 directCaller() 的类,而不是 CallerType。
        return WALKER.getCallerClass();
    }
}

public class Demo {
    public static void main(String[] args) {
        // Demo 调用工具方法,因此这里得到 Demo.class。
        Class caller = CallerType.directCaller();
        System.out.println(caller.getName());
    }
}
这段代码的关键不是 Set.of() 的写法,而是选项和调用位置。CallerType.directCaller() 被 Demo.main() 调用时,返回值是 Demo.class。如果再在中间加入一个代理方法,调用者也会变成那个代理方法所在的类,所以要先确定“直接调用者”是否就是业务真正想识别的对象。
默认配置为什么拿不到 Class 对象
我在排查这个问题时最容易忽略的是:StackWalker.getInstance() 的默认配置不是“信息完整但速度稍慢”,而是明确不保留类引用。此时调用 getCallerClass() 会因为配置缺少 RETAIN_CLASS_REFERENCE 而抛出 UnsupportedOperationException。
可以把两种配置理解成两个用途:默认配置适合读取轻量的帧信息;带类引用的配置适合需要继续调用反射、类加载器或类型判断的工具方法。不要为了一个日志类名就无条件保留 Class 引用。
只需要方法名时,用 walk 读取 StackFrame
如果目标是记录调用位置,没必要保留类对象。walk() 接收一个函数,在函数内部消费当前线程的帧流;它不会把一个可以长期保存的 Stream 交给调用方。
import java.util.Optional;

final class CallSite {
    private static final StackWalker WALKER = StackWalker.getInstance();

    static Optional firstExternalClass() {
        // 只在 walk 回调里消费帧流,避免回调返回后再次使用已关闭的流。
        return WALKER.walk(frames -> frames
                // 过滤掉工具包自己的实现类,留下外部调用方。
                .filter(frame -> !frame.getClassName().startsWith("com.example.internal."))
                // 只取第一个匹配帧,避免无界遍历整个调用栈。
                .map(StackWalker.StackFrame::getClassName)
                .findFirst());
    }
}
StackFrame 可以提供类名、方法名、文件名、行号等信息;如果开启了 DROP_METHOD_INFO,方法信息会被主动丢弃。读取帧时建议尽早 limit() 或 findFirst(),把诊断目标写清楚,而不是把整条栈都收集下来。
底部调用栈和隐藏帧要单独处理
getCallerClass() 适合在确实存在调用者时使用。如果工具方法已经处于当前线程调用栈的底部,例如由 Java 启动器直接调用的入口方法,官方 API 规定可能抛出 IllegalCallerException。这不是“没有找到类就返回 null”,调用方不能只做空值判断。
另外,反射 API、方法句柄和隐藏帧默认不会像普通业务帧一样出现在遍历结果中。若诊断场景确实需要它们,应显式了解 SHOW_REFLECT_FRAMES 或 SHOW_HIDDEN_FRAMES 等选项的影响,不能把帧数量当成绝对稳定的协议。
static Class callerOrNull() {
    try {
        // 只有“确实不存在调用者”的边界才转换为 null。
        return CallerType.directCaller();
    } catch (IllegalCallerException exception) {
        // 入口线程没有更外层调用者时,按业务约定记录并降级。
        return null;
    }
}
这个降级策略只适合调用者信息是可选元数据的情况。如果调用者类关系到权限、插件隔离或资源范围,就应该让异常继续向上交给明确的边界处理,而不是静默降级。
我的取舍:把调用者识别限制在工具边界内
StackWalker 让调用者识别比手动解析堆栈更直接,但它仍然依赖调用链形状。对我来说,最稳妥的用法是把它放在日志适配器、资源加载器或明确的工具 API 内,并在文档里写清“直接调用者”的定义。
| 目标 | 建议配置 | 关键边界 |
|---|---|---|
| 取得调用者 Class | RETAIN_CLASS_REFERENCE + getCallerClass() | 没有调用者时可能抛出 IllegalCallerException |
| 读取类名、方法名、行号 | 默认 walker + walk() | 帧流只在回调中有效 |
| 分析反射或隐藏帧 | 按需显式开启对应选项 | 结果不应假设为固定深度 |
一句话总结:需要类型对象时,在创建 walker 时保留类引用;只做调用位置诊断时,直接在 walk() 回调中读取 StackFrame。最后再检查入口线程、代理层和隐藏帧选项,避免把调用链偶然位置写成永久契约。
相关问题
StackWalker 是从哪个 JDK 版本开始提供的?
它从 JDK 9 开始提供。如果工程仍运行更早版本,需要采用其他调用栈诊断方式,并单独评估其位置稳定性。
getCallerClass 返回的是工具类本身吗?
不是。它返回调用当前工具方法的直接调用者类;如果中间多了一层代理,直接调用者也会随之变化。
为什么不直接使用 Throwable.getStackTrace?
异常堆栈更适合一次性记录文本或数组,StackWalker 则能按需遍历并直接返回 Class。若只需要错误现场文本,异常堆栈仍然可能更简单。




