
先说结论:bufio.Reader.Peek 适合做“先看一眼,再决定交给谁处理”的输入分发层。它不会推进读取位置,但返回的字节只在下一次读取前可靠;因此小工具应把 Peek 限定为识别动作,随后由具体解析器继续消费,长期保存的前缀则要主动复制。
官方地址:https://pkg.go.dev/bufio#Reader.Peek
Peek 适合解决哪类输入问题
当一个输入流可能是 JSON、文本或某种带固定前缀的协议时,直接调用解析器往往会把“识别”和“消费”揉在一起。Peek(n) 可以查看接下来的 n 个字节而不移动读取位置,让识别层先拿到少量信息,再决定后续处理方式。
这里有三个边界要先记住:
- Peek 只预览,不等于 Read;成功返回后,数据仍在 Reader 的当前位置。
- 返回切片会在下一次读取后失效,不能把它当成长期缓存。
- 请求的 n 大于 Reader 缓冲区容量时,可能得到
bufio.ErrBufferFull。
这三个条件正好对应小工具的三个职责:限制预览长度、立即完成判断、在必要时复制数据。
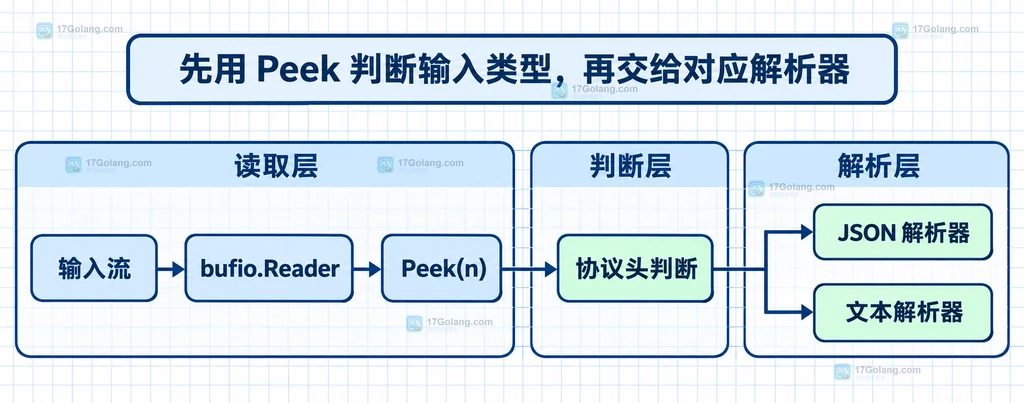
先用 Peek 判断输入类型,再交给对应解析器
一个简单的组合方式是只预览一个短前缀。比如,先跳过空白后判断是否以 { 或 [ 开始;如果是,就交给 JSON 解析器,否则按普通文本处理。判断层不负责读取完整正文,避免出现“为了识别先消费一遍、真正解析又读不到”的问题。
package main

import (
	"bufio"
	"bytes"
	"encoding/json"
	"fmt"
	"io"
	"strings"
)

// dispatch 根据固定前缀选择解析器,但不会在判断阶段消费输入。
func dispatch(r *bufio.Reader) (string, error) {
	// 预览长度只用于识别,避免一次请求过大的缓冲空间。
	prefix, err := r.Peek(32)
	if err != nil && err != bufio.ErrBufferFull && err != io.EOF {
		return "", err
	}
	trimmed := bytes.TrimSpace(prefix)
	if len(trimmed) == 0 {
		return "", io.EOF
	}

	if trimmed[0] == '{' || trimmed[0] == '[' {
		var value any
		// JSON 解码器从当前位置继续读,Peek 本身没有推进位置。
		if err := json.NewDecoder(r).Decode(&value); err != nil {
			return "", fmt.Errorf("解析 JSON: %w", err)
		}
		return "json", nil
	}

	// 文本分支读取一行,保留普通文本的换行语义。
	if _, err := r.ReadString('\n'); err != nil && err != io.EOF {
		return "", fmt.Errorf("读取文本: %w", err)
	}
	return "text", nil
}

func main() {
	// 用两个输入演示同一个分发入口的不同选择。
	for _, input := range []string{`{"name":"go"}`, "plain text\n"} {
		kind, err := dispatch(bufio.NewReader(strings.NewReader(input)))
		if err != nil {
			fmt.Println("error:", err)
			continue
		}
		fmt.Println(kind)
	}
}
示例里把 ErrBufferFull 和 io.EOF 单独看待:短输入并不一定是失败,真正影响分发的是当前能看到的有效前缀。若输入格式要求完整头部,应该把“前缀不足”升级为业务错误,而不是盲目落入文本分支。
把识别层和处理层拆成两个小接口
小工具一旦要接入多个调用点,建议让识别函数只返回类型,让处理函数负责消费。这样做的好处是:Peek 的生命周期规则集中在一处,JSON、文本等处理器可以独立替换,测试时也容易构造短输入和大输入。
| 组件 | 负责什么 | 不负责什么 |
|---|---|---|
| Reader | 缓冲底层 io.Reader | 不判断业务格式 |
| 识别器 | Peek 少量字节并返回类型 | 不消费完整正文 |
| 处理器 | 从当前位置读取并解析 | 不依赖失效的 Peek 切片 |
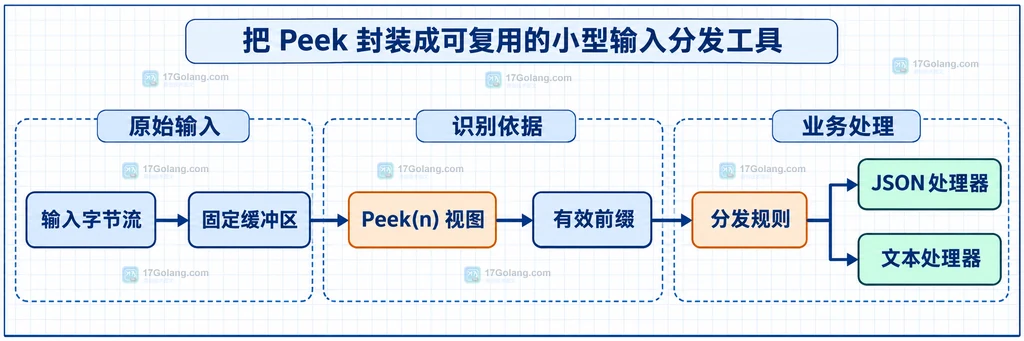
用固定缓冲区封装成可复用工具
bufio.NewReaderSize 可以把预览上限和工具的输入约定放在一起。下面的实现把识别前缀复制出来,再交给调用方使用,避免调用方在下一次读取后继续引用 Reader 内部缓冲区。
package peektool

import (
	"bufio"
	"bytes"
	"fmt"
	"io"
)

// Classify 读取少量前缀并返回类型;返回的 prefix 是独立副本。
func Classify(src io.Reader, previewSize, bufferSize int) (kind string, prefix []byte, err error) {
	if previewSize <= 0 || bufferSize <= 0 {
		return "", nil, fmt.Errorf("previewSize 和 bufferSize 必须为正数")
	}
	if previewSize > bufferSize {
		return "", nil, fmt.Errorf("previewSize 不能大于 bufferSize")
	}

	reader := bufio.NewReaderSize(src, bufferSize)
	peeked, peekErr := reader.Peek(previewSize)
	if peekErr != nil && peekErr != bufio.ErrBufferFull && peekErr != io.EOF {
		return "", nil, peekErr
	}
	// 复制后再返回,避免下一次读操作改写调用方持有的前缀。
	prefix = append([]byte(nil), peeked...)
	trimmed := bytes.TrimSpace(prefix)
	if len(trimmed) == 0 {
		return "empty", prefix, nil
	}
	if trimmed[0] == '{' || trimmed[0] == '[' {
		return "json", prefix, nil
	}
	return "text", prefix, nil
}
这段封装有一个实际取舍:它返回的是分类结果和前缀副本,并没有把内部 Reader 交给后续解析器。如果后续还要继续消费同一条流,应把 Reader 或一个带方法的对象作为工具内部字段保存,而不是只返回分类字符串。
几个容易踩到的边界
短输入不等于无效输入
当流在读到完整 n 个字节前就结束时,Peek 可能同时返回已有字节和错误。对于“只需识别第一个非空白字符”的工具,应该先处理已有字节;对于要求完整魔数或固定头的协议,则要明确要求长度,不要把部分头部当成合法输入。
Peek 之后不要依赖 UnreadByte
官方说明指出,最近一次调用 Peek 会影响 UnreadByte 和 UnreadRune 的可用条件。若工具需要回退语义,应该重新设计读取边界,而不是把 Peek 与回退操作随意串起来。
预览长度不能脱离缓冲区设计
当预览长度超过 Reader 的缓冲区容量时,ErrBufferFull 是明确的容量信号。固定协议头可以把容量设为略大于头部;不确定长度的内容则应考虑分块读取、io.ReadFull 或专门的解码器。
什么时候应该换成 Scanner 或直接读取
Peek 的价值在于“先识别再消费”。如果需求只是逐行读取文本,bufio.Scanner 通常更直接;如果需要精确读取固定字节数,io.ReadFull 更符合语义;如果解析器本身能够从 io.Reader 判断格式,就不必额外增加 Peek 层。
采用这类小工具时,可以观察三个指标:预览长度是否覆盖格式头、分类失败是否能区分短输入与真正的 I/O 错误、处理器是否从同一个读取位置继续消费。它们比单纯追求更大的缓冲区更能说明组合是否稳定。
常见问题
Peek 会不会让下一次 Read 少读一段?
不会。Peek 不推进读取位置,下一次读取仍从同一位置开始;但 Peek 返回的切片不能跨越下一次读取长期保存。
为什么 Peek 返回了字节还带着错误?
因为底层输入可能在提供完整 n 个字节前就结束或遇到错误。调用方应先判断已经拿到的字节是否足以完成当前识别,再决定是否传播错误。
预览 JSON 时应该 Peek 多长?
只为判断首个非空白字符时,不需要预览完整 JSON;把长度限制在足以覆盖格式头的范围即可。真正的 JSON 内容交给解码器从原位置读取。




