
Go utf8.ValidString 发现非法 UTF-8 后怎么安全替换
来源:17golang原创
时间:2026-11-05 11:31:17 226浏览 收藏
utf8.ValidString 返回 false 后,可以用 strings.ToValidUTF8 替换非法片段。先决定替换成什么,再保证替换字符串本身合法;如果原始数据还需要追溯,应另存原始字节。不要把所有 U+FFFD 字符直接删掉,因为它也可能是输入中正常存在的字符。
官方地址:https://pkg.go.dev/unicode/utf8
先定义基线:三个非法字节不等于三次替换
假设日志接收端允许以标记代替损坏文本,但不能误删用户已经输入的字符。待处理字符串是 A\xff\xfeB\xffC\uFFFD:其中 A、B、C 各占一个字节,三个非法字节分成两段,末尾的合法 U+FFFD 占三个字节,总长为九字节。这里的转义表示 Go 字符串字面量,不是把反斜杠和字母原样送入函数。
基线问题是:检测到无效编码,只说明原字符串不能完整按 UTF-8 解释,并不告诉我们原来的字符是什么。本文的假设是采用“每段非法内容留一个标记”的输出约定。strings.ToValidUTF8 的替换粒度是连续的非法 UTF-8 字节序列片段,因此相邻的 ff、fe 不会各获得一个独立标记,后面的单独 ff 则属于另一段。
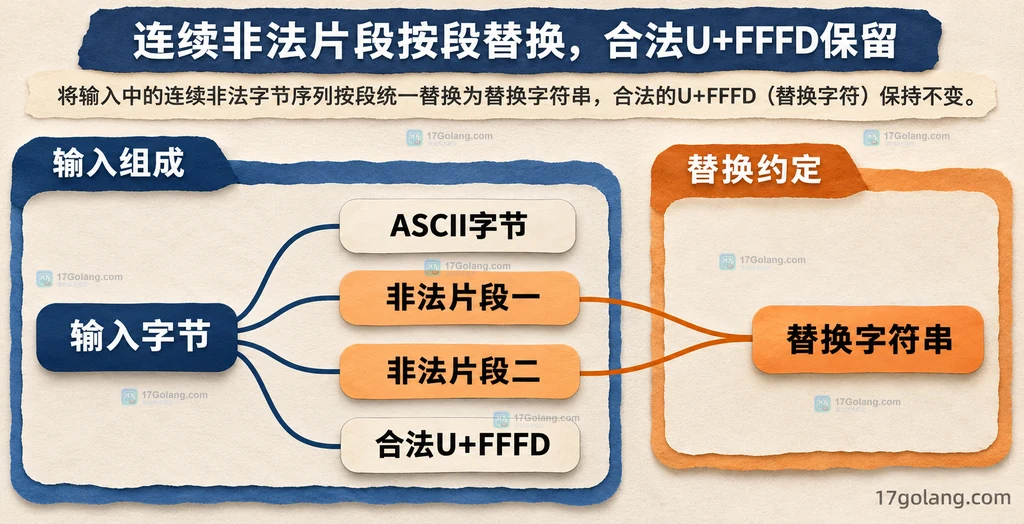
如果需求是逐个非法字节标记、按字段拒绝输入或恢复某个已知来源编码,需要另行定义处理方式。不能把这几个目标混成一句“自动修复乱码”。本例只讨论让给定字符串满足 UTF-8 合法性,以及这种替换会丢掉哪些信息。
把替换字符的合法性写进接口
修复函数的关键不是先调用 ValidString 再照搬结果,而是约束 replacement。Go 的 string 可以保存任意字节;如果把另一个非法字符串当作替换内容传进去,不能据此保证结果合法。下面先验证 replacement,再调用 ToValidUTF8。合法输入会保持内容,不必为了合法性额外做一次全量预扫描;需要单独记录有效性状态时,才按业务需求检测。
package main

import (
    "fmt"
    "strings"
    "unicode/utf8"
)

// Repair 要求替换内容本身也是合法 UTF-8。
func Repair(input, replacement string) (string, error) {
    if !utf8.ValidString(replacement) {
        return "", fmt.Errorf("replacement 不是合法 UTF-8")
    }
    return strings.ToValidUTF8(input, replacement), nil
}

// InvalidStats 统计非法字节数,以及连续非法片段数。
func InvalidStats(s string) (badBytes, badRuns int) {
    inBadRun := false
    for len(s) > 0 {
        r, size := utf8.DecodeRuneInString(s)
        bad := r == utf8.RuneError && size == 1
        if bad {
            badBytes++
            if !inBadRun {
                badRuns++
            }
        }
        inBadRun = bad
        s = s[size:]
    }
    return
}

func main() {
    // 最后的 U+FFFD 是合法字符,与前面的非法字节不同。
    input := "A\xff\xfeB\xffC\uFFFD"
    badBytes, badRuns := InvalidStats(input)
    fmt.Printf("input bytes=%d valid=%v badBytes=%d badRuns=%d\n",
        len(input), utf8.ValidString(input), badBytes, badRuns)

    // 分别观察保留标记、短标记和删除的效果。
    for _, replacement := range []string{"\uFFFD", "?", ""} {
        output, err := Repair(input, replacement)
        if err != nil {
            fmt.Println(err)
            continue
        }
        fmt.Printf("replacement=%q result=%q bytes=%d valid=%v\n",
            replacement, output, len(output), utf8.ValidString(output))
    }
}
代码中的 InvalidStats 只是为了把示例指标说清楚,不是 ToValidUTF8 的必要前置条件。生产接口可仅保留 Repair,把计数留在确实需要审计的入口,避免为了展示指标反复扫描大字符串。这里展示的是完整代码示例,未编译执行,也没有采集性能数据。
用同一份输入比较替换与删除
衡量这次改动是否符合约定,可以比较输入字节数、非法片段数、输出字节数和输出合法性。下面按示例字面量推导;它衡量的是替换语义,不是吞吐量或内存分配。相同输入应使用相同指标,不能只凭终端看起来没有乱码就认为内容保存完整。
| 替换内容 | 可见结果 | 输出字节数 | 保留的含义 |
|---|---|---|---|
| U+FFFD | A�B�C� | 12 | 两段损坏各留一个标记,原有 U+FFFD 仍在 |
| 问号 ? | A?B?C� | 8 | 标记较短,但问号也可能与正常内容混淆 |
| 空字符串 | ABC� | 6 | 丢弃两段损坏内容,保留其余合法字符 |
第一行变长是正常现象:两个替换标记各占三个字节,另有三个 ASCII 字节和原本的三字节 U+FFFD,合计十二。删除后也不是三个字节,因为原来的合法 U+FFFD 并未删除。以上三种 replacement 都合法,因此输出能够按 UTF-8 解释。
如果改用三个 ASCII 字节组成的 [?],输出长度同样是十二,但输出的 Unicode 码点数量不同。字节数、码点数量、用户看到的字符数量不是同一个指标。长度配额若按字节计算,应在替换后重新应用配额;不要先截断字节再假设编码仍然合法。
需要逐字节定位时再读取 RuneError
RuneError 并不单独代表输入损坏。DecodeRuneInString 对非空的非法起始编码返回 RuneError 和宽度一,而合法编码的 U+FFFD 返回相同码点、宽度三。代码把两个条件一起判断,才能保留末尾那个正常字符。循环只在字符串非空时进入,也避开了空输入返回宽度零的情况。
inBadRun 用来合并相邻非法字节:遇到一个合法码点,就结束当前非法片段。这个计数与本文所讨论的连续片段替换相对应。如果要记录偏移,可另加累计字节偏移,但日志不应直接输出整份敏感原文;可保存受控的原始记录引用,让统计与原文分开管理。
也不要把 string([]rune(input)) 当成完全相同的策略:对连续非法字节逐次解码产生的替换字符,可能与 ToValidUTF8 按连续片段只放一个标记的结果不同。选择 API 时应先写清替换粒度,尤其是下游把标记数量当作损坏次数时。
替换之后仍要保留业务边界
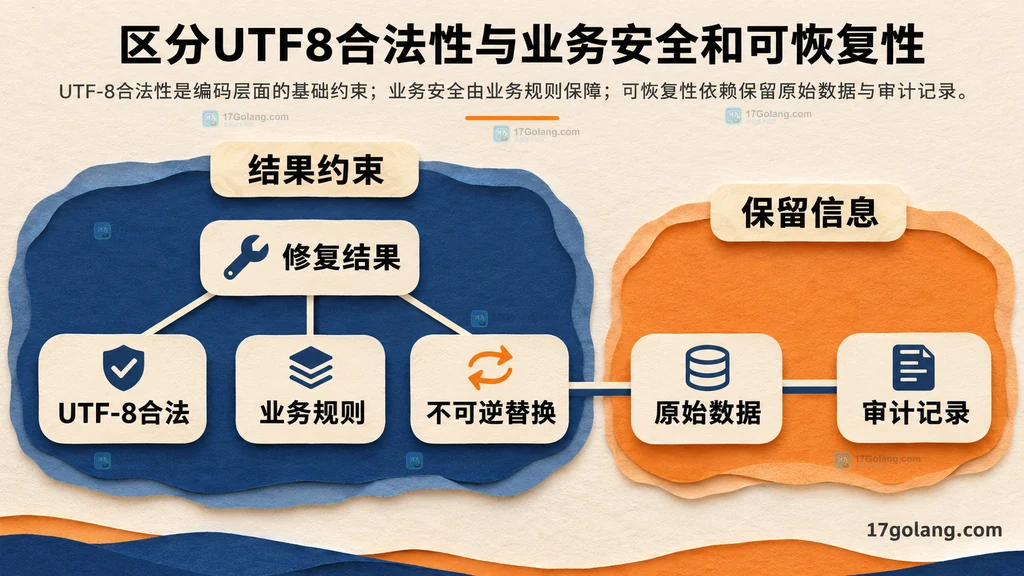
这里的“安全替换”有明确边界:结果编码合法,不等于恢复原文,也不等于已经满足 HTML 输出、文件路径、标识符或业务字段的安全要求。用户名、签名材料、协议字段等场景,静默替换可能改变身份或消息含义,入口直接拒绝往往更符合契约。展示性文本则可以选择显式标记,并向调用方返回是否发生替换。
如果原始字节需要复盘,先保留原始版本或受控引用,再生成展示版本;不能指望从替换后的字符串推回 ff 与 fe。若本来就要求拒绝无效输入,直接根据 ValidString 的结果返回业务错误即可,不必为了“修复”增加不可逆变更。
因此,这次改动的比较结论是:按连续片段替换可以得到稳定的标记数量,而合法 U+FFFD 不受影响;选择空串会失去损坏位置提示。实际落地应把 replacement、长度限制、原文保留与拒绝策略写成明确接口约定。
-
502 收藏
-
502 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
203 收藏
-
466 收藏
-
163 收藏
-
145 收藏
-
455 收藏
-
157 收藏
-
341 收藏
-
254 收藏
-
353 收藏
-
207 收藏
-
122 收藏
-
421 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习