
MySQL table_io_waits_summary_by_table 怎样看表级 I/O 等待
来源:17golang原创
时间:2026-11-05 18:43:04 405浏览 收藏
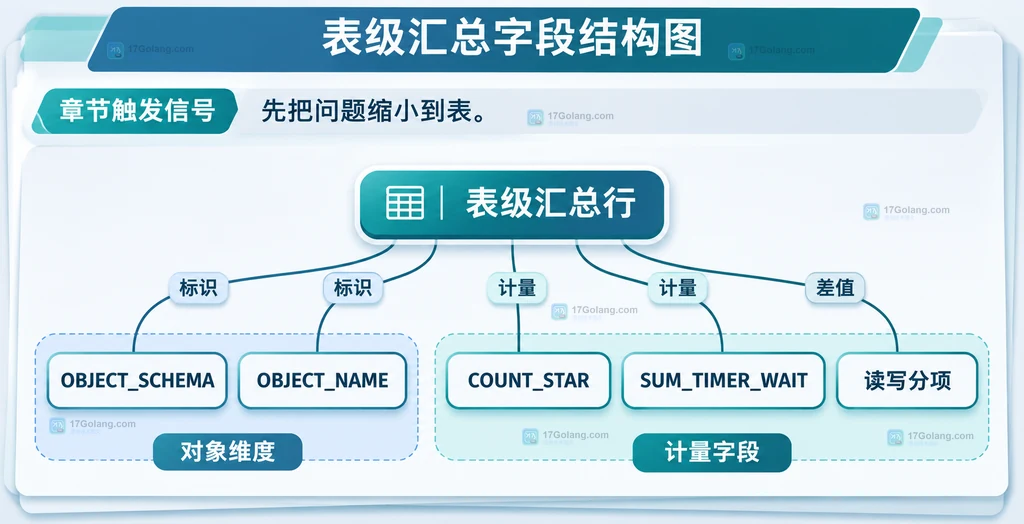
读取 MySQL table_io_waits_summary_by_table 时,先用 OBJECT_SCHEMA 和 OBJECT_NAME 确定表,再看 COUNT_STAR、SUM_TIMER_WAIT,以及读写分项。原始时间以皮秒表示,除以 10 的 12 次方换算为秒。它汇总的是表访问事件,不等于磁盘读写耗时,也不能单独证明某个索引或 SQL 就是瓶颈。
官方地址:https://dev.mysql.com/doc/refman/8.4/en/performance-schema-table-wait-summary-tables.html
触发信号:先把问题缩小到表
遇到数据库访问变慢、但暂时没有明确 SQL 线索时,我会把这张表作为定位入口:先观察哪些业务表贡献了较多的访问耗时,再决定深入哪个对象。这是一种排查取舍,不是本文已经处理过某次生产事故的经历。以下以 MySQL 8.4 为说明范围,SQL 是原创只读示例,未在本机执行。
采集来源是 wait/io/table/sql/handler。对象维度包括 OBJECT_TYPE、OBJECT_SCHEMA、OBJECT_NAME;同名表分属不同库时,不能只按表名合并。COUNT_STAR 是被采集操作的计数,不是 SQL 条数;一次语句可能产生多次表访问。即使数据在内存中完成访问,也不能据此把表访问事件直接解释成物理磁盘 I/O。
快速判断:按累计耗时列出候选表
-- 只读观测;将 app_data 换成业务库名,原始计时按皮秒换算。
SELECT OBJECT_SCHEMA, OBJECT_NAME,
       COUNT_STAR, COUNT_READ, COUNT_WRITE,
       ROUND(SUM_TIMER_WAIT / 1000000000000, 3) AS total_seconds,
       ROUND(SUM_TIMER_READ / 1000000000000, 3) AS read_seconds,
       ROUND(SUM_TIMER_WRITE / 1000000000000, 3) AS write_seconds,
       ROUND(AVG_TIMER_WAIT / 1000000000, 6) AS avg_ms
FROM performance_schema.table_io_waits_summary_by_table
WHERE OBJECT_SCHEMA = 'app_data'
  AND COUNT_STAR > 0
ORDER BY SUM_TIMER_WAIT DESC
LIMIT 20;
total_seconds 用来比较当前累计统计中的耗时贡献;avg_ms 体现被计时事件的平均耗时尺度。计时关闭或计时覆盖不一致时,平均值的解释也需要相应收窄。不要把“总耗时大”直接写成“单次访问很慢”:高频正常访问也可能累积到很大的总量。
COUNT_READ 对应 fetch 类操作,COUNT_WRITE 汇总 insert、update、delete 类操作;COUNT_FETCH、COUNT_INSERT、COUNT_UPDATE、COUNT_DELETE 可以进一步拆开。不要把 MAX_TIMER_WAIT 当成某条 SQL 的完整最大延迟。表级统计没有携带能够直接定位单条语句的 SQL 文本。
| 观察项 | 适合回答 | 不能直接推导 |
|---|---|---|
| 累计总耗时 | 哪些表贡献较多 | 当前窗口仍然最忙 |
| 访问次数 | 访问量的大致分布 | 执行了多少条 SQL |
| 读写分项 | 主要来自读还是写 | 磁盘读写字节数 |
处理步骤:用两次快照看当前窗口
-- 在窗口开始、结束各执行一次;保存全部目标行,不能先截取各自的 Top 20。
SELECT NOW(6) AS sampled_at, @@server_uuid AS server_id,
       OBJECT_TYPE, OBJECT_SCHEMA, OBJECT_NAME,
       COUNT_STAR, SUM_TIMER_WAIT
FROM performance_schema.table_io_waits_summary_by_table
WHERE OBJECT_SCHEMA = 'app_data';
在外部采集器里保存两个时点的数据,并记录实例身份与窗口起止时间。按实例、OBJECT_TYPE、OBJECT_SCHEMA、OBJECT_NAME 对齐后,用结束值减去开始值:窗口次数为 ΔCOUNT_STAR,窗口累计秒数为 ΔSUM_TIMER_WAIT / 1000000000000。只在采集条件一致且计时覆盖合适时,再以窗口计时增量除以对应事件次数讨论平均耗时。
例如纯算术演示中,若两次计数差为 400、计时差为 2000000000000 皮秒,那么窗口累计为 2 秒;在全部对应事件均计时的前提下,平均为 5 毫秒。这不是实测数据,也不表示一条 SQL 耗时 5 毫秒。多个线程的事件累计时间可以超过采样窗口的墙钟时长。
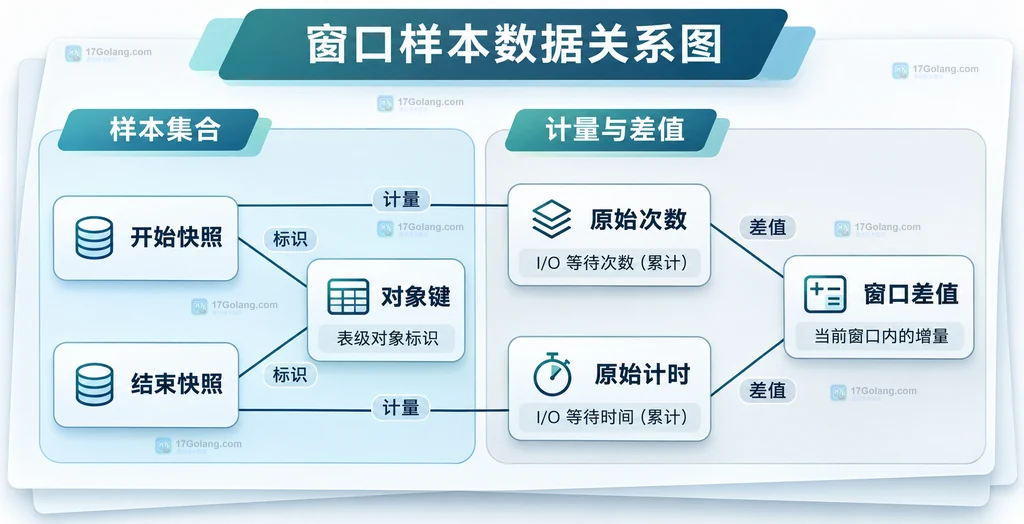
两次快照期间若重启、统计被清零或对象发生重建,就不能把它们当作连续计数。同名不保证同一个对象生命周期;不能仅凭差值非负就保证样本有效。缺少任一端的行应标为不可比较,计数回退也应重新建立基线,不要把负值强行改成零来掩盖变化。
结果为空或时间为零时怎样处理
-- 仅查看采集与计时开关,不在故障处理中直接修改配置。
SELECT NAME, ENABLED, TIMED
FROM performance_schema.setup_instruments
WHERE NAME = 'wait/io/table/sql/handler';
ENABLED 与 TIMED 分别涉及采集和计时。若计时没有开启,有次数而时间不可用于判断速度,并不意味着所有访问都瞬间完成。还要考虑对象过滤、当前实例是否确有业务访问,以及账号能否读取目标统计。不要为了获得一份表格,在值班时顺手放开全部采集配置。
本文查询不修改业务数据,无需业务回滚;退出采样即可停止这些查询。若另外调整了采集配置,应在变更记录中保存原值并按原值恢复。不要把 TRUNCATE 当作日常采样起点:官方说明它会清零该汇总,并影响对应的索引使用汇总,可能打断其他人的观测窗口。
告警确认与复盘记录
我倾向把告警写成“某实例某窗口内某表的访问耗时贡献上升”,同时附上访问次数、采集开关和统计重置情况,而不是使用一条跨业务通用的慢表阈值。需要判断性能是否改善,应对齐相近业务量和同样采集条件的窗口,不能只看累计值继续增长。
复盘至少保留实例标识、对象键、采样起止、原始计数和计时、窗口差值、配置变化及尚未确认的假设。下一步可以结合语句摘要、执行计划或存储层指标继续定位,但本表本身不提供充分的索引修改依据。
可以把全部表耗时相加当数据库响应时间吗?
不可以。并发事件会累计,表访问事件也不代表客户端端到端延迟。
只保留每次查询的前二十名够吗?
不适合严谨的窗口差值:一个对象可能只进入某次榜单。应保存完整目标范围,先对齐求差,再排序。
技术依据:MySQL 表级等待汇总说明与事件计时说明。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
420 收藏
-
286 收藏
-
112 收藏
-
486 收藏
-
500 收藏
-
394 收藏
-
177 收藏
-
171 收藏
-
238 收藏
-
262 收藏
-
347 收藏
-
501 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习