
PyTorch DataLoader 怎样复用持久 worker
来源:17golang原创
时间:2026-11-06 16:54:46 440浏览 收藏
训练脚本每个 epoch 都重新创建 DataLoader 时,真正耗时的往往不是取一个 batch,而是 worker 进程反复启动、初始化 Dataset 和建立数据源状态。需要跨 epoch 复用它们时,做法是把 DataLoader 放在 epoch 循环外,并设置 persistent_workers=True:
from torch.utils.data import DataLoader

# Dataset 只负责描述样本读取逻辑,worker 数量需要大于 0
train_loader = DataLoader(
    train_dataset,
    batch_size=64,
    num_workers=4,
    persistent_workers=True,
    prefetch_factor=2,
    pin_memory=True,
)

for epoch in range(epochs):
    # 每轮复用同一个 DataLoader,不在这里重复构造 worker
    for inputs, targets in train_loader:
        inputs = inputs.to(device, non_blocking=True)
        targets = targets.to(device, non_blocking=True)
        loss = train_step(inputs, targets)
这个参数的语义是:多进程数据加载器耗尽一次迭代后,不立即关闭 worker 进程。下一轮重新迭代同一个 DataLoader 时,worker 可以继续工作。它不是把 batch 永久缓存下来,也不会让不同 epoch 自动共享错误的样本顺序;随机采样器和 Dataset 的逻辑仍然决定每轮取什么数据。
persistent_workers=True只对多进程加载有意义,先保证num_workers>0。- DataLoader 要在 epoch 循环外创建,反复创建对象会抵消持久 worker 的收益。
- 持久化会延长 Dataset 副本、文件句柄和内存的生命周期,训练结束时要释放迭代器与资源。
持久 worker 到底复用了什么
可以把一次训练输入拆成三层:主进程中的 DataLoader、worker 内的 Dataset 副本,以及预取队列。默认情况下,多进程迭代结束后 worker 会退出;开启持久化后,worker 和它们持有的 Dataset 副本留在内存中,下一次迭代只需要重新发送索引并继续填充队列。
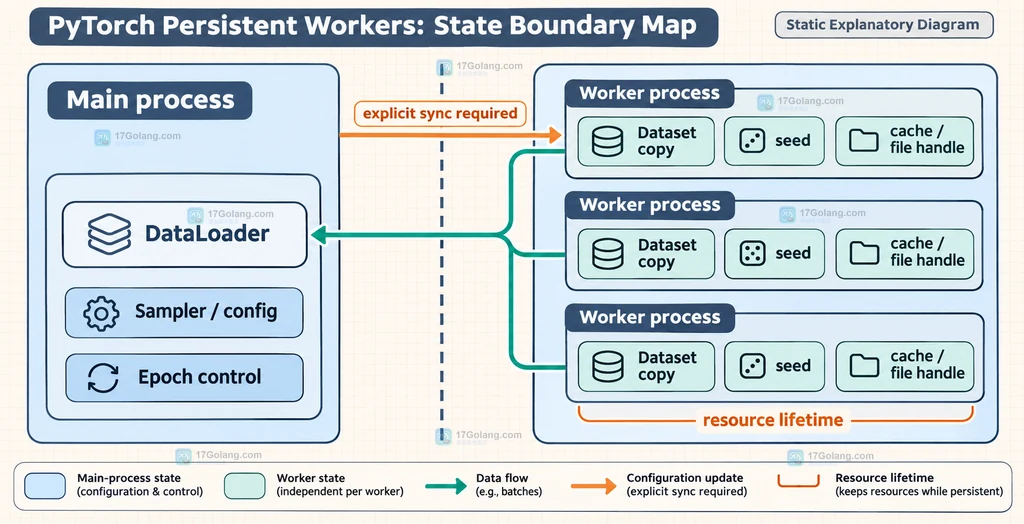
因此它最适合“Dataset 初始化有成本、epoch 较多、DataLoader 长时间复用”的训练任务。若 num_workers=0,数据读取就在主进程完成,不存在需要持久化的 worker;若每轮都写 DataLoader(...),也就没有真正复用同一组进程。
怎样把 worker 状态管理得可控
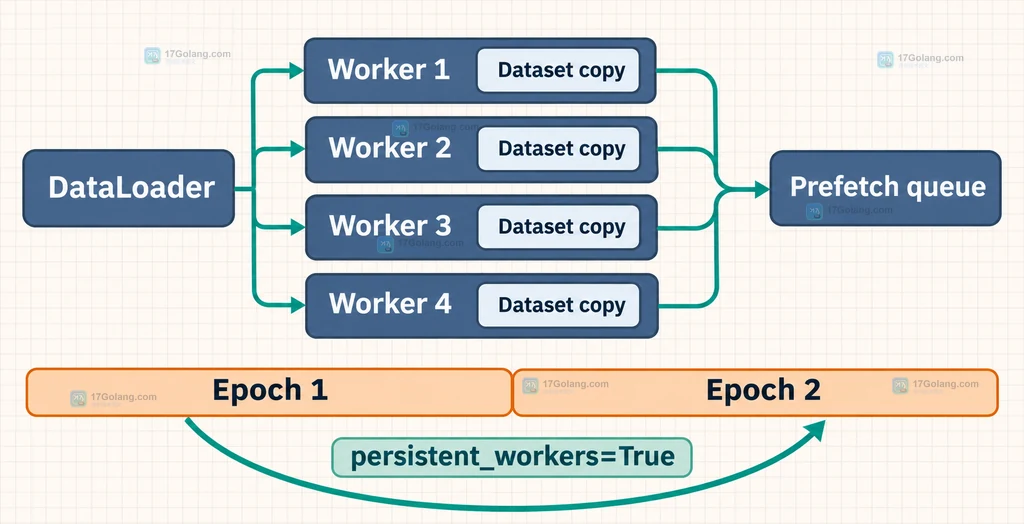
持久化最容易踩的坑不是参数拼写,而是把一次性状态误当成每轮都会重建的状态。例如 Dataset 在 worker 内打开文件、保存随机数生成器,或者缓存了会变化的配置。可以通过 get_worker_info() 区分 worker,并在初始化时建立明确的副本状态:
import random
import torch
from torch.utils.data import get_worker_info

def init_worker(worker_id):
    # 每个 worker 使用独立种子,避免持久化后长期复用同一随机序列
    info = get_worker_info()
    seed = info.seed if info is not None else torch.initial_seed()
    random.seed(seed)

def build_loader(dataset):
    # 只在多进程模式下启用持久 worker
    workers = 4
    return DataLoader(
        dataset,
        num_workers=workers,
        persistent_workers=(workers > 0),
        worker_init_fn=init_worker,
    )
需要注意,worker 中的 Dataset 副本不是主进程对象的实时镜像。主进程在 epoch 中途修改 Dataset 属性,不能假定所有 worker 立即看到;需要变化的配置应通过可序列化参数、每轮重建 Dataset,或显式的进程间通信传递。持久 worker 的收益来自复用,不等于自动同步状态。
参数选择和关闭边界
prefetch_factor 控制每个 worker 预取的 batch 数,worker 数和 batch 预取量越大,吞吐潜力越高,但主机内存也会增加。pin_memory=True 适合需要把 CPU batch 更快拷贝到 CUDA 设备的场景,但它不会替代持久 worker,也不会解决 Dataset 本身的慢 I/O。
| 场景 | 建议 | 原因 |
|---|---|---|
| 训练多个 epoch,Dataset 初始化昂贵 | 启用持久 worker | 减少反复启动与初始化成本 |
| 单进程调试或 num_workers=0 | 关闭 | 没有子进程可复用,调试更直接 |
| Dataset 持有大缓存或文件句柄 | 谨慎启用 | 生命周期变长,内存和资源释放更晚 |
训练结束或需要切换完全不同的数据源时,不要把“进程仍在”误认为成功。应让 DataLoader 生命周期结束,必要时显式删除迭代器并等待资源回收;长时间运行的服务还要观察 worker 数量、RSS、文件描述符和队列等待时间。如果持久化后吞吐没有改善,优先比较 worker 启动时间、Dataset 初始化时间和真实 I/O,而不是继续盲目增加 num_workers。
常见问题
persistent_workers=True 能和 num_workers=0 一起用吗?
不能把它当作主进程模式的开关。持久 worker 依赖多进程加载,实际使用时应设置 num_workers>0;调试阶段可以关闭持久化并使用单进程。
每个 epoch 重新创建 DataLoader 还能复用 worker 吗?
通常不能达到预期。应复用同一个 DataLoader;反复创建对象会重新建立迭代器和 worker 生命周期,抵消参数价值。
持久 worker 会让每轮拿到完全相同的数据吗?
不会。worker 是否存活与采样顺序是两件事,采样器、随机种子和 Dataset 的取样逻辑仍决定数据顺序;需要保证可复现时,应单独设计随机状态。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
426 收藏
-
177 收藏
-
123 收藏
-
218 收藏
-
435 收藏
-
456 收藏
-
157 收藏
-
153 收藏
-
172 收藏
-
325 收藏
-
322 收藏
-
384 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习