
云原生平台开始强调端到端 AI 工作流,核心原因不是 Kubernetes 要取代模型框架,而是 AI 系统一旦进入生产,真正困难的部分会从“把模型跑起来”转向“让数据、训练、模型发布、推理和运维形成一条可追踪的链路”。孤立的 Notebook、单独的 GPU 集群和临时推理服务,很难同时满足交付速度、成本控制与治理要求。
端到端 AI 工作流的本质,是把 AI 生命周期中反复出现的资源、产物、权限和运行状态,纳入平台可以复用和审计的工程路径。它不要求所有工具来自同一家厂商,也不意味着所有团队都要一次性建设完整 MLOps 平台。
官方资料入口:https://www.cncf.io/announcements/
本文引用的 CNCF 公告:https://www.cncf.io/announcements/2026/08/17/cncf-announces-kubeflows-graduation-solidifying-the-standard-for-cloud-native-ai-operations/
先分清:端到端不是把所有东西塞进 Kubernetes
传统应用平台通常围绕源码、镜像、配置和服务运行状态组织能力;AI 系统还多了一组持续变化的对象:数据集版本、特征或上下文、实验参数、检查点、模型制品、推理路由、提示词版本和评估结果。模型本身只是链路中的一个产物,不能单独代表系统是否可用。
因此,“端到端”更适合被理解为责任边界,而不是产品边界。数据处理可以由专门的批处理系统完成,训练可以使用适合加速器的框架,模型服务可以由推理引擎承担,云原生平台负责把这些阶段连接起来,并统一处理资源、身份、交付、观测和回滚。
这也是平台团队需要关注的分界线:平台提供稳定的黄金路径,算法团队保留模型和实验选择,业务团队只面对与场景相关的输入输出。平台不应替业务团队决定模型质量,也不应把所有 AI 工具包装成一个无法替换的黑盒。
为什么这类需求现在集中出现
CNCF 与 SlashData 在 2026 年第一季度的平台工程调研中,把工作流自动化、应用交付、安全与策略管理放在同一组观察范围内。公告显示,35% 的受访组织采用混合平台来承载 AI 工作负载,说明不少团队正在把既有开发平台与专用 AI 工具组合起来,而不是另起一套完全隔离的基础设施。
这背后有四个非常具体的变化。
资源从“申请一台机器”变成“调度一组任务”
训练、批量推理和多副本服务对 GPU、显存、拓扑、队列和优先级的要求不同。一个 Pod 能否启动,不等于一组互相协作的任务已经获得了合适资源。Kubernetes 官方文档也把工作负载级调度和 PodGroup 作为机器学习、批处理等多 Pod 场景的重要方向。
成本从节点账单扩展到模型运行结果
AI 平台不仅要回答“用了多少 CPU 和 GPU”,还要把冷启动、批处理等待、吞吐、延迟、缓存命中和每次请求的模型消耗联系起来。没有这层关联,团队很容易只优化集群利用率,却无法解释一次推理成本为什么上升。
交付对象从镜像变成可回溯的模型版本
应用发布通常围绕镜像标签和配置变更;AI 发布还要知道模型由哪份数据、哪次训练、哪组参数和哪次评估产生。只有把这些信息作为发布产物的一部分,灰度、回滚和事故复盘才不会依赖个人记忆。
治理从服务权限扩展到数据和模型生命周期
模型服务需要身份、网络策略和密钥管理,训练数据与模型制品又有独立的访问范围。平台把权限、审计、供应链和观测放到同一条工作流中,才能避免“训练阶段无人管、上线阶段突然补安全”的断层。
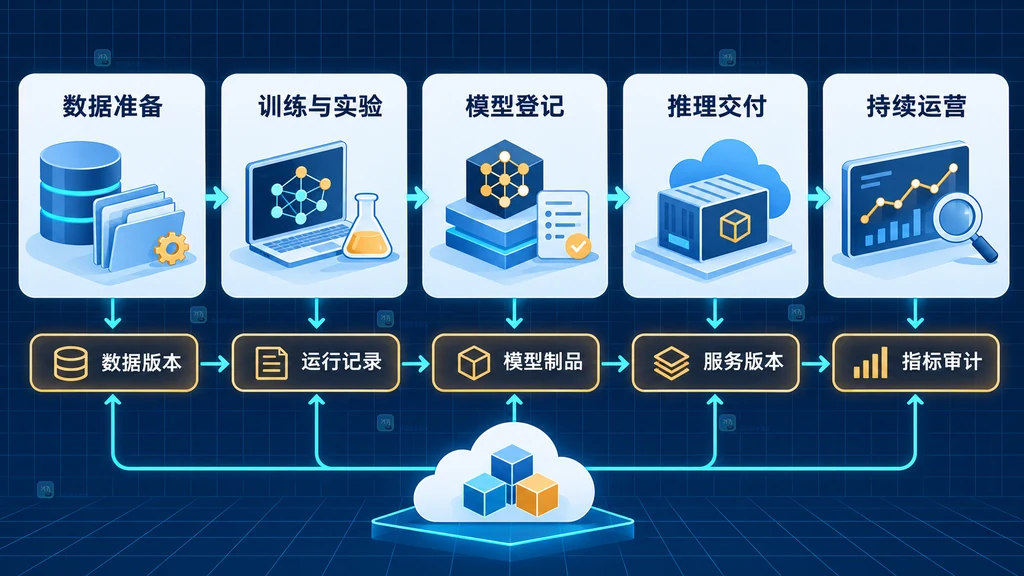
一条完整 AI 工作流应该交付什么
可以用“输入—动作—输出—检查点”来判断一个平台是否真的覆盖了生命周期,而不是只提供了一个 AI 菜单。
| 阶段 | 关键动作 | 必须留下的产物 | 平台检查点 |
|---|---|---|---|
| 数据准备 | 导入、清洗、切分与版本记录 | 数据版本、权限和质量指标 | 来源可追溯、访问可审计 |
| 实验与训练 | 提交任务、分配加速器、保存参数 | 运行记录、日志和检查点 | 队列、配额、失败重试可控 |
| 模型登记 | 关联数据、代码、评估和制品 | 模型版本与评估结果 | 版本能够复现并支持审批 |
| 部署与推理 | 发布服务、路由流量、控制副本 | 服务版本、配置和路由记录 | 延迟、吞吐、资源和回滚可见 |
| 持续运营 | 观察漂移、成本、异常与反馈 | 指标、告警和改进任务 | 能把线上问题关联到模型版本 |
这张表的重点不是要求每个团队立刻购买五套工具,而是提醒评估者:如果一条流程只覆盖“部署一个推理容器”,它解决的是服务上线问题,还不能称为端到端 AI 工作流。
平台团队可以怎样拆解职责
较稳妥的做法是先建立一条小而完整的黄金路径,再根据真实任务补能力。下面的声明式示意只表达职责关系,不代表某个厂商的固定配置:
workflow:
  # 让每次运行都能关联到数据、代码和模型版本
  identity:
    dataset: "dataset-version"
    source_revision: "git-revision"
    model_artifact: "registry-entry"
  # 把训练与推理的资源边界交给平台策略统一管理
  resources:
    queue: "team-ai"
    accelerator: "gpu"
    policy: "quota-and-priority"
  # 发布前后都保留可观察的检查点
  delivery:
    evaluation_gate: "required"
    rollout: "canary"
    rollback: "previous-model"
  # 线上指标要能回连到工作流和模型版本
  operations:
    metrics: ["latency", "throughput", "cost"]
    audit: "enabled"
这里最重要的字段不是某个具体工具名,而是关联关系:数据版本要能追到训练运行,训练运行要能追到模型制品,模型制品要能追到服务版本,服务指标又要能反向定位到这次发布。缺任何一环,故障处理都会退化为人工拼日志。
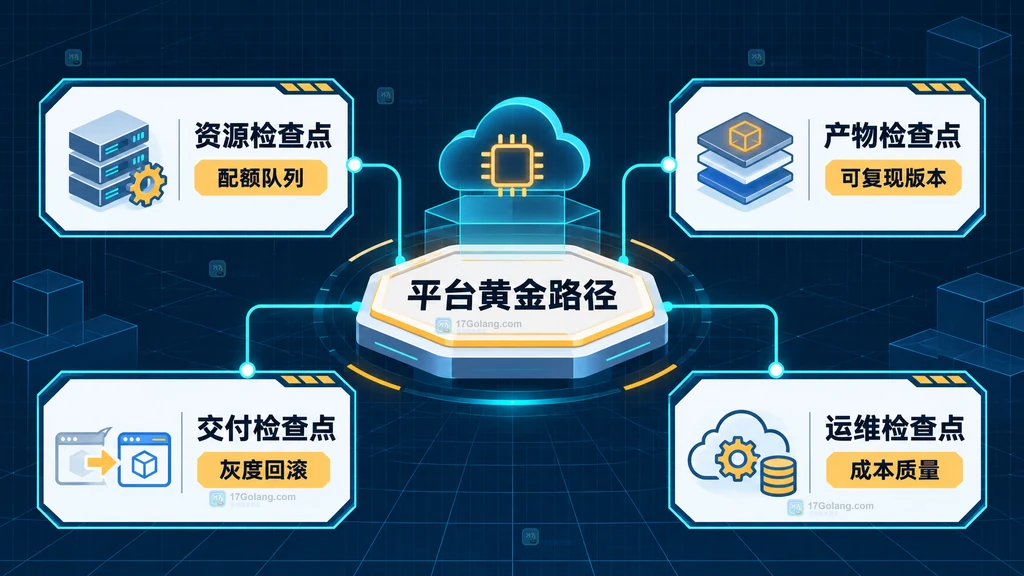
评估现有平台时先看四个检查点
一看资源检查点是否覆盖 AI 任务形态
不要只问平台能不能申请 GPU。还要问它能否表达队列、优先级、配额、多 Pod 协同、失败重试和不同工作负载的隔离。训练任务排队时间过长,或者推理服务与批处理相互抢占,说明资源层还没有形成工作流视角。
二看产物检查点能否形成链路
最低要求是数据、代码、运行、模型和服务都有稳定的版本标识,并且发布记录能把它们关联起来。只保存镜像地址而不保存训练来源,会让“能部署”与“能复现”之间出现明显落差。
三看交付检查点是否支持渐进发布
模型服务也需要类似应用交付的灰度、回滚和策略控制,但判断指标不能只看 HTTP 成功率。延迟、吞吐、错误类型、资源消耗和业务评估结果都应该进入发布决策;对于高风险场景,还应保留人工审批。
四看运维检查点能否把成本和质量放在一起
平台仪表盘应当同时显示基础设施指标与模型指标。一次延迟上升可能来自显存不足、队列拥塞、模型切换或输入长度变化,只有把请求、资源和模型版本关联起来,团队才有机会作出正确取舍。
更现实的落地顺序:先服务,再批处理和训练
对已经有 Kubernetes 或内部开发平台的团队,建议把第一条路径收窄到一个明确场景,例如把一个稳定模型以可观测服务形式上线。先打通镜像、模型制品、配置、指标和回滚,再引入批量推理;训练编排、数据版本与跨环境调度可以在已有需求出现后补齐。
这样做的好处是每一步都有真实反馈。服务阶段能暴露路由、资源和观测问题;批处理阶段会暴露队列、重试和成本问题;训练阶段再处理加速器协同、检查点和实验追踪。若一开始就追求“覆盖所有 AI 生命周期”,很容易得到一个功能很多但没有稳定使用路径的平台。
CNCF 在 2026 年 8 月宣布 Kubeflow 毕业时,强调它已经从早期的单一机器学习组件集合,发展为覆盖数据处理、模型开发、训练和服务的 AI 原生平台。这一变化说明行业关注点正在从“能否把 AI 放进容器”转向“能否把生产级 AI 的重复工作做成可组合能力”,但并不意味着所有组织都必须照搬完整方案。
三个容易误读的地方
- 端到端不等于单一厂商。平台应当通过接口、制品和策略连接不同工具,保留替换训练框架、推理引擎或存储系统的空间。
- AI 工作流不等于提示词串联。生产系统仍然需要数据权限、资源调度、版本管理、观测、回滚和事故处理,这些工作不能由一个提示词编排器替代。
- Kubernetes 不负责模型质量。它能帮助统一运行和调度边界,但数据质量、评估方法、业务指标和人机协作仍需要领域团队负责。
总结:平台竞争会转向“少让团队重复造轮子”
云原生平台强调端到端 AI 工作流,是因为 AI 生产化把多个原本分散的工程问题叠加到了一起:加速器资源、模型制品、推理交付、观测、成本和治理必须彼此关联。平台的价值不是替代所有上层工具,而是提供一条稳定、可追踪、可回滚的路径。
如果要判断一个方案是否值得采用,可以先问四个问题:资源是否按任务协同调度?产物是否可复现?发布是否支持灰度和回滚?线上成本与质量是否能回到模型版本?能回答清楚这四点,才算真正理解了“端到端”的工程含义。
相关问题
云原生平台和 MLOps 平台有什么区别?
云原生平台更关注通用运行、交付、资源和治理底座,MLOps 平台更关注数据、实验、训练、模型登记与评估。两者可以通过工作流和制品接口组合,不必互相替代。
小团队需要一开始建设完整 AI 平台吗?
通常不需要。优先选择一个真实推理或批处理场景,打通版本、指标和回滚,再根据重复出现的任务扩展训练与数据能力。
为什么只部署一个模型服务还不算端到端?
因为服务只代表生命周期中的一个阶段。若无法知道模型来自哪份数据、如何评估、怎样回滚以及线上指标对应哪个版本,问题仍然停留在单点部署层面。




