
io_uring 注册缓冲区高并发读写怎样减少重复注册开销怎样在批处理代码中减少额外分配
来源:17golang原创
时间:2026-11-09 11:03:39 130浏览 收藏
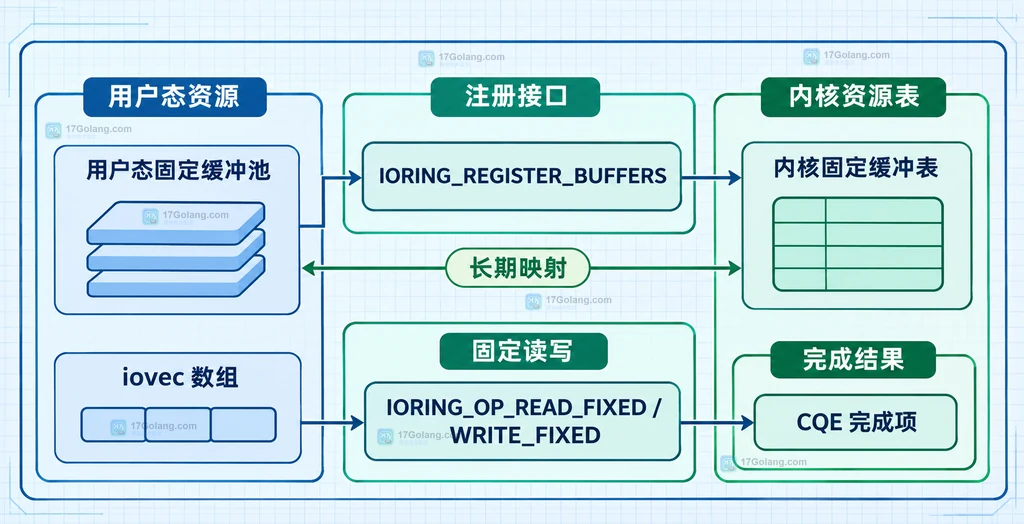
高并发读写的关键不是让每个请求都重新注册一块缓冲区,而是把生命周期较长、容量可预估的内存池在 ring 初始化阶段注册一次。之后每个请求只携带固定缓冲区索引以及本次使用的地址范围,让 IORING_OP_READ_FIXED 或 IORING_OP_WRITE_FIXED 复用这份内核资源。
这样做能减少重复的页固定、地址映射和临时对象分配,但它不是“注册后什么都不用管”:注册内存会受到 RLIMIT_MEMLOCK 约束,更新或注销也必须避开仍在使用这些缓冲区的请求。下面按“资源准备一次、批次循环复用、生命周期收口”的模式拆开说明。
先把一次性注册从请求热路径移出去
固定缓冲模式适合批量任务的共同特征:缓冲区大小有上限、并发 worker 数大致可控,而且请求可以从池中借一个槽位。io_uring_register 注册用户缓冲区后,内核会长期持有相关映射;提交固定读写时,SQE 的 buf_index 选择注册数组中的槽位,addr 和 len 仍必须落在该槽位范围内。
示例只展示初始化阶段的对象关系,不作为已经在本机执行过的输出:
// 初始化阶段只做一次:准备连续缓冲区并注册到 ring。
struct iovec fixed_iov = {
    .iov_base = buffer_pool,
    .iov_len = slot_count * slot_size
};

// 注册后,槽位索引由应用自己维护;失败时应立即释放资源并走普通缓冲回退。
int rc = io_uring_register_buffers(&ring, &fixed_iov, 1);
if (rc
注册的是整个区域,不等于每次 I/O 都要使用全部容量。应用可以把一个大区域切成固定大小的槽位,再让每个请求使用槽位内的子范围。这样注册动作只出现在冷路径,批次循环不再反复触发注册接口。
提交时只传递 buffer index、addr 和 len
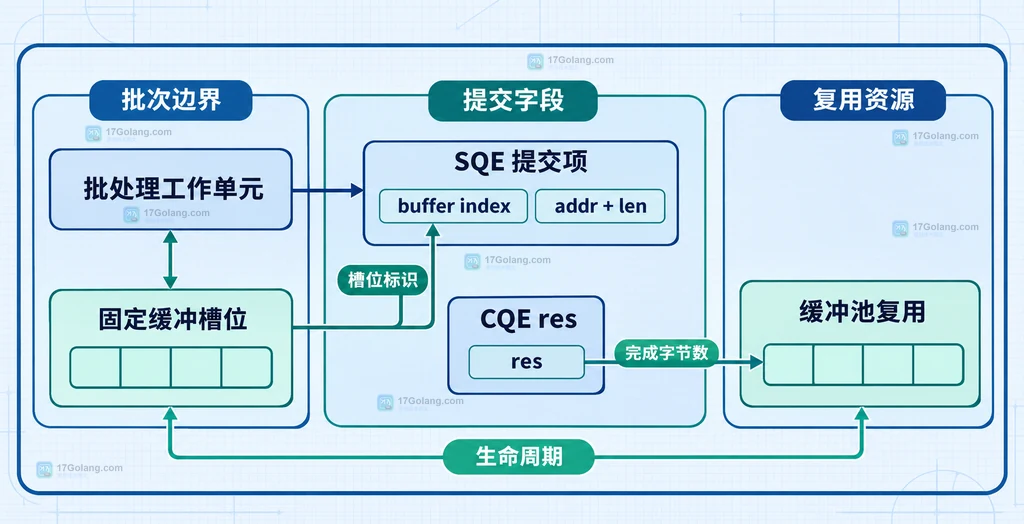
固定缓冲区的性能收益来自“资源长期存在”和“请求只引用资源”。批处理循环每次拿到空闲槽位后,写入本批数据,再把槽位索引、偏移和有效长度填进 SQE。不要把整个 buffer 当成有效数据,也不要在请求还未完成时把槽位交还给下一批。
// 热路径只计算当前槽位的范围,不重新申请或注册内存。
struct io_uring_sqe *sqe = io_uring_get_sqe(&ring);
if (sqe == NULL) {
    // SQ 已满时让上层先收割 CQE,避免无界分配新的请求对象。
    return -2;
}

// 这里的 offset 与 length 必须位于已注册区域内。
size_t offset = slot_index * slot_size;
size_t length = payload_length;
io_uring_prep_read_fixed(sqe, fd, (char *)buffer_pool + offset,
                         length, file_offset, (int)slot_index);
io_uring_sqe_set_data(sqe, slot); // 用 user_data 找回槽位所有权。
代码中的 slot_index 是应用层的稳定标识,buf_index 是 io_uring 注册表中的索引;二者可以相同,也可以通过槽位表映射。真正需要保证的是提交时引用的索引没有越界,并且有效字节数没有超过该槽位的容量。
批处理循环怎样复用槽位并减少额外分配
批处理最容易犯的错误,是虽然注册了固定缓冲区,却仍然在每轮创建临时字节数组、临时描述对象和新的注册数组。更稳的做法是预分配槽位表:槽位保存状态、偏移、容量和待回收的 user_data,批次开始时只重置状态,批次结束时根据 CQE 释放所有权。
// 槽位表在启动时分配一次,批次内通过状态位复用。
for (size_t i = 0; i result = cqe->res;
    slot->state = SLOT_FREE;
    io_uring_cqe_seen(&ring, cqe);
}
如果批次大小超过槽位数量,应该让生产者等待或回收 CQE,而不是继续申请新缓冲区。这样额外分配的数量被固定在初始化阶段,内存占用也能用“槽位数 × 槽位大小”估算。
生命周期、更新和失败回退
固定缓冲区的代价是生命周期更严格。注销或替换缓冲区前,必须确认没有未完成请求继续引用它;资源更新也可能要等仍使用旧资源的请求完成。若注册失败,常见原因包括锁页额度不足、缓冲区不是可接受的匿名内存,或内核能力不足,此时应回退到普通读写路径,而不是把失败重试变成新的分配风暴。
| 场景 | 建议 | 不要做 |
|---|---|---|
| 固定大小批处理 | 启动时注册池,运行中只复用槽位 | 每条请求重新注册 iovec |
| 请求大小波动 | 按容量分级建池,使用槽位内有效范围 | 用大池覆盖所有极端峰值 |
| 需要换池 | 先收割 CQE,再更新或注销 | 覆盖仍在飞行的缓冲区 |
| 注册失败 | 记录错误并走普通缓冲回退 | 无限重试注册和 malloc |
结论与常见问题
可以把这套模式记成三句话:注册是冷路径,槽位引用是热路径,CQE 是所有权回收点。它适合长期运行、请求规模相对稳定的高并发批处理;如果每个请求都需要完全不同的生命周期或大小,固定池的管理复杂度可能抵消收益,应该先测量注册与分配开销再决定。
注册缓冲区后还能使用普通 read 吗?
可以。注册只是让固定缓冲操作有了可复用资源,是否使用 READ_FIXED/WRITE_FIXED 仍由提交的操作码决定;普通路径不会自动获得固定缓冲的收益。
为什么槽位不能在提交后立即复用?
因为提交完成只代表请求进入队列,直到对应 CQE 被收割前,内核仍可能读写该槽位。过早复用会覆盖在途数据,造成结果错配或数据竞争。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
208 收藏
-
367 收藏
-
226 收藏
-
294 收藏
-
369 收藏
-
356 收藏
-
225 收藏
-
104 收藏
-
232 收藏
-
439 收藏
-
479 收藏
-
316 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习