
按 PID 查 Linux 崩溃记录,最小写法是 coredumpctl list PID。例如进程号是 6654,先执行 coredumpctl list 6654,确认时间、信号、可执行文件和 COREFILE 状态;再用 coredumpctl info 6654 查看详细元数据。只有 core 文件仍可访问时,才继续使用 dump 或 debug。
官方地址:https://www.freedesktop.org/software/systemd/man/latest/coredumpctl.html
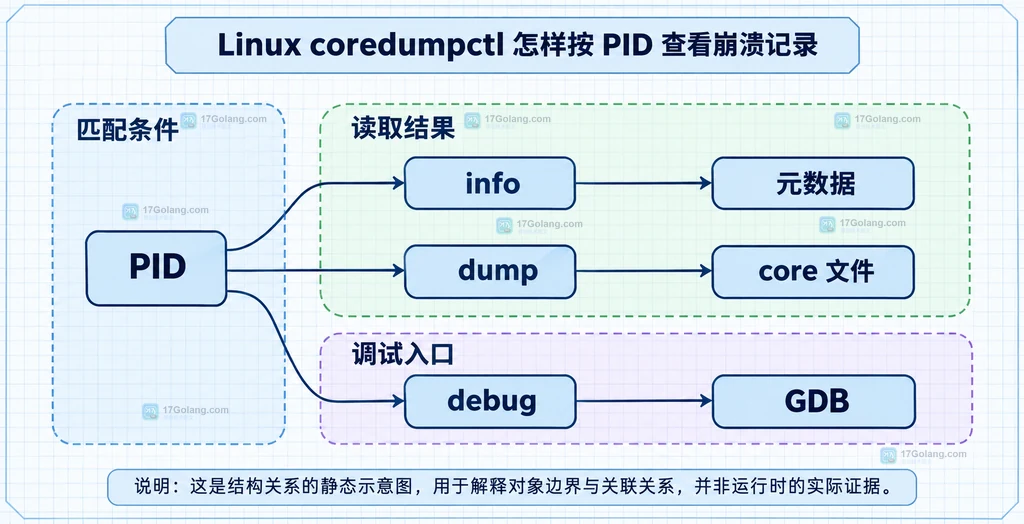
PID 是 coredumpctl 的匹配条件,不要求进程此刻仍在运行;真正决定能否调试的是匹配记录是否存在,以及 COREFILE 是否仍可访问。
先界定要保护的对象
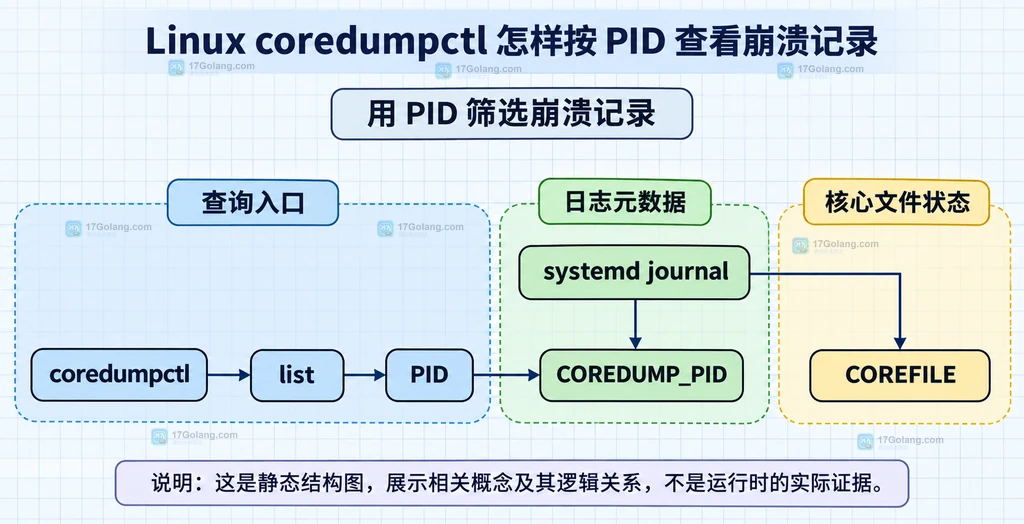
崩溃记录至少包含两类对象:一类是 systemd journal 中的时间、PID、UID、信号和可执行文件等元数据,另一类是可能保存下来的 core 文件。前者适合定位“哪个进程、什么时候、因为什么信号退出”,后者可能包含堆栈、请求数据、密钥片段或其他进程内存。
因此排查时先读元数据,再决定是否导出或交给调试器。不要把“列表里看得到”直接理解成“可以拿到完整 core”,也不要把导出的 core 放到所有人可读的临时目录。
用 list 按 PID 找到匹配记录
list 会列出符合条件的崩溃条目;PID 作为位置参数传入。下面的 PID 仅用于展示命令格式,输出不是某台机器的实测结果。
# 把 6654 替换成需要排查的进程号
coredumpctl list 6654

# 没有指定子命令时也默认执行 list;这里保留显式写法便于审计
coredumpctl 6654
输出重点看四列:
TIME:内核报告的崩溃时间,用来区分同一程序的多次崩溃。PID:发生崩溃的进程号,应与查询条件对应。SIG:导致进程退出的信号,例如SIGSEGV。COREFILE:core 是否保存、是否完整、当前用户是否能访问。
用 info 读取元数据并核对 COREFILE
列表足以判断“有没有记录”,但排查原因通常需要 info。它会展示匹配条目的详细信息,包括程序名、UID、GID、信号和时间等。
# 读取 PID 6654 对应的详细崩溃元数据
coredumpctl info 6654

# 同一 PID 可能对应多个条目,先用 list 的时间和 EXE 判断目标记录
coredumpctl list 6654
判断 COREFILE 时不要只看“有记录”。常见状态的含义可以这样理解:
| 状态 | 排查含义 | 下一步 |
|---|---|---|
present | core 文件仍可由当前用户访问 | 可以考虑 dump 或 debug |
journal | 内容保存在 journal 中 | 先确认权限和导出需求 |
missing | 曾经保存到文件,但文件已经不存在 | 只能使用现有元数据 |
error | 记录存在,但 core 无法访问,常见原因是权限不足 | 检查访问权限,不要盲目重试 |
none | 没有保存 core 文件 | 使用 info 做原因定位 |
按结果选择 dump 或 debug
info 只读元数据;如果你需要拿到文件,使用 dump 并显式指定输出位置。如果目标是进入 GDB,则使用 debug。这三个命令都可以继续使用同一个 PID 作为匹配条件。
# 把匹配到的 core 导出到受控目录,目录权限应先由管理员设定
install -d -m 700 ./crash-review
coredumpctl -o ./crash-review/core-6654 dump 6654

# 直接为匹配到的崩溃启动默认调试器 GDB
coredumpctl debug 6654
如果只是需要确认调用栈或程序身份,优先使用 info;如果要复制原始内存内容,才使用 dump。debug 默认会使用 GDB,也可以由 systemd 的调试器选项或环境变量改变。调试前应确认 core 与可执行文件、调试符号属于同一构建产物,否则调用栈可能难以解释。
为什么按 PID 仍然查不到
当前用户看不到别人的 journal
coredumpctl 需要读取 journal。普通用户通常只能看到自己权限范围内的崩溃信息;这时“没有匹配项”不一定代表系统从未记录,可能只是当前账号没有读取权限。让有权限的值班账号执行查询,并把权限原因记入工单。
PID 会复用,不能只凭数字认定目标
PID 是进程生命周期内的标识,不是业务请求的永久 ID。排查时至少同时核对 TIME、EXE、SIG 和用户身份;如果这些信息对不上,不要把同 PID 的旧崩溃记录当成这次事故的证据。
记录还在,但 core 已被清理
journal 中的条目和外部 core 文件不是同一个生命周期。列表仍可能保留元数据,但对应文件已被清理,状态会表现为 missing;这时可以继续用 info 复盘,却不能凭空恢复已经删除的 core。
安全收尾与审计清单
- 先记录查询的 PID、时间范围、EXE 和信号,再复制任何 core 文件。
- 导出目录使用最小权限,避免 core 中的敏感内存被无关用户读取。
- 调试完成后按团队保留策略清理临时副本,并记录处理人和时间。
- 如果只需要判断崩溃原因,优先保留
info输出,不要无条件导出完整内存。 - 把“无匹配”“权限不足”和“core 已缺失”区分记录,避免把三种结果混成一个故障结论。
速记就是:list PID 负责找记录,info PID 负责看元数据,dump PID 负责导出 core,debug PID 负责进入 GDB。先确认匹配记录和 COREFILE 状态,再选择后续动作。
相关问题
PID 对应的进程已经结束,还能查吗?
可以。coredumpctl 查询的是 systemd-coredump 保存的 journal 条目和 core 元数据,不要求目标进程当前仍在运行。
list 有结果但 debug 失败怎么办?
先回到 info PID 核对 COREFILE 状态、权限和调试器,再确认可执行文件与调试符号是否匹配。列表存在不等于完整 core 仍可访问。
没有 core 文件还能定位原因吗?
可以使用 info 读取程序、信号、时间和用户等元数据,但无法替代完整 core 对内存和调用栈的分析。




