
TextDecoderStream ignoreBOM 怎么处理 CSV 开头的 UTF-8 BOM
来源:17golang原创
时间:2026-11-11 09:19:36 283浏览 收藏
我在处理前端 CSV 导入时遇到过一个很隐蔽的现象:第一列表头看起来是 name,但程序取到的字符串前面多了一个不可见字符。这个文件其实带着 UTF-8 BOM,而 TextDecoderStream 的 ignoreBOM 命名又很容易让人把布尔值方向记反。
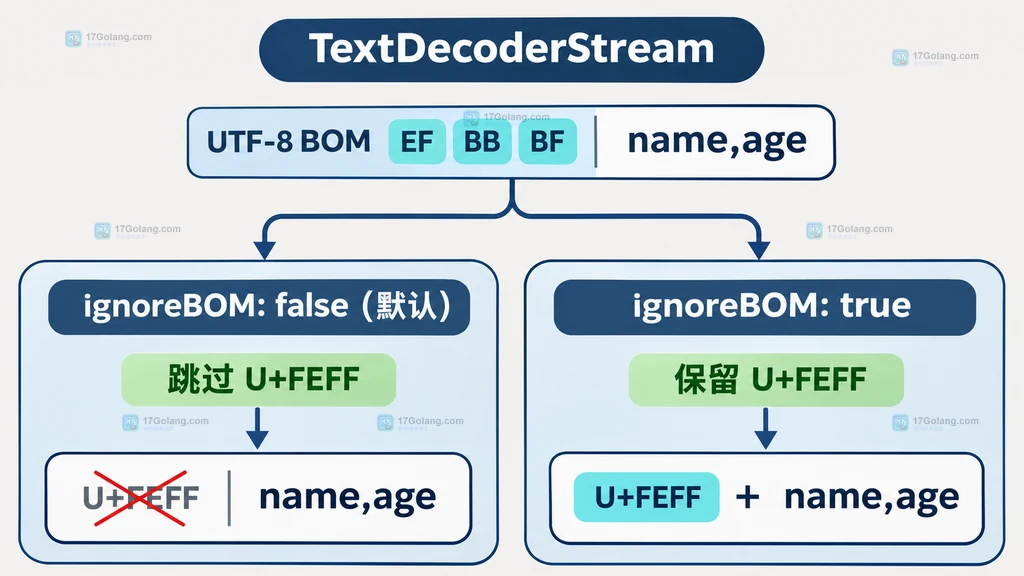
先给结论:new TextDecoderStream("utf-8", { ignoreBOM: false })(默认值)会跳过流开头的 BOM,不把 U+FEFF 交给 CSV 解析器;ignoreBOM: true 反而会保留这个字符。要让 Excel 导出的 UTF-8 CSV 首字段干净,通常保持默认的 false 即可。
ignoreBOM 的布尔值为什么容易读反
ignoreBOM 是只读属性,值来自构造器选项。规范中的默认值是 false:当解码器还没有处理过流开头,并且遇到 UTF-8 的 BOM 时,它会把这个 U+FEFF 跳过。把选项改成 true 后,解码器不再把首个 U+FEFF 当成需要跳过的 BOM,于是它会出现在输出字符串里。
| 配置 | CSV 开头有 BOM 时 | 首字段表现 |
|---|---|---|
ignoreBOM: false | 跳过首个 BOM | name |
ignoreBOM: true | 保留首个 U+FEFF | \uFEFFname |
所以排查时不要只看变量名。可以把它理解成“是否忽略规范对首个 BOM 的特殊处理”:false 才会执行默认的 BOM 跳过逻辑,true 则让它像普通输出字符一样留下来。
把 TextDecoderStream 接到 CSV 流
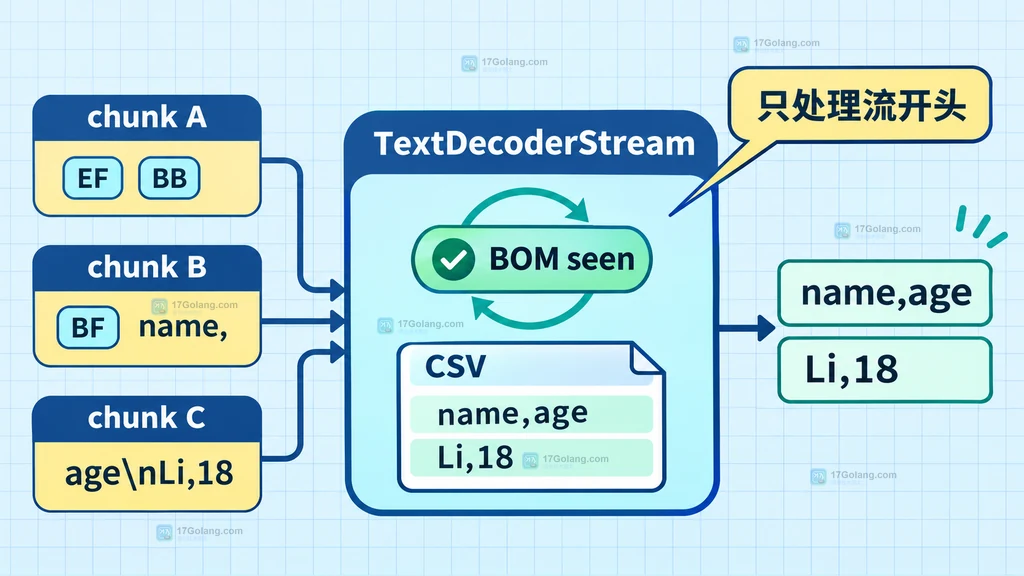
流式读取的关键是先把二进制响应接到 TextDecoderStream,再在字符串层处理换行。这样 UTF-8 多字节字符或 BOM 被拆到不同 chunk 时,解码器仍然能保留自己的状态;业务代码只接收已经解码的字符串片段。
// 读取 UTF-8 CSV,并让流开头的 BOM 不进入首个字段
async function readCsv(response) {
  if (!response.body) {
    throw new Error("响应没有可读取的 body");
  }

  // false 是默认值:跳过首个 UTF-8 BOM,避免首列表头带 U+FEFF
  const decoder = new TextDecoderStream("utf-8", { ignoreBOM: false });
  const reader = response.body.pipeThrough(decoder).getReader();
  const rows = [];
  let carry = "";

  try {
    while (true) {
      const { value, done } = await reader.read();
      if (done) break;

      // 保留最后一段不完整的行,等待下一个 chunk 继续拼接
      const lines = (carry + value).split(/\r?\n/);
      carry = lines.pop() ?? "";
      for (const line of lines) {
        if (line !== "") rows.push(line.split(","));
      }
    }

    // 文件没有换行结尾时,补上最后一行
    if (carry !== "") rows.push(carry.split(","));
    return rows;
  } finally {
    // 读取结束后释放 reader,避免长期占用流的锁
    reader.releaseLock();
  }
}
这段示例只演示 BOM 和流的衔接,split(",") 不是完整 CSV 解析器。如果字段可能包含引号、逗号或换行,应把最后的行处理替换为真正支持 CSV 语法的解析器。
分块读取时,BOM 只在流的起点处理
“首个 BOM”中的首个,指的是解码器当前流状态的开始位置,不是每个 chunk 的开始位置。BOM 的三个 UTF-8 字节可能分别落在不同网络分块里,TextDecoderStream 会等待足够的字节完成解码,然后再按 ignoreBOM 处理。
一旦流已经越过开头的 BOM 判断,正文中后来出现的 U+FEFF 不会被当成新的“文件头 BOM”自动移除。也就是说,ignoreBOM: false 适合清理文件开头的标记,不等于对整份文本做全局不可见字符过滤。
用一个小检查确认首字段是否干净
如果导入逻辑已经存在,可以先检查首字段第一个码点,而不必猜测“看不见的字符”来自哪里:
function inspectFirstCell(rows) {
  const firstCell = rows[0]?.[0] ?? "";

  // U+FEFF 的十六进制码点是 feff,出现它通常表示首个 BOM 被保留了
  const firstCodePoint = firstCell.codePointAt(0)?.toString(16);
  return {
    value: firstCell,
    startsWithBom: firstCodePoint === "feff"
  };
}

// ignoreBOM=false 时,正常的首列表头应直接从 n 开始
console.log(inspectFirstCell([["name", "age"]]));
若结果仍以 feff 开头,优先检查实际创建的解码器是不是传成了 true,或者在流进入它之前已经把文本用另一套解码逻辑处理过。不要用 ignoreBOM 去解决 GBK、GB18030 等编码识别问题;它只控制 BOM 的输出策略。
几个容易踩到的边界
- 不要按 chunk 的首字符删除:网络分块没有文件语义,后续 chunk 开头的字符不一定是 BOM,也可能只是普通数据。
- 不要全局替换 U+FEFF:这样可能误删正文中有意义的零宽字符;只处理文件起点更安全。
- 不要混淆读取和解析:
TextDecoderStream负责把字节流变成字符串流,不负责引号、转义、列数和换行规则。 - 需要保留原始标记时再用 true:例如你要诊断上游文件是否带 BOM,才有理由让 U+FEFF 进入业务层。
总结
处理带 UTF-8 BOM 的 CSV 时,最小配方就是把二进制流接到 new TextDecoderStream("utf-8", { ignoreBOM: false })。记住这个反直觉关系:false 跳过流开头的 BOM,true 保留 U+FEFF;BOM 的判断属于解码器的流状态,不应该按每个 chunk 重复做字符串替换。
相关问题
TextDecoderStream 能直接解析 CSV 吗?
不能。它只负责编码解码和流式输出字符串,CSV 的引号、逗号、换行和转义仍需要单独的解析逻辑。
ignoreBOM 会把 GBK 文件转成 UTF-8 吗?
不会。它只影响 UTF-8、UTF-16 等解码过程中的 BOM 处理,不能替代编码选择或字符集检测。
为什么首字段只在部分文件里多一个不可见字符?
通常是上游文件是否写入 UTF-8 BOM 不一致。对可能来自表格软件的 CSV,统一使用默认的 ignoreBOM: false,再用首字段码点检查结果,定位会更直接。
-
130 收藏
-
361 收藏
-
356 收藏
-
351 收藏
-
238 收藏
-
240 收藏
-
355 收藏
-
132 收藏
-
390 收藏
-
文章 · 前端 | 43分钟前 | 前端 · javascript · 浏览器API · ArrayBuffer TypedArray ArrayBuffer.transfer detached JavaScript二进制缓冲区500 收藏
-
332 收藏
-
472 收藏
-
453 收藏
-
239 收藏
-
272 收藏
-
288 收藏
-
468 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习