
Hugging Face Datasets concatenate_datasets 怎样合并字段一致的数据集
来源:17golang原创
时间:2026-11-11 21:46:39 161浏览 收藏
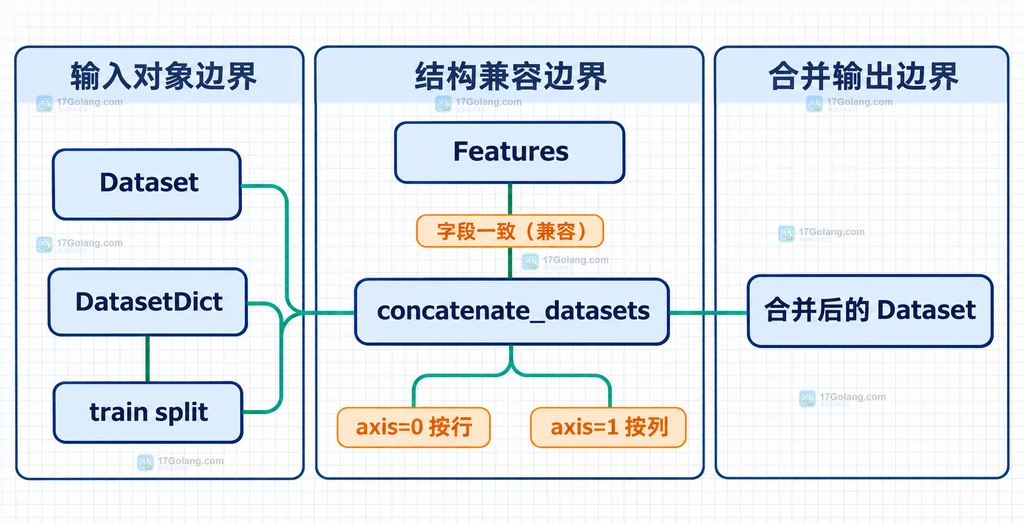
如果你手里有两个字段结构相同的 Hugging Face Dataset,最直接的做法是先确认它们不是 DatasetDict,再调用 concatenate_datasets([ds_a, ds_b])。默认的 axis=0 表示按行拼接;如果要按列组合,才显式考虑 axis=1。合并前重点看列名和 Features,不要只看 Python 字典里的字段名。
官方地址:https://huggingface.co/docs/datasets/package_reference/main_classes
一句话判断:先从 DatasetDict 取出同名 split,确认输入 Dataset 的列和 Features 兼容,再用 concatenate_datasets 合并;报错时优先排查对象层级、列结构和 axis。
先确认输入对象和合并方向
load_dataset() 加载多个 split 时,常见结果是 DatasetDict;而 concatenate_datasets() 接收的是 Dataset 或 IterableDataset 列表。两者混用时,问题往往不是拼接函数本身,而是少取了一层 split。
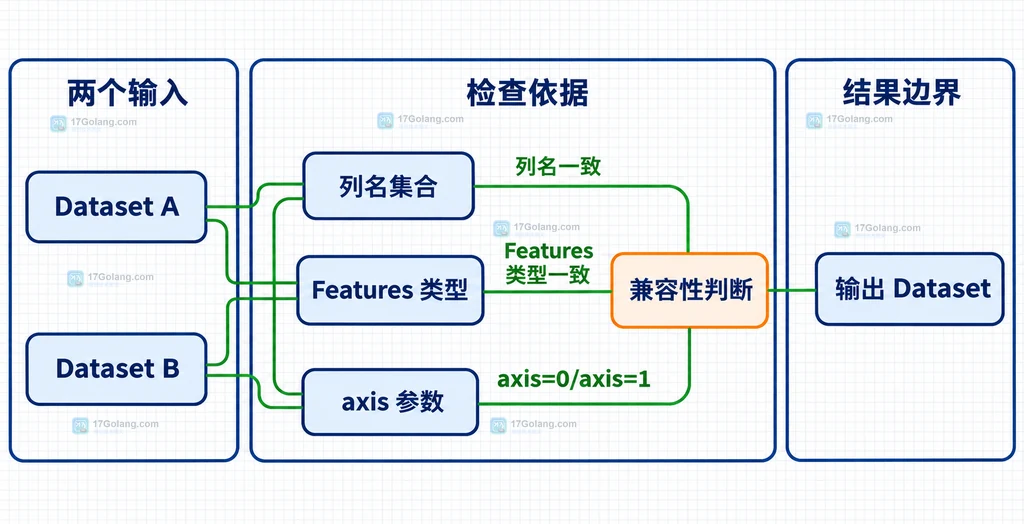
这里的方向也要先定清楚:axis=0 是纵向增加样本行,适合把同一任务的两批数据接在一起;axis=1 是横向增加列,要求两边样本能够对应。大多数“把两个数据集汇总”的需求,应该从默认的 axis=0 开始。
用 concatenate_datasets 按行合并同结构数据
下面的示例故意使用内存中的小数据集,便于看出合并关系。代码中的注释说明了输入、方向和错误边界;它不是线上运行截图。
from datasets import Dataset, concatenate_datasets

# 两个 Dataset 使用相同的列名和特征类型,适合按行拼接
left = Dataset.from_dict({"text": ["a", "b"], "label": [0, 1]})
right = Dataset.from_dict({"text": ["c"], "label": [0]})

# axis=0 表示纵向追加样本行;结果列仍是 text 和 label
merged = concatenate_datasets([left, right], axis=0)
print(merged.num_rows, merged.column_names)

# 重要逻辑:列名相同不等于 Features 一定兼容,报错时先检查 merged 前的两份 features
这个结果的核心是“行数相加、列结构保持一致”。不要把 left 和 right 先转换成普通列表再拼接,否则会绕开 Datasets 的特征信息和缓存语义。
DatasetDict 要先取出对应 split
如果输入是带有 train、validation 或 test 的 DatasetDict,应分别决定每个 split 的处理方式。不能把“两个 DatasetDict”直接当成两个 Dataset 传入同一个列表。
from datasets import DatasetDict, concatenate_datasets

# 假设 first 和 second 都是 DatasetDict,先取出同名的 train split
train_a = first["train"]
train_b = second["train"]

# 只合并训练集;validation/test 是否合并要按数据来源和评估规则单独决定
train_merged = concatenate_datasets([train_a, train_b])

# 资源边界:保留 split 语义,避免把训练、验证样本混成一个集合
result = DatasetDict({"train": train_merged})
如果两个来源的 split 名称不同,先明确它们是否真的属于同一用途;不要因为都叫“数据集”就把训练集和测试集纵向合并。
定位特征和列结构不一致
合并失败时,可以按三层排查:第一层是对象类型,确认列表里的每个元素确实是 Dataset;第二层是列名集合;第三层是每一列的 Features 类型。只看 column_names 可能漏掉字符串、整数、ClassLabel 或嵌套结构的差异。
def explain_shape(dataset, name):
    # 用同一组信息比较两个输入,避免只凭肉眼看样本值
    print(name, dataset.column_names)
    print(name, dataset.features)

# 先比较结构;如果列名不同,按行拼接前应补齐或重命名字段
explain_shape(left, "left")
explain_shape(right, "right")

# 只有样本能够按位置对应时才考虑 axis=1;否则不要用它掩盖数据错位
常见处理顺序是:列名不同就先统一字段;Features 类型不同就先用明确的特征转换;输入是 DatasetDict 就先取 split;只有确认样本一一对应时才从 axis=0 切换到 axis=1。不要为了让函数“跑起来”而强行丢列。
一张表记住合并边界
| 现象 | 先看什么 | 处理方向 |
|---|---|---|
| 传入对象类型报错 | 是否把 DatasetDict 当 Dataset | 先取出对应 split |
| 按行合并失败 | 列名与 Features | 统一字段或特征类型 |
| 按列结果错位 | 两边样本是否一一对应 | 不能对应就改用 axis=0 或重新设计键 |
| 训练评估混在一起 | split 的业务语义 | 分别合并并保留 split 名称 |
相关问题
concatenate_datasets 和 interleave_datasets 有什么区别?前者适合把来源按方向拼成一个结果,后者用于交错取样;如果关心采样比例和停止策略,应单独设计。
列名相同就一定能合并吗?不一定。还要比较 Features 类型、嵌套结构以及 axis 所要求的样本对应关系。
为什么不建议直接拼 DatasetDict?DatasetDict 是 split 名称到 Dataset 的映射。先取出明确 split,才能避免把训练、验证和测试的语义混在一起。
-
346 收藏
-
235 收藏
-
387 收藏
-
447 收藏
-
360 收藏
-
160 收藏
-
488 收藏
-
239 收藏
-
117 收藏
-
181 收藏
-
146 收藏
-
165 收藏
-
383 收藏
-
科技周边 · 人工智能 | 16小时前 | 人工智能 · openai · Webhook · WebHook OpenAI Responses API background response response.completed499 收藏
-
305 收藏
-
356 收藏
-
165 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习