
Laravel 队列重试次数怎样与失败记录配合
Laravel 队列的重试次数和失败记录不是两个独立开关:worker 或作业类先决定一个作业最多尝试多少次,异常、超时以及某些中间件或手动 release() 都可能消耗尝试;只有作业耗尽允许的尝试后,才会进入失败作业存储。官方队列文档地址:https://laravel.com/docs/12.x/queues
可以把处理过程记成“尝试 → 退避 → 再尝试 → 达到边界后记录失败”。先把暂时性故障和永久性故障分开,再决定是否用queue:retry重新投递,不要看到failed_jobs就无条件批量重试。
- 最大尝试次数:由
queue:work --tries或作业类的$tries、tries()决定。 - 失败记录时机:作业耗尽尝试、持续超时或最终抛出异常后,才写入
failed_jobs。 - 重试等待:用 worker 的
--backoff或作业的$backoff/backoff()拉开间隔。 - 人工动作:先用
queue:failed查看失败上下文,修复原因后再按 ID 执行queue:retry。
先区分一次尝试和一条失败记录
worker 从队列取出作业并执行一次,就产生一次尝试。Laravel 文档还特别说明,未处理异常、手动释放、WithoutOverlapping 或 RateLimited 等中间件释放,以及超时,都可能消耗尝试次数。因此“handle() 完整执行过几次”和“attempts 计数是多少”不能简单画等号。
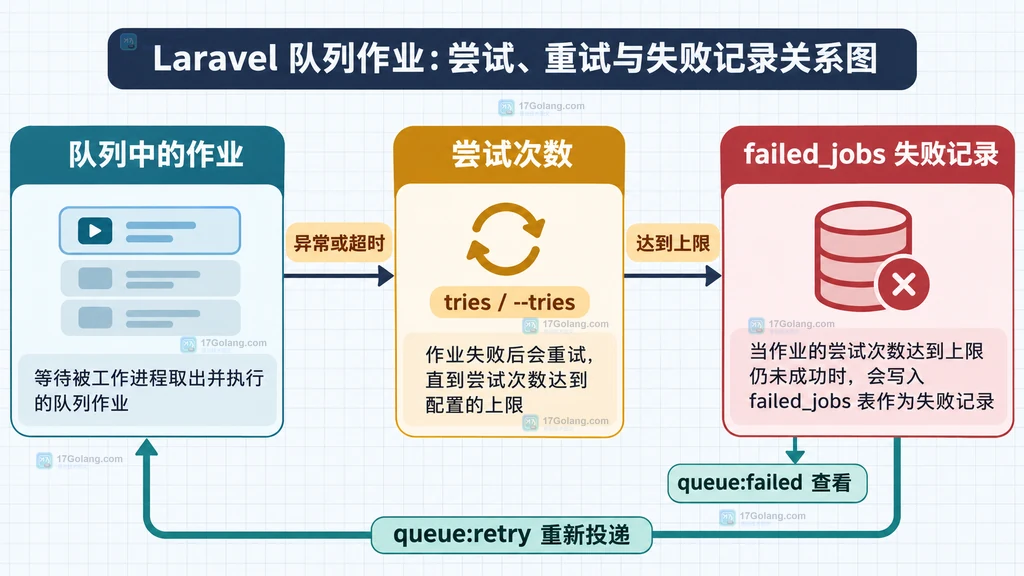
如果作业仍有剩余尝试,异常通常会让它回到队列;达到最大尝试后,Laravel 才把它视为 failed job。失败记录保存的是后续人工判断所需的线索,例如作业 ID、连接、队列、失败时间和异常信息,而不是“自动修复已经完成”的证明。
用 worker 和作业类设定重试上限
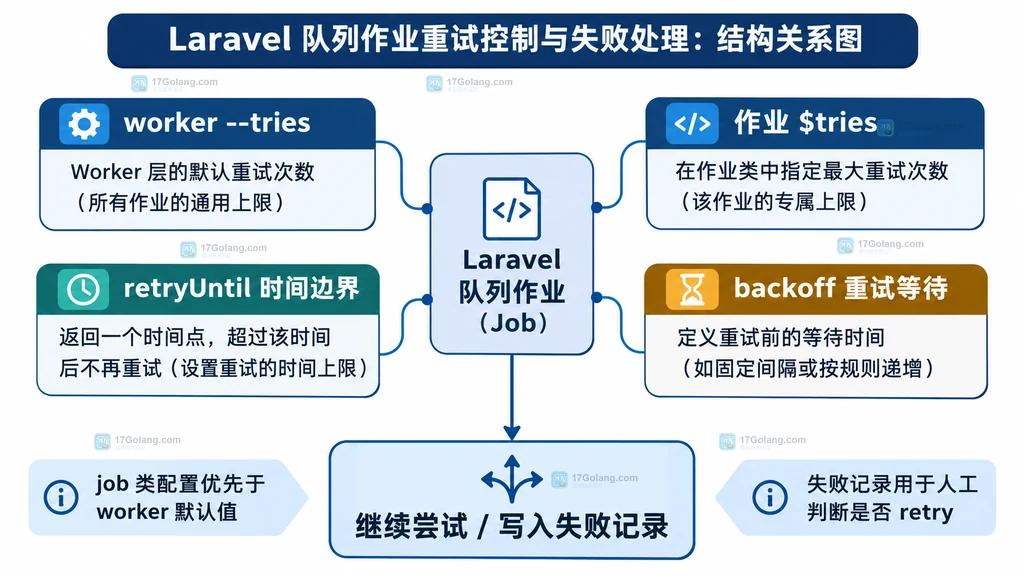
最粗粒度的配置是在启动 worker 时指定 --tries。如果某个作业需要自己的边界,可以在作业类中声明 $tries 或提供 tries() 方法。作业类的配置适合表达业务差异,例如发送通知和生成报表可能不应该共享同一个重试上限。
# worker 默认最多尝试 3 次,所有未单独声明的作业沿用这个边界
php artisan queue:work redis --tries=3

# 只查看失败作业的 ID、连接、队列和失败时间,先收集上下文再处理
php artisan queue:failed
sync($this->invoiceId);
    }

    public function __construct(private readonly int $invoiceId)
    {
        // 只保存可序列化的标识,处理时重新读取最新业务数据。
    }
}
?>
如果同时设置 worker 的 --tries=3 和作业类的 $tries=5,应以作业类规则作为该作业的细粒度配置。不要把 --tries=0 当成“失败自动解决”;官方文档将它定义为无限重试,只有确定故障可以最终恢复时才适合采用。
用 backoff、retryUntil 和 timeout 拉开边界
默认情况下,异常后的作业可能立即重新入队。依赖外部 API、数据库或限流服务时,紧密重试会进一步放大故障。可以用 worker 的 --backoff 或作业类的 backoff 属性/方法设置等待时间,也可以返回一组等待秒数形成逐步退避。
addMinutes(10);
    }
}
?>
retryUntil() 用时间边界控制重试时段;如果它和 tries 同时存在,Laravel 文档说明优先使用时间边界。另一个容易混淆的参数是 worker 的 --timeout:它限制单次执行时长,而不是等待下一次重试的时长。队列连接的 retry_after 也要和 timeout 配合,通常应让 timeout 比 retry_after 短几秒,避免冻结作业被重复处理。
达到上限后怎样阅读 failed_jobs
新应用通常已经包含失败作业表迁移;如果项目没有,可以先生成失败作业表迁移并执行迁移。正式环境中,先确认失败存储没有被显式关闭,再用命令查看记录:
# 没有失败作业表时生成迁移,然后按项目流程执行数据库迁移
php artisan make:queue-failed-table
php artisan migrate

# 查看失败作业,记录目标 ID 和异常原因
php artisan queue:failed

# 只对已经修复原因的指定作业重新投递,避免无差别重试全部记录
php artisan queue:retry ce7bb17c-cdd8-41f0-a638-9b4fef4e5ece
失败记录代表一次处理链路已经到达边界,不代表下一次 queue:retry 一定成功。若异常来自错误参数、已删除资源或不具备幂等性的外部副作用,应先修复代码或数据,再选择指定 ID 重试。批量重试适合有明确共同根因且已经修复的记录;否则容易让同一种错误再次制造大量失败。
把最终失败处理和幂等性收口
作业可以定义 failed(?Throwable $exception),在最终失败时发送通知、更新业务状态或留下可检索的关联 ID。要注意,Laravel 会在调用 failed 前重新实例化作业,handle 中临时修改过的属性不会可靠地带到失败回调,因此关键上下文应落在持久化记录或结构化日志中。
exportOnce($this->reportId);
    }

    public function failed(?Throwable $exception): void
    {
        // 最终失败只做通知和状态收口,不在这里再次 dispatch 自己。
        app(FailureNotifier::class)->notify($this->reportId, $exception);
    }
}
?>
如果作业通过中间件限流、避免重叠或手动释放来等待资源,要把这些释放也算进尝试预算;必要时增加 $tries,同时给出合理的 backoff。对于连续抛出异常的第三方依赖,还可以使用 Laravel 的异常节流中间件,把“允许多少次异常”和“进入节流后等待多久”分开设计。
| 现象 | 先看什么 | 下一步 |
|---|---|---|
| 作业瞬间重复执行 | backoff、异常类型和 worker 参数 | 增加退避,确认瞬时故障不会触发紧密重试 |
| 作业很快进入 failed_jobs | $tries、retryUntil、timeout 与释放次数 | 重新计算尝试预算,不要只把上限改成无限 |
| retry 后仍然失败 | 失败记录中的异常和业务数据 | 先修复根因与幂等性,再重试指定 ID |
| 同一订单被处理多次 | 外部副作用是否有幂等键 | 让成功写入和重试判断可以安全重复执行 |
常见问题
Laravel 队列默认会重试几次?
如果 worker 没有设置 --tries,且作业类也没有自己的尝试配置,官方文档说明作业通常只尝试一次。使用中间件释放或手动 release() 时,应明确增加尝试预算。
失败记录是不是每次异常都会新增一条?
不是。还有剩余尝试时,作业会重新进入队列;耗尽允许的尝试后才会作为 failed job 保存。最终异常可能是业务异常,也可能是 MaxAttemptsExceededException 或超时异常。
可以直接执行 queue:retry all 吗?
可以执行,但应先确认所有失败记录的共同根因已经修复,并且作业具备幂等性。只想验证一个修复时,优先按具体失败 ID 重试。
清理失败记录会重新执行作业吗?
不会。queue:forget 或 queue:flush 只删除失败记录;需要重新投递时使用 queue:retry,需要清理历史数据时再使用忘记或清空命令。




