
PHP mb_convert_encoding 处理混合编码输入的排查指南
来源:17golang原创
时间:2026-11-13 16:28:34 339浏览 收藏
PHP 的 mb_convert_encoding() 只能按照一个明确的来源编码解释一段字节。如果一批输入里同时出现 UTF-8 和 GBK,直接写成 mb_convert_encoding($value, 'UTF-8', 'auto') 并不能保证每个字段都正确。更稳妥的做法是先按文件头、接口元数据或导入约定拆分来源,再用 mb_check_encoding() 验证候选,最后在进入数据库、日志和业务层之前统一成 UTF-8。
本文只讨论混合编码输入的排查边界:如何确认字节来源、怎样降低自动猜测的误判,以及如何把转换放在数据边界处。它不把乱码现象简单归结为“再换一个字符集”。
先判断:混合输入到底是哪一种混合
“混合编码”常见有两种情况。第一种是同一份文件或请求中的不同字段来自不同系统,例如姓名字段是 GBK,备注字段已经是 UTF-8;第二种是同一字段被重复转换,导致一部分内容已经变成 UTF-8,另一部分仍保留旧字节。两种情况都不能用一个全局 from_encoding 粗暴处理。
因此排查时先保留原始字节和来源标识,再问三个问题:
- 字节来自 HTTP、CSV、数据库导出,还是人工拼接?
- 来源系统是否给出 Content-Type、文件 BOM、字段协议或导出选项?
- 这段值是否只包含 ASCII?如果是,很多编码都能解释它,单靠检测无法证明来源。
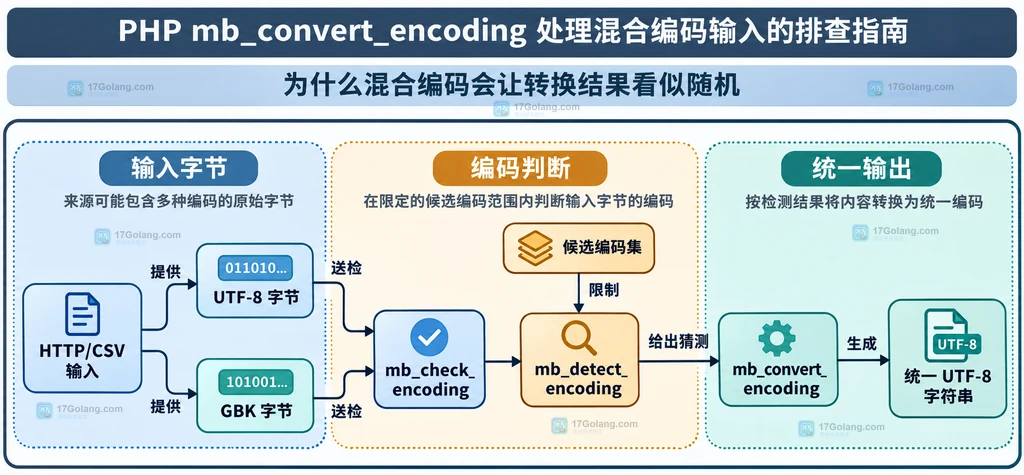
先用来源信息,再用 mb_check_encoding 验证候选
如果接口契约已经说明请求体是 UTF-8,优先相信契约并验证它,而不是让函数猜测。对于历史 CSV,可以根据导出系统固定的编码配置建立来源映射。mb_check_encoding() 检查的是字节流是否符合指定编码,适合用来排除明显不可能的候选,但“合法”不等于“原作者就是用这个编码写的”。
候选顺序不是事实证明。对于只含 ASCII 的短值,UTF-8、GB18030 等候选都可能返回合法;这时应该回到来源协议,而不是把数组顺序当作证据。候选列表也要按业务实际缩小,避免把几十种编码都交给猜测逻辑。
不要把 mb_detect_encoding 当作绝对检测器
mb_detect_encoding() 返回的是“最可能的编码”。PHP 手册明确提示,自动判断无法完全可靠;从 PHP 8.1 起,它使用启发式判断,不能再把传入列表的顺序当成稳定的优先级。短字符串、纯 ASCII 和多个编码都能表示的字节,尤其容易产生看似合理但业务含义错误的结果。
如果历史代码必须保留自动猜测,可以把它限制在候选集合内,并把 false 和低置信度场景显式记录:
这个函数适合做排查工具或兼容层,不适合把任意外部文本无条件转换后直接入库。生产代码应同时记录来源系统、字段名、候选集合和失败样本的标识;不要在日志里写入可能包含隐私的完整原文。
把转换放在输入边界,统一输出到 UTF-8
统一策略应该发生在数据进入业务模型的边界,而不是在每个模板、SQL 拼接或日志调用前重复转换。转换函数至少需要三个明确参数:当前字节的来源编码、目标编码和无法判断时的处理方式。
这里的关键不是函数名,而是每个字段都带有自己的来源声明。若同一 CSV 行的所有字段确实来自同一导出器,可以在行级指定编码;若字段来自不同上游,就应在字段级或来源分区级处理,不能用一个“万能编码”覆盖全部输入。
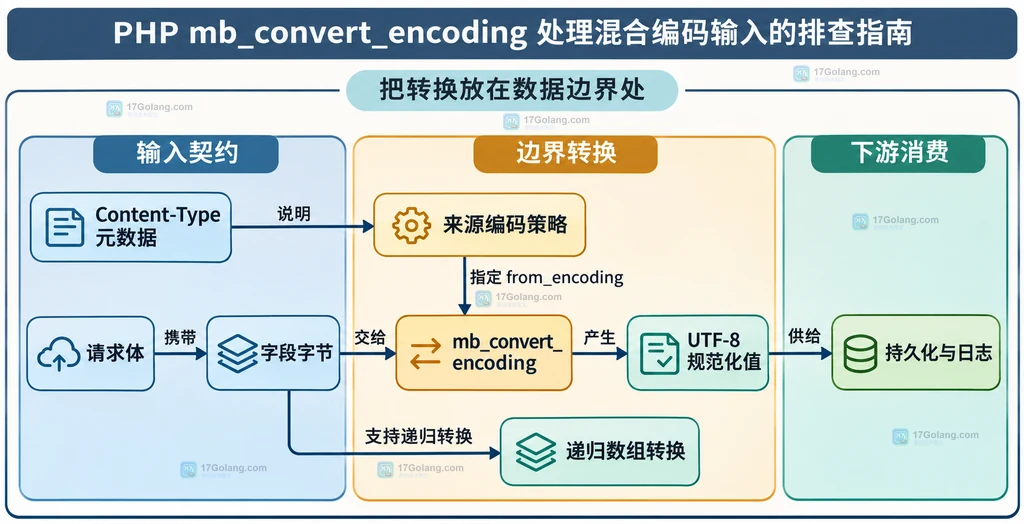
数组字段可以递归转换,但来源策略仍要先确定
mb_convert_encoding() 支持字符串数组,并会递归转换其中的字符串值。这适合处理结构统一、所有字段都来自同一编码来源的导入数据:
 $rawName,
    'remark' => $rawRemark,
    'meta' => ['source' => $rawSource],
];

// 统一转换字符串值;数组键和值的业务含义仍由调用方负责。
$normalizedPayload = mb_convert_encoding($payload, 'UTF-8', 'GB18030');
?>
如果 name 来自 GB18030 而 remark 已经是 UTF-8,就不要对整棵数组调用同一个来源编码。此时应先拆成来源一致的分组,分别规范化,再合并成业务对象。数组递归能力解决的是遍历问题,不会自动解决来源混杂问题。
异常、版本和持久化前的最后检查
编码参数本身也可能出错。PHP 8.0 及以后,传入无效的目标或来源编码会抛出 ValueError;不要只捕获通用警告。对外部输入,建议在进入数据库或消息队列前完成三项记录:
- 保留来源系统、字段名和声明的来源编码。
- 转换失败时记录错误类别和样本标识,不记录完整敏感原文。
- 转换成功后只让 UTF-8 值进入统一的业务模型,并在接口或存储层保持同一约定。
可以用下面的速查表定位常见误区:
| 现象 | 更可能的原因 | 处理方向 |
|---|---|---|
| 同一批字段只有部分乱码 | 字段来源不同或重复转换 | 按来源拆分,分别验证再转换 |
| 短英文值被判成多个编码都合法 | ASCII 对多个编码兼容 | 依赖来源契约,不把检测结果当事实 |
| 检测结果随 PHP 版本或候选变化 | 使用了启发式自动猜测 | 缩小候选,优先使用元数据和严格检查 |
| 传入编码参数后直接抛异常 | 编码名称无效或配置拼写错误 | 校验允许列表并按 PHP 8+ 处理 ValueError |
结论与延伸问题
排查 mb_convert_encoding() 的核心不是不断替换目标编码,而是先回答“这段字节来自哪里”。来源明确时,使用 mb_check_encoding() 做约束、用 mb_convert_encoding() 做一次边界归一化;来源不明确时,把 mb_detect_encoding() 当作有限的猜测工具,并为无法判断的输入保留失败分支。
mb_convert_encoding 的第三个参数可以省略吗?
可以,但省略后会依赖 mbstring 的内部编码设置或默认字符集。对混合来源输入不建议省略,应显式传入已经确认的来源编码。
为什么 mb_check_encoding 通过了,转换后仍然不对?
通过只说明字节流符合该编码,并不证明它就是产生这些字节的真实编码。多个编码可能都能合法解释同一段短字节,仍需要来源元数据或业务样本确认。
能不能把所有输入都先转成 UTF-8?
不能在不知道来源编码时安全地这样做。应先按来源声明、字段分组或文件协议确定解释方式,再统一目标编码;否则转换可能把原本正确的 UTF-8 再次误解。
-
444 收藏
-
216 收藏
-
Golang · Go教程 | 2个月前 | 字符串处理 · Go教程 · 输入校验 · 字符串校验 unicode/utf8 DecodeRuneInString utf8.ValidString 非法UTF-8195 收藏
-
434 收藏
-
203 收藏
-
406 收藏
-
469 收藏
-
500 收藏
-
473 收藏
-
262 收藏
-
317 收藏
-
371 收藏
-
110 收藏
-
241 收藏
-
170 收藏
-
196 收藏
-
480 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习