
Linux /proc/pressure/memory 的 avg10 与 total 怎么读
来源:17golang原创
时间:2026-11-14 06:31:16 443浏览 收藏
很多 Linux 性能告警会同时出现“内存不足”“进程变慢”和 /proc/pressure/memory 数值升高。这个文件里的 avg10 和 total 并不是“剩余内存”和“已用内存”:前者是最近一段时间内,任务因为内存资源而无法立即运行的时间占比;后者是从统计开始以来累计的阻塞时间,单位是微秒。
官方文档:https://docs.kernel.org/accounting/psi.html
读 PSI memory 可以记住一句话:avg 看最近趋势,total 看累计代价;some 看部分任务受阻,full 看所有非空闲任务同时受阻。下面按这个顺序拆开。
先看 /proc/pressure/memory 的两行
在支持 PSI 的内核上,内存压力文件通常有 some 和 full 两行,每行都带有三个平均窗口和一个累计计数器:
# 读取系统级内存压力;输出是内核维护的统计,不是本地脚本计算
cat /proc/pressure/memory
some avg10=0.42 avg60=0.18 avg300=0.07 total=1834567
full avg10=0.03 avg60=0.01 avg300=0.00 total=248901some 表示“至少有一个任务因为内存而处于 stall”,此时仍可能有其他任务在运行。full 表示“所有非空闲任务同时因为内存而处于 stall”,CPU 没有可推进的非空闲工作;它持续升高时,通常比单独的 some 更值得警惕。
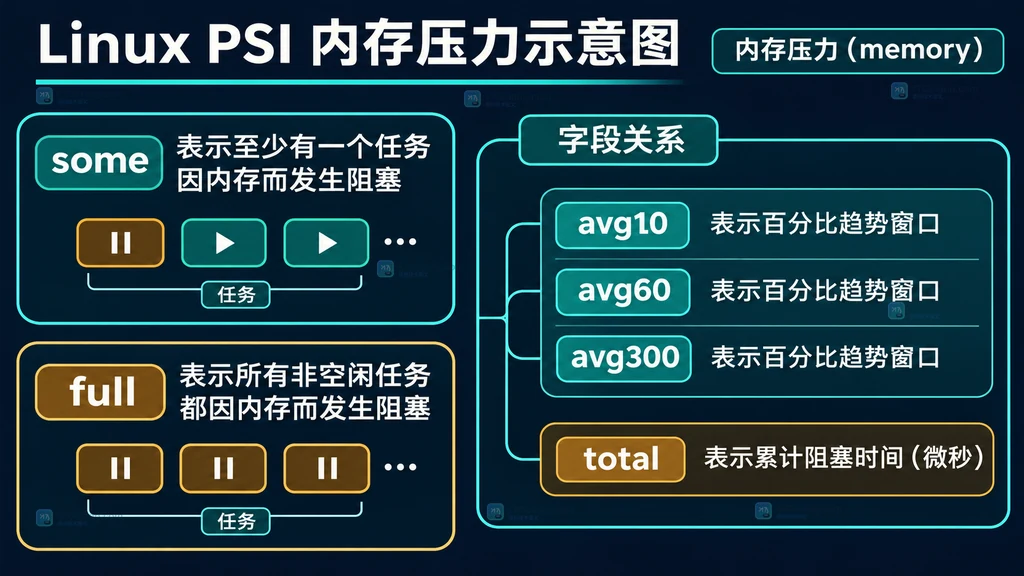
因此,不能只看到 some 不为零就断言系统已经“内存打满”。它只能说明至少有一部分任务在等待内存相关资源;要判断是否出现整体停顿,还要结合 full 的趋势以及业务延迟。
avg10、avg60、avg300 怎么读
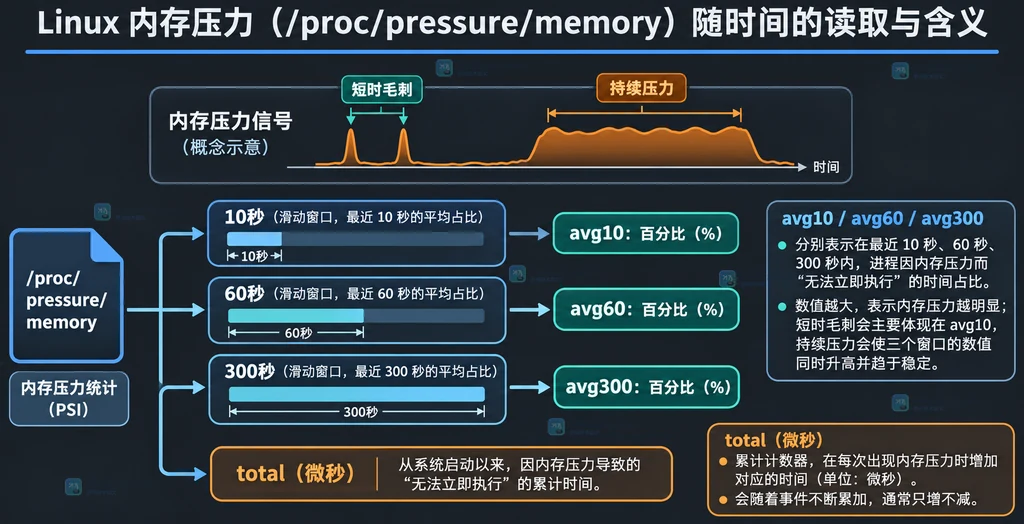
这三个字段的单位都是百分比,区别在于统计窗口长度:
| 字段 | 窗口 | 适合回答的问题 |
|---|---|---|
avg10 | 最近 10 秒 | 刚刚是否出现内存压力 |
avg60 | 最近 60 秒 | 这一分钟是否持续或反复受压 |
avg300 | 最近 300 秒 | 较长时间内是否存在稳定趋势 |
例如 some avg10=4.00 avg60=0.80 avg300=0.10,更像是最近发生了一次明显事件:短窗口已经抬头,但五分钟窗口还被较长的平稳区间稀释。反过来,如果三个值都接近并且持续上升,说明压力不是一次孤立毛刺,而是正在形成持续趋势。
平均值不是“发生次数”,也不是某个进程占用的内存比例。它描述的是在对应窗口内,系统有多少时间处于相应的 stall 状态。窗口越短,变化越快;窗口越长,越适合判断趋势。
total 表示什么,为什么它一直变大
total 是累计 stall 时间,单位是微秒(us)。只要统计继续记录内存压力,它通常只增不减;它不是一个滑动窗口,所以不会因为最近十秒恢复正常而自动归零。
它的价值在于补足平均值的盲区。一次很短的内存阻塞可能让 avg10 只出现很小的变化,但 total 仍会增加。对两个时间点采样并相减,可以得到这段时间新增的阻塞量:
# 保存两次采样;sleep 只用于拉开观察间隔,不改变内核统计口径
awk '$1 == "some" {print "some", $5}' /proc/pressure/memory > /tmp/psi-memory-before
sleep 10
awk '$1 == "some" {print "some", $5}' /proc/pressure/memory > /tmp/psi-memory-after
上面的示例只展示采样思路,生产监控应按键名解析,而不要依赖字段在空格分隔后的固定列号,因为不同内核输出或扩展字段可能改变位置。采样时重点比较同一行、同一字段的两个 total 值,并把微秒换算成毫秒或秒展示。
用四个值区分短时毛刺和持续压力
实际排查可以先把 some 与 full 分开,再观察短长窗口的组合:
- avg10 高、avg60 和 avg300 低:最近刚发生事件,优先对齐发布、批处理、内存突增或回收活动的时间点。
- avg10、avg60 反复抬头:压力可能在抖动,不能只看一次采样,应该连续采集并与业务延迟关联。
- 三个平均值都高,full 也明显增长:更接近整体推进受阻,需要继续检查回收、交换、容器限制和进程级内存变化。
- avg 接近零但 total 在增加:可能只是零星短时阻塞;用一段时间的 total 增量判断事件频率和累计影响。
这些组合是阅读线索,不是固定阈值。不同工作负载对相同百分比的敏感程度不同,不能把某个数字直接当成所有机器通用的故障线。
PSI 能回答什么,不能替代什么
PSI 主要回答“任务因资源不足而等待了多久”。它不能单独告诉你是哪一个进程分配了最多内存,也不能替代内存容量、匿名页、文件页、swap、cgroup 限制和 OOM 日志的检查。
当 full 或 total 的增量异常时,可以按这个顺序继续缩小范围:
- 先连续采集
some/full的三个平均值和total增量,确认是瞬时事件还是持续趋势。 - 再查看主机和对应 cgroup 的内存上限、当前使用量、swap 与回收活动。
- 最后把压力时间与服务延迟、批处理、容器重启或 OOM 记录对齐,确认真正的业务影响。
如果只需要快速判断,优先读 avg10 看“现在”,读 avg300 看“最近几分钟”,再用 total 的差值确认“这段时间到底积累了多少阻塞”。
常见问题
avg10=0 就代表没有内存问题吗?
不代表。它只说明最近十秒的平均 stall 占比接近零;更早的压力仍可能体现在 avg60、avg300 或 total 中。
some 和 full 哪个更重要?
两者用途不同。some 更容易发现部分任务已经等待,full 更能提示所有非空闲任务同时无法推进。要结合持续时间和业务延迟判断。
total 为什么不能直接和 avg10 比大小?
两者口径不同:avg10 是最近十秒的百分比,total 是从统计开始累计的微秒,比较时应先计算同一采样区间的 total 增量。
-
392 收藏
-
Golang · Go教程 | 4个月前 | channel · select · Context · Go教程 · 性能排查 · select channel context default time.Ticker Go教程 CPU飙高 for select459 收藏
-
395 收藏
-
Golang · Go教程 | 4个月前 | golang · Timer · 并发编程 · time.After · 性能排查 · time.After go timer Go 1.23 NewTimer Timer.Reset Timer.Stop403 收藏
-
425 收藏
-
418 收藏
-
493 收藏
-
300 收藏
-
299 收藏
-
293 收藏
-
185 收藏
-
494 收藏
-
287 收藏
-
176 收藏
-
204 收藏
-
307 收藏
-
352 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习