
Transformers 量化加载时如何选择 device_map
来源:17golang原创
时间:2026-11-14 20:54:04 280浏览 收藏
Transformers 量化加载时如何选择 device_map
用 Transformers 和 bitsandbytes 加载量化模型时,device_map 决定的是模型模块放在哪里,BitsAndBytesConfig 决定的是权重怎样量化;两者不是同一个开关。推理任务通常从 device_map="auto" 开始,显存大小不对称时再加 max_memory,只有明确知道模块边界时才维护自定义字典。
官方文档:https://huggingface.co/docs/transformers/quantization/bitsandbytes
简单判断:单卡推理可以指定单个 CUDA 设备;多卡推理优先使用auto,并用max_memory描述预算;需要把某个模块放到 CPU 时才写自定义device_map。训练量化模型时不要把推理阶段的auto配置照搬过去。
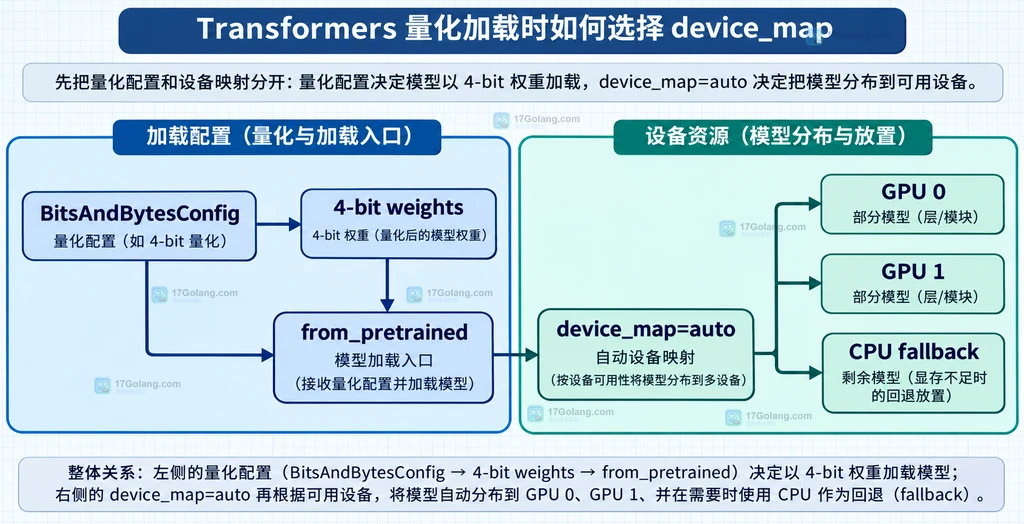
先把量化配置和设备映射分开
以 bitsandbytes 为例,load_in_4bit=True 或 load_in_8bit=True 负责降低权重存储占用,bnb_4bit_compute_dtype 负责计算时使用的类型,device_map 才负责把模块放到可用设备。即使权重变小,激活、KV cache 和未量化模块仍然会占用显存,所以不能只按“参数量除以位宽”判断是否一定能加载。
一个适合推理的最小写法如下。示例把计算类型写出来,避免读者误以为 4-bit 权重意味着所有模块都以 4-bit 运行:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

model_id = "your-org/your-model"

# 4-bit 只描述量化存储;计算类型单独指定为 bfloat16。
quant_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# auto 面向推理分配模块;它不是训练阶段的通用设备策略。
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=quant_config,
    device_map="auto",
    dtype="auto",
)
tokenizer = AutoTokenizer.from_pretrained(model_id)

# 让输入与模型的首个计算设备保持一致,避免设备不匹配。
inputs = tokenizer("用一句话解释量化", return_tensors="pt")
first_device = next(model.parameters()).device
inputs = {key: value.to(first_device) for key, value in inputs.items()}
outputs = model.generate(**inputs, max_new_tokens=32)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
如果仓库已经保存了量化配置,加载时通常可以让 Transformers 从模型配置中读取量化方法,不必再次传入同一份量化开关。本文只讨论推理加载,不把预量化检查点、量化训练和模型评测混在一起。
大多数推理场景先选 device_map="auto"
多块 GPU 或显存不足以容纳完整模型时,auto 是最省维护成本的起点。它会结合可见设备尝试分配模型;如果机器的 GPU 显存不同,或者还要给服务进程、输入和 KV cache 留空间,就不要只依赖“所有显存都可用”的默认判断,而是给出保守预算。
import torch
from transformers import AutoModelForCausalLM, BitsAndBytesConfig

# 显存预算不是整块卡的标称容量,要给运行时开销留余量。
max_memory = {
    0: "18GiB",       # GPU 0 预留一部分空间给服务进程和 KV cache
    1: "10GiB",       # GPU 1 显存较小,避免自动分配过满
    "cpu": "48GiB",   # 允许部分模块落到 CPU,但会牺牲速度
}

# auto 在给定预算内分配;预算过小仍可能无法完成加载。
model = AutoModelForCausalLM.from_pretrained(
    "your-org/your-model",
    quantization_config=BitsAndBytesConfig(load_in_8bit=True),
    device_map="auto",
    max_memory=max_memory,
    dtype="auto",
)

# 这是分配结果的运行时记录,不要把它当作新的配置输入。
print(model.hf_device_map)
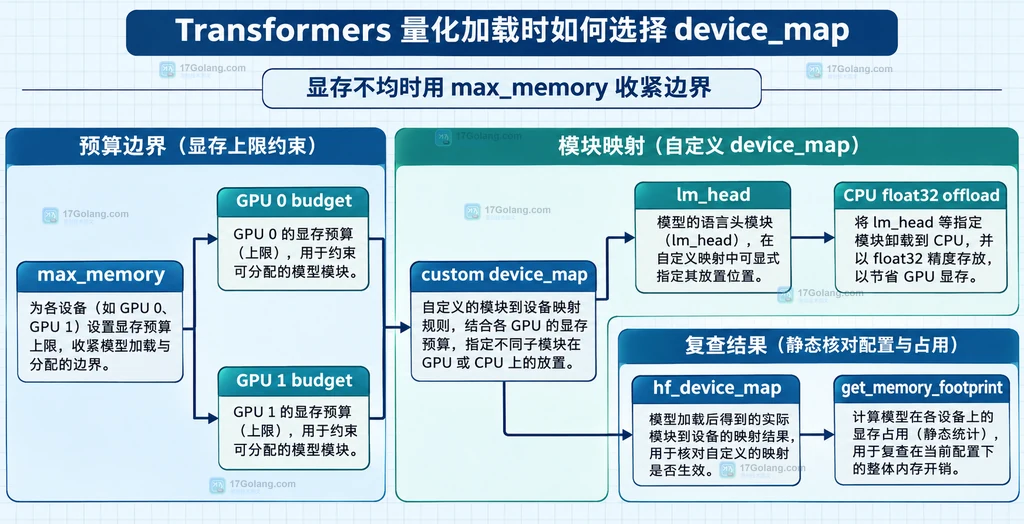
max_memory 的作用是收紧分配边界,不是把显存凭空增加。若模型仍然放不下,应先降低量化精度、减少上下文或换更大设备,而不是不断把预算字符串调到标称上限。
什么时候使用明确设备或自定义 device_map
单卡推理、需要稳定部署拓扑时,可以使用明确设备,例如 device_map="cuda:0" 或对应的设备编号。这样更容易预估输入和缓存都落在哪块卡上,但前提是模型连同非量化模块确实能放下。
自定义字典适合少数明确的边界,例如 8-bit 推理时把 lm_head 放到 CPU。官方文档说明,CPU offload 的权重以 float32 保存,因此它更像容量兜底,而不是免费扩容;跨 PCIe 传输也会让延迟变得不可忽略。
from transformers import AutoModelForCausalLM, BitsAndBytesConfig

# 只有已经确认模型模块名称时,才维护这种精细映射。
device_map = {
    "transformer.word_embeddings": 0,
    "transformer.h": 0,
    "transformer.ln_f": 0,
    "lm_head": "cpu",  # 把输出头放到 CPU,换取 GPU 显存空间
}

# CPU offload 需要显式打开对应配置;不要把任意模块名照抄到别的模型。
quant_config = BitsAndBytesConfig(
    load_in_8bit=True,
    llm_int8_enable_fp32_cpu_offload=True,
)

model = AutoModelForCausalLM.from_pretrained(
    "your-org/your-model",
    quantization_config=quant_config,
    device_map=device_map,
    dtype="auto",
)

# 读取最终映射,确认模型实际接受的模块分布。
print(model.hf_device_map)
print(model.get_memory_footprint())
自定义映射最大的风险是模块前缀依赖具体模型架构:把某个模型的 transformer.h 直接换到另一个模型,可能导致键不存在或分配不完整。因此先读取模型结构和已生成的 hf_device_map,再决定是否需要维护字典。
用这张速查表确定最终选择
| 场景 | 优先选择 | 需要注意 |
|---|---|---|
| 单卡推理且模型能放下 | 明确 CUDA 设备 | 为输入、激活和 KV cache 留余量 |
| 多卡推理或显存不均 | device_map="auto" + max_memory | 预算写保守值,读取 hf_device_map |
| 只想把特定模块放 CPU | 自定义 device_map | 先确认模块前缀,并接受 CPU offload 延迟 |
| 量化训练 | 按训练器和参数高效微调文档配置 | 不要把推理用的 auto 当训练通用方案 |
最后记住三个判断顺序:先确认是推理还是训练,再确认量化配置和计算类型,最后根据显存拓扑选择 auto、明确设备或自定义映射。出现显存溢出时,优先减少预算、上下文或缓存压力,并用模型提供的内存统计和分配映射定位问题。
常见问题
device_map="auto" 能直接用于训练吗?
不要这样假设。官方量化文档把这类设备分配示例放在推理加载场景;训练还涉及梯度、优化器状态和参数更新,应按训练框架的设备策略配置。
用了 4-bit 为什么仍然显存不足?
量化主要降低权重占用,激活、KV cache、未量化模块和输入仍会消耗显存。先看上下文长度与并发,再用 max_memory 给自动分配留下运行余量。
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
212 收藏
-
科技周边 · 人工智能 | 26分钟前 | python · 人工智能 · 并行处理 index Hugging Face Datasets Datasets shard num_shards contiguous417 收藏
-
科技周边 · 人工智能 | 28分钟前 | python · Transformers TextIteratorStreamer 流式生成 AsyncTextIteratorStreamer StoppingCriteria198 收藏
-
279 收藏
-
161 收藏
-
453 收藏
-
科技周边 · 人工智能 | 36分钟前 | 人工智能 · padding Transformers tokenizer max_length attention_mask truncation return_tensors352 收藏
-
科技周边 · 人工智能 | 39分钟前 | 人工智能 · 文本分类 softmax Transformers AutoModelForSequenceClassification logits id2label172 收藏
-
243 收藏
-
457 收藏
-
253 收藏
-
114 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习