
MySQL UUID_TO_BIN 的 swap 参数怎样让时间型 UUID 保持索引顺序
来源:17golang原创
时间:2026-11-15 10:47:32 176浏览 收藏
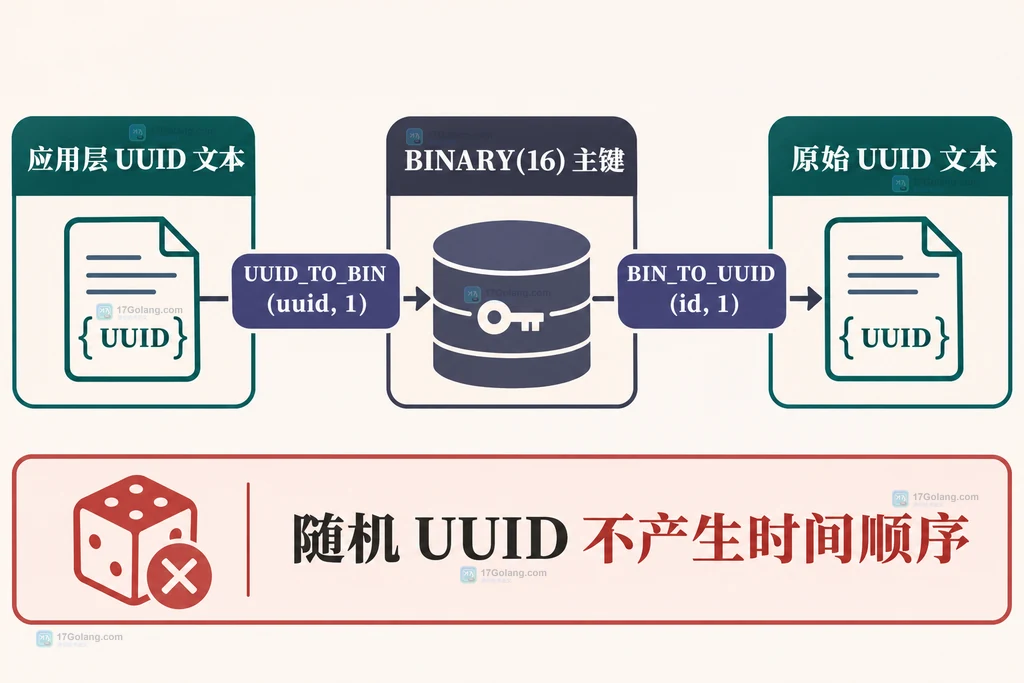
如果表的主键来自时间型 UUID,直接把 36 个字符存成字符串会增加索引体积;但把 UUID 转成二进制后,又容易忘记第二个参数到底该填什么。结论是:UUID_TO_BIN(uuid, 1) 的 1 不是“开启排序”的通用开关,而是针对时间型 UUID 重排时间字段。应用层写入和读取时都使用同一个参数,才能在 BINARY(16) 中稳定往返。
官方地址:https://dev.mysql.com/doc/refman/8.4/en/miscellaneous-functions.html#function_uuid-to-bin
时间型 UUID 可以用swap=1把时间相关字节移到二进制值前部,帮助索引按时间生成顺序更容易形成局部性;随机 UUID 不会因为传入1就变成有序 ID。
先分清 UUID_TO_BIN 的两个参数
UUID_TO_BIN() 接收 UUID 文本和可选的 swap_flag。参数为 0 时,函数只把 UUID 文本转换为 16 字节二进制;参数为 1 时,MySQL 会交换时间型 UUID 的三个时间字段顺序,再返回 16 字节结果。对应的 BIN_TO_UUID() 也必须使用同样的参数,否则读出来的文本会与原值不一致。
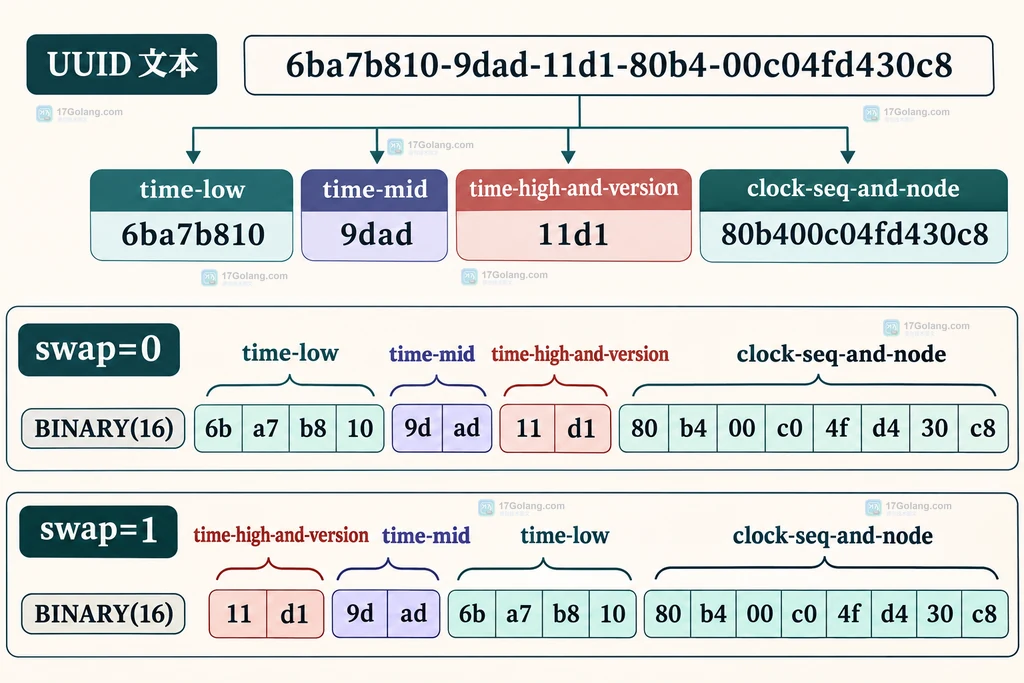
这里的“时间型”指 UUID 的时间字段确实随生成时间变化,例如 UUID v1。这个参数不会分析任意 UUID 的内容,也不会为 v4 这类随机 UUID 计算时间顺序。因此,不能把 swap=1 当作一个通用的自增主键替代方案。
用 BINARY(16) 保存并对称读回
表结构通常把存储列定义为 BINARY(16),这样列宽固定,避免字符集和连字符带来的额外空间。写入时在 SQL 中转换,查询展示时再转换回标准 UUID 文本:
-- 二进制列固定为 16 字节;主键仍然由数据库维护唯一性
CREATE TABLE account_event (
    id BINARY(16) NOT NULL PRIMARY KEY,
    event_name VARCHAR(80) NOT NULL,
    created_at TIMESTAMP NOT NULL
);

-- 时间型 UUID 用 swap=1 写入;应用层传入的是标准 UUID 文本
INSERT INTO account_event (id, event_name, created_at)
VALUES (UUID_TO_BIN('6ccd780c-baba-1026-9564-5b8c656024db', 1),
        'signup', CURRENT_TIMESTAMP);

-- 读取时使用同一个 swap=1,恢复为可复制的 UUID 文本
SELECT BIN_TO_UUID(id, 1) AS id, event_name, created_at
FROM account_event;
最容易漏掉的是读取侧:写入使用 UUID_TO_BIN(uuid, 1),读取却写成 BIN_TO_UUID(id)。这不是格式化差异,而是逆变换参数不一致。建议把转换固定在 DAO、视图或查询模板中,让业务代码始终接触字符串 UUID,避免不同调用方各自决定 swap 参数。
把重排后的值放进索引设计
InnoDB 的主键是聚簇索引,主键值会参与数据组织。对于时间型 UUID,swap=1 会让时间字段处于二进制值前部,连续生成的 ID 更有机会在索引中落在相近范围,减少完全随机插入带来的页分散。这里说的是布局上的工程收益,不是保证每次插入都递增,也不是对查询结果增加隐式排序。
因此,下面两件事要分开:
| 目标 | 做法 | 不能推导出的结论 |
|---|---|---|
| 缩短主键存储 | 使用 BINARY(16) 保存 UUID 二进制值 | 不能说明业务层看到的是数字自增 ID |
| 改善时间型 UUID 的布局 | 写入、读取都使用 swap=1 | 不能把它当成 SQL 的隐式 ORDER BY |
| 获得最新记录 | 显式按 created_at 或可靠时间字段排序 | 不能只按二进制主键顺序猜测时间 |
检查迁移和随机 UUID 的边界
从字符串列迁移到 BINARY(16) 时,先确定旧数据到底是时间型还是随机型,并把转换规则写进迁移脚本。不能一部分数据按 swap=0 写入、另一部分按 swap=1 写入后再混用同一个读取函数,否则同一列会存在两种字节布局。
-- 迁移示例:旧列 uuid_text 统一按已确认的时间型 UUID 规则转换
ALTER TABLE account_event
    ADD COLUMN id_bin BINARY(16) NULL;

-- 只在确认历史 UUID 使用时间字段布局后才采用 swap=1
UPDATE account_event
SET id_bin = UUID_TO_BIN(uuid_text, 1);

-- 迁移完成后检查转换列是否仍有 NULL,再决定约束切换
SELECT COUNT(*) AS missing_binary_id
FROM account_event
WHERE id_bin IS NULL;
如果历史值来自随机 UUID,就使用 swap=0,或者继续使用字符串方案;如果业务真正需要严格递增、分片友好或跨服务统一生成,应单独评估自增序列、时间序列 ID 等方案。swap=1 只解决特定 UUID 字节布局问题。
常见问题
swap=1 会让 UUID_TO_BIN 的结果按时间自然递增吗?
不会。它只重排时间型 UUID 的字段,不能替代显式排序,也不能改变 UUID 的生成来源。
为什么 BIN_TO_UUID 读回来的字符串看起来不一样?
先检查写入和读取是否使用同一个 swap 参数,并确认列是 BINARY(16) 而不是经过字符集转换的字符串列。
随机 UUID 能不能直接使用 swap=1?
不建议。随机 UUID 没有可利用的时间字段,传入 1 不会带来时间顺序,还会让团队误读数据布局。
怎样查询最新一条记录?
使用可靠的时间列或业务序列显式 ORDER BY,不要依赖二进制 UUID 的物理布局。
记住这条判断即可:先确认 UUID 类型,再决定 swap;一旦选择了参数,写入、读取、迁移和索引说明都保持一致。
-
374 收藏
-
499 收藏
-
384 收藏
-
234 收藏
-
184 收藏
-
数据库 · MySQL | 17分钟前 | 事务 · 并发控制 · InnoDB · MySQL教程 · mysql innodb 事务隔离级别 Serializable READ COMMITTED REPEATABLE READ188 收藏
-
462 收藏
-
382 收藏
-
235 收藏
-
295 收藏
-
275 收藏
-
283 收藏
-
数据库 · MySQL | 15小时前 | MySQL · 错误排查 · mysql 空间数据 长度单位 ST_FrechetDistance SRID 0 ER_GEOMETRY_IN_UNKNOWN_LENGTH_UNIT360 收藏
-
448 收藏
-
436 收藏
-
335 收藏
-
425 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习