
Python csv.field_size_limit 怎样处理超长字段
来源:17golang原创
时间:2026-11-15 16:25:33 301浏览 收藏
读取 CSV 时如果某个字段特别长,csv.reader 可能抛出 csv.Error,这不一定是分隔符或引号写错了。先调用 csv.field_size_limit() 读取当前上限,再根据业务允许的字段长度设置一个明确的新值即可;不要直接把原始文本按行截断,否则可能破坏带换行符的字段。
官方文档:https://docs.python.org/3.14/library/csv.html#csv.field_size_limit
先理解 field_size_limit 管的是什么
csv.field_size_limit() 管的是解析器允许的单个字段最大长度。无参数调用返回当前限制;传入 new_limit 后,新的限制会成为后续 CSV 解析使用的限制,并返回设置后的限制值。它解决的是“一个字段过长”,不是“这一行列数太多”,也不是通用的 CSV 格式修复器。
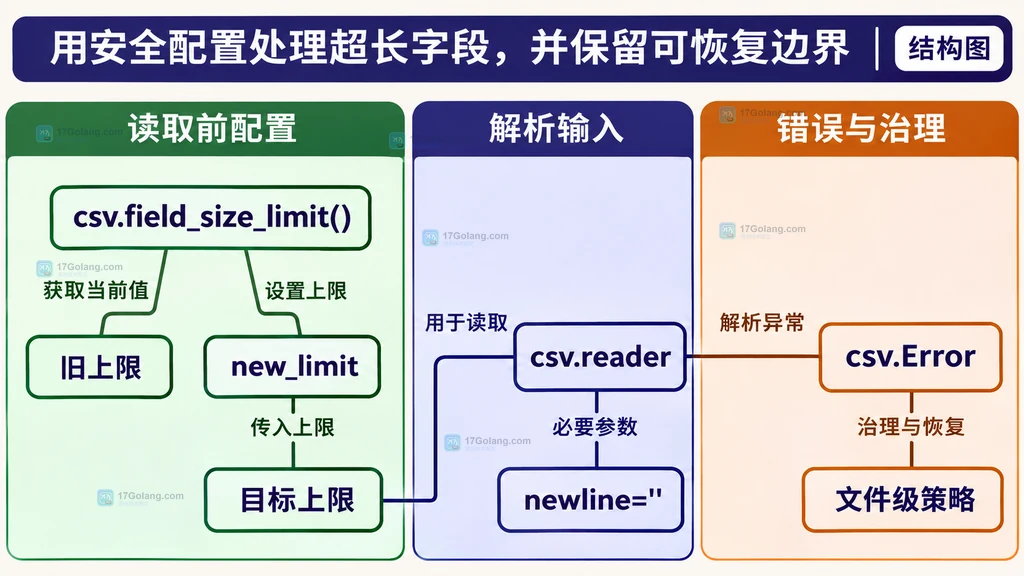
可以先把当前配置记下来,排查时把实际值写入日志:
import csv

# 读取当前解析器限制,不猜测不同运行环境的默认值。
current_limit = csv.field_size_limit()
print(f"当前字段上限: {current_limit}")

# 只有业务确实允许更长字段时才提高限制;这里的数值应来自输入契约。
target_limit = 2_000_000
if target_limit > current_limit:
    applied_limit = csv.field_size_limit(target_limit)
    print(f"应用字段上限: {applied_limit}")
用 newline='' 打开文件并在读取边界调整
官方文档建议文件对象使用 newline='' 传给 csv.reader,让 CSV 模块自己处理记录中的换行。字段很长时,仍然应该让解析器看到完整输入,再由字段长度限制决定是否接受。
下面的函数只调整 CSV 解析边界,不改变文件内容;同时保留旧限制,便于函数结束后恢复:
import csv

def read_csv_with_limit(path: str, limit: int = 2_000_000) -> list[list[str]]:
    # 记录旧配置,避免一次导入影响同一进程中的其他 CSV 任务。
    old_limit = csv.field_size_limit()
    try:
        if limit  old_limit:
            csv.field_size_limit(limit)

        with open(path, "r", encoding="utf-8", newline="") as handle:
            # reader 负责处理引号、分隔符和跨行字段,不要手动 split(',')。
            return list(csv.reader(handle))
    except csv.Error as exc:
        # 把解析异常保留为 csv.Error,调用方才能区分输入问题和系统异常。
        raise RuntimeError(f"CSV 字段或格式超过读取边界: {path}") from exc
    finally:
        # 恢复进程内的旧限制,避免共享服务的后续任务继承本次配置。
        csv.field_size_limit(old_limit)
这里的 list(csv.reader(...)) 适合小型导入示例。生产任务如果文件很大,应改成逐行消费,避免为了放宽字段限制又把整份文件一次性放入内存。
超长字段与格式错误怎样区分
当读取器在字段长度边界处失败时,优先记录 reader.line_num、文件标识和生效的上限。不要仅凭“报错发生在某一行”就断定该行的引号或分隔符损坏:一个合法的长文本字段同样可能触发限制。
import csv

def iter_csv_rows(path: str, limit: int):
    # 在迭代边界设置限制,保持每次只处理一个记录。
    old_limit = csv.field_size_limit()
    csv.field_size_limit(limit)
    try:
        with open(path, "r", encoding="utf-8", newline="") as handle:
            reader = csv.reader(handle)
            for row in reader:
                # line_num 可能跨越多行,因为一个 CSV 记录可以含换行字段。
                yield reader.line_num, row
    except csv.Error as exc:
        # 记录当前文件与已读行号,保留原异常作为根因。
        raise RuntimeError(f"CSV 解析失败: file={path}, line={reader.line_num}") from exc
    finally:
        # 生成器关闭或遍历结束后恢复旧限制。
        csv.field_size_limit(old_limit)
这段代码的重点不是把所有错误都包装成同一个异常,而是保留 csv.Error 作为原因。若提高上限后仍失败,再检查引号闭合、分隔符、编码和输入是否真的符合目标 CSV 方言。
共享进程里为什么要保存并恢复旧值
field_size_limit 是 csv 模块级的解析配置。脚本只读取一种文件时,可以在入口处设置一次;服务进程或插件系统里,最好把调整包在一个明确的函数边界中,并恢复调用前的旧值。否则,一个导入任务为了接收超长字段而放宽限制,可能让同一进程里的其他任务接受超出原输入契约的数据。
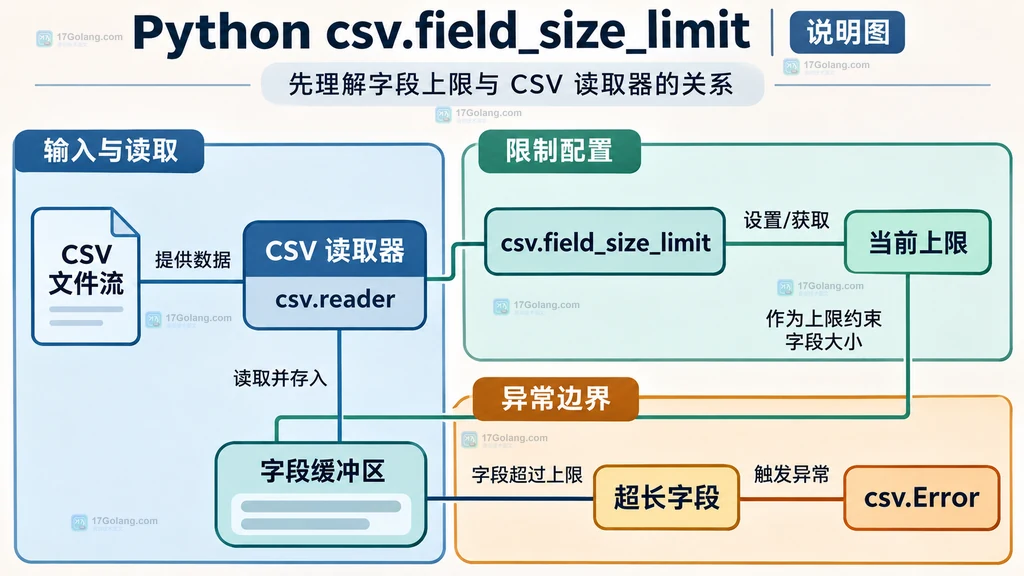
因此,目标上限应来自输入契约,而不是简单使用一个无法解释的极大整数。可以按以下方式决策:
| 现象 | 优先判断 | 处理方式 |
|---|---|---|
| 字段超过当前限制 | 输入是合法长文本,还是异常膨胀 | 确认契约后提高上限,并保留资源预算 |
| 提高限制后仍报错 | 可能是引号、编码或方言问题 | 检查 CSV 语法与打开参数,不要继续盲目放大 |
| 不同任务需要不同限制 | 共享进程配置会互相影响 | 保存旧值,在局部读取边界设置并恢复 |
| 文件非常大 | 字段限制与总内存是两件事 | 逐行消费,避免 list(reader) 放大内存 |
最后用清单确认这次调整可控
- 确认问题是单个字段过长,而不是列数、编码或引号错误。
- 调用无参数的
csv.field_size_limit()记录现状,再设置有业务依据的目标值。 - 文件使用
newline=""打开,不用split(',')替代 CSV 解析。 - 捕获
csv.Error时记录文件标识、reader.line_num和生效限制。 - 共享进程内保存并恢复旧限制;大文件优先逐行处理。
常见问题
csv.field_size_limit() 能解决列数太多吗?
不能。它针对单个字段的最大长度;列数、分隔符和引号属于其他解析问题。
为什么不直接设置成 sys.maxsize?
极大限制不能替代输入治理,也可能掩盖异常膨胀并增加内存压力。更稳妥的做法是根据字段契约设置目标值,并保留失败日志。
设置一次后还需要恢复吗?
单次脚本通常不必,但长驻进程、插件或多租户任务应恢复旧值,减少任务之间的隐式配置耦合。
-
369 收藏
-
344 收藏
-
464 收藏
-
327 收藏
-
361 收藏
-
346 收藏
-
486 收藏
-
200 收藏
-
334 收藏
-
133 收藏
-
282 收藏
-
344 收藏
-
366 收藏
-
400 收藏
-
317 收藏
-
427 收藏
-
文章 · python教程 | 16小时前 | 标准库 · 异常处理 · Python教程 · 错误排查 · Python 异常链 traceback ExceptionGroup TracebackException __cause__ __context__ 日志排障488 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习