
Linux perf record定位CPU热点
来源:17golang原创
时间:2026-11-15 17:01:33 418浏览 收藏
Linux 上遇到某个服务 CPU 长时间偏高时,我通常先用 perf record 做一段带调用栈的采样,再用 perf report 按开销占比看热点函数。它记录的是一组采样样本,不是“已经找到根因”的结论;真正有用的结果来自明确的采样范围、完整的符号和对调用链的再次判断。
官方文档:https://www.kernel.org/doc/html/latest/
最小闭环可以记成:针对一个已知工作负载运行perf record -F 99 -g -- ./your-program,生成perf.data,然后用perf report --stdio找到高开销函数,再决定是否进入perf annotate或代码级排查。
perf record 到底记录了什么
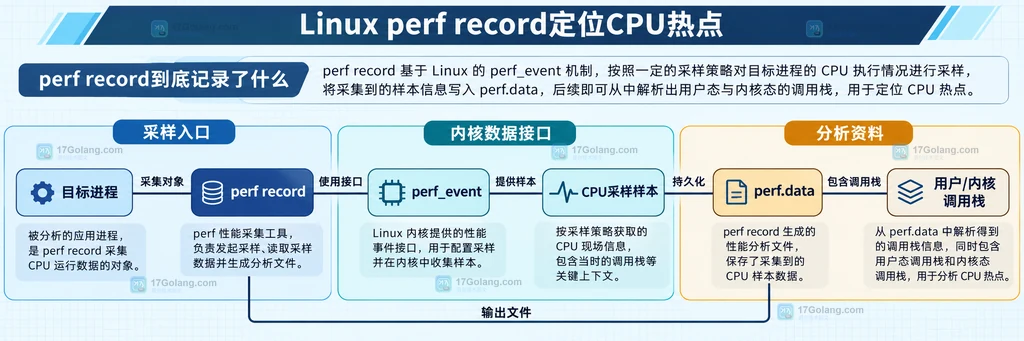
perf record 会启动或附着到目标任务,利用内核的 perf 事件接口收集采样,并把结果写入 perf.data。加上 -g 后,样本还会带上用户态和内核态调用栈,后续报告才有机会回答“热点函数是从哪条调用链过来的”。
因此,perf record 的直接产物是采样数据,perf report 才负责读取并呈现 profile。某个函数占比高,表示采样期间程序的指令位置经常落在那里;它值得继续追踪,但不能单独证明这个函数就是唯一根因。
先把采样范围限定在真正的工作负载
如果可以控制程序的启动方式,优先让 perf record 包住一次明确的请求、批处理或压测场景。下面的命令使用软件时钟事件和调用栈,输出文件名也显式写出,方便和不同场景的报告对应。
# -F 控制采样频率,-g 保存调用栈;-- 后面是要分析的目标程序
perf record -F 99 -g -o perf.data -- ./your-program --workload sample

# 读取刚生成的 profile,使用文本界面便于保存到工单或日志
perf report --stdio -i perf.data

# 如果还需要看某个函数的源码/汇编位置,再从同一个数据文件进入细化视图
perf annotate -i perf.data
-F 99 是一个常见的起始值,不是固定标准;采样频率越高,观察细节越多,同时也要考虑采集开销和数据体积。-g 会记录调用链,调用链的展开方式还受到程序是否保留帧指针、是否有 DWARF 信息等条件影响。
对于已经运行的进程,可以使用进程号附着,而不是重新启动服务:
# 把 PID 替换成需要观察的进程号,-p 只针对这个已有进程采样
perf record -F 99 -g -p 12345 -o perf.data

# 结束采样后从指定文件读取函数开销和调用链
perf report --stdio -i perf.data
附着模式更适合线上短时观察,但要先确认采样窗口内确实发生了目标请求;如果进程处于空闲状态,报告里的“热点”只代表空闲窗口里的活动,不能代表业务高峰。
用 perf report 把样本收敛成热点函数
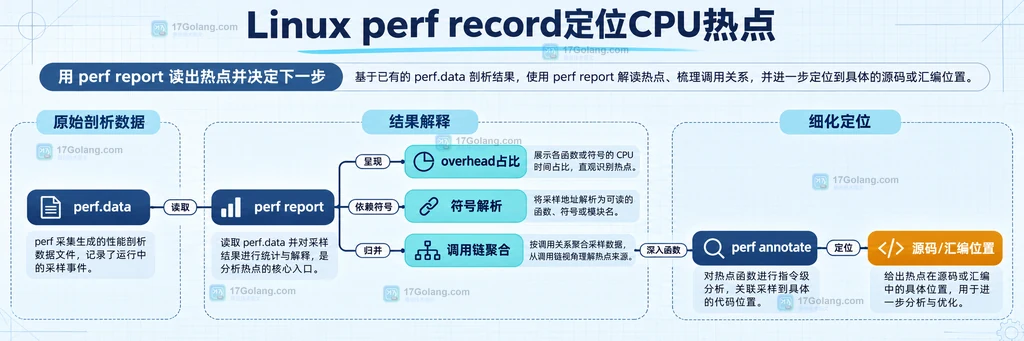
perf report 读取 perf.data 并展示 profile。刚开始排查时我会先看文本输出,先确认报告里是否有目标进程、事件类型、样本数量和可解析的符号,再看 Overhead 较高的函数。调用链完整时,再把父函数和子函数放在一起判断,避免只盯住一行叶子函数。
# --stdio 输出可复制的报告;--children 让子调用的开销也能汇总到父函数
perf report --stdio --children -i perf.data

# -n 显示每个符号对应的样本数量,适合和开销百分比一起看
perf report --stdio -n -i perf.data

# perf script 展开原始采样记录,适合需要进一步加工或保留调用链文本时使用
perf script -i perf.data
报告中的函数名依赖符号解析。二进制被裁剪、构建时没有保留可用调试信息、容器里的符号文件与实际运行版本不匹配时,报告可能只显示地址、动态库名或不完整的调用栈。此时继续讨论“谁最耗 CPU”容易把符号缺失误判成业务结论。
调用栈、符号和权限是三道边界
CPU 热点定位最容易卡在三个地方:调用栈收不上来、符号对不上、采样权限不允许。它们分别影响“能否看到上层调用者”“能否把地址翻译成函数名”和“能否开始采样”,排查时不要混为一个问题。
- 调用栈不完整:先看
-g使用的调用图方式。默认的帧指针方式要求程序的栈信息满足对应条件;如果程序省略了帧指针,可以根据发行版和 perf 构建能力考虑--call-graph dwarf,但它会增加栈数据和采集成本。 - 符号显示不全:保留与运行二进制相匹配的符号或调试文件,并让报告使用正确的符号路径。不要把一份旧构建的符号文件拿来解释另一份已部署文件。
- 权限被拒绝:Linux 内核的 perf 安全策略会影响普通用户能观察哪些任务和事件。先查看当前策略和运维规则,不要为了让命令“跑起来”就直接降低全机安全限制。
# 先记录内核当前对 perf 事件的限制,结果只用于判断权限边界
sysctl kernel.perf_event_paranoid

# 查看本机 perf 与内核帮助,确认当前构建支持哪些调用图选项
perf version
perf record --help | grep -E -- '--call-graph|-F|--pid'
权限、符号和调用栈都正常时,报告才适合进入代码优化;否则更稳妥的做法是先补齐采样条件,再重新采一段与原问题相同的工作负载。
我会怎样把热点报告变成下一步动作
如果报告里某条调用链长期占据较高开销,我会先问三个问题:它是否覆盖了真正的业务窗口?它的父调用者是否也高?它代表的是业务代码、运行时、系统调用还是动态库?这一步的目的不是马上改代码,而是把采样结果和问题现场重新对齐。
| 看到的现象 | 下一步关注点 |
|---|---|
| 单个业务函数占比高且调用栈完整 | 进入源码或 perf annotate,检查循环、锁、序列化和重复计算 |
| 热点集中在动态库或运行时 | 确认输入规模、调用频率和上层业务调用链,不要只改库内部 |
| 大量地址没有函数名 | 先补齐匹配的符号和构建信息,再重新解释报告 |
| 采样结果不稳定 | 固定采样窗口、事件类型和工作负载,比较多次报告中的共同部分 |
和只看一瞬间的 top 相比,perf record 的优势是能把一段工作负载保存下来,后面反复用 perf report、perf script 或 perf annotate 分析;代价是需要更明确地处理采样权限、符号和数据文件管理。
相关问题
perf record 只看一个进程可以吗?
可以。对已有进程使用 -p PID,对新启动的命令则把目标程序放在 -- 后面。两种方式都要保证采样窗口覆盖真正发生 CPU 压力的工作负载。
为什么 perf report 里看不到函数名?
常见原因是符号文件缺失、二进制与符号版本不匹配,或调用栈展开条件不足。先处理符号和调用栈,再解释开销百分比。
采样频率是不是越高越好?
不是。更高频率会带来更密集的样本,也可能增加采集开销和数据量。先选择能覆盖问题窗口的频率,再按报告稳定性调整。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习