
Python sqlite3.Connection.setlimit 怎样限制单个连接的资源上限
来源:17golang原创
时间:2026-11-16 23:24:07 247浏览 收藏
Python 的 sqlite3.Connection.setlimit() 适合解决“同一个 SQLite 连接不能超过某项资源上限”的问题,例如限制附加数据库数量或 SQL 文本长度。它设置的是连接级运行时限制,不是修改数据库文件配额;调用后会返回修改前的值,配合 getlimit() 就能判断当前连接到底处于什么状态。
官方文档:https://docs.python.org/3/library/sqlite3.html#sqlite3.Connection.setlimit
下面把它和“直接改 SQLite 编译参数”“在业务代码里自行计数”放在同一条判断线上,帮助你选对控制点。示例只展示 API 关系,不代表本文已经在本机运行过命令或产生过运行结果。
先判断你要限制的是连接行为还是数据库容量
setlimit(category, limit) 的作用域是一个已经创建的 Connection 对象。它可以把 SQLite 暴露的运行时限制调低;如果尝试超过 SQLite 的硬上限,值会被截断到硬上限;如果 limit 是负数,则保持当前值不变。它不会替你限制磁盘空间、单个表的行数,也不会跨连接同步配置。
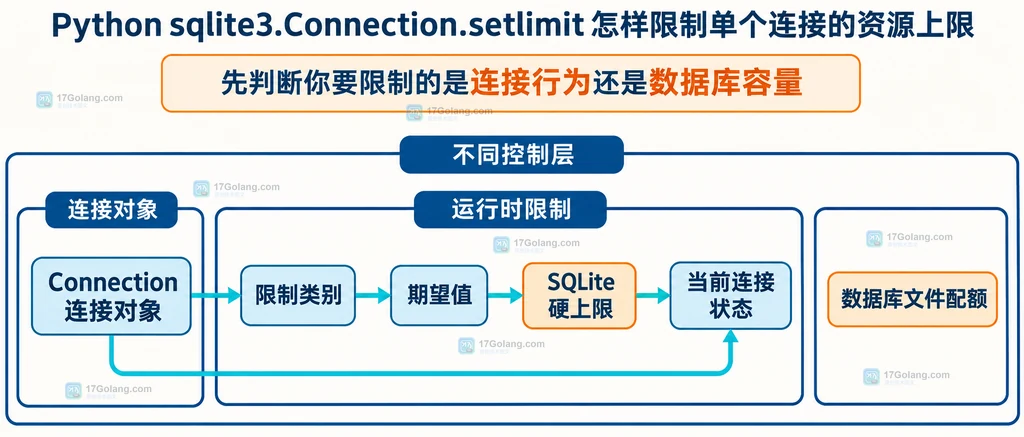
因此,下面三种需求不要混在一起:
| 需求 | 更合适的控制点 | 是否由 setlimit 直接解决 |
|---|---|---|
| 限制某个连接可附加的数据库数量 | SQLITE_LIMIT_ATTACHED | 可以 |
| 限制一条 SQL 文本的最大长度 | SQLITE_LIMIT_SQL_LENGTH | 可以 |
| 限制数据库文件占用的磁盘空间 | 文件系统、配额或业务写入策略 | 不可以 |
| 让所有连接共享同一项策略 | 连接创建工厂或统一初始化代码 | 不能自动共享 |
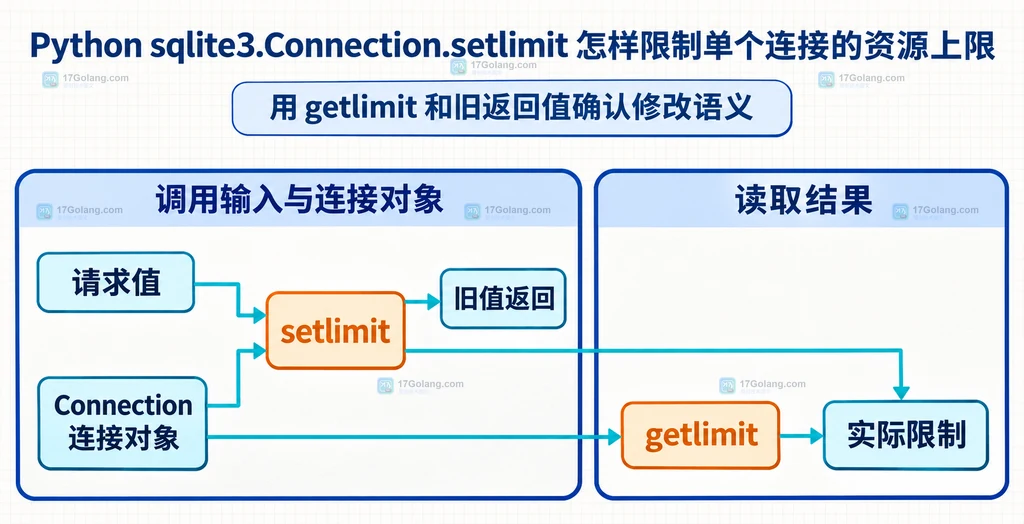
用 getlimit 和旧返回值确认修改语义
这组 API 最容易误读的地方是返回值:setlimit() 返回的是调用前的限制,不是调用后的新限制。要读新状态,应紧接着调用 getlimit()。把两者写在一起,可以区分“请求的值”“实际生效值”和“调用前的值”。
import sqlite3

con = sqlite3.connect(":memory:")
try:
    category = sqlite3.SQLITE_LIMIT_ATTACHED
    before = con.getlimit(category)  # 读取这个连接在修改前的上限
    previous = con.setlimit(category, 1)  # 返回旧值;负数才表示保持不变
    after = con.getlimit(category)  # 重新读取,确认连接当前实际限制
    print({"before": before, "previous": previous, "after": after})
finally:
    con.close()  # 示例结束后显式关闭连接,避免把资源生命周期留给解释器
如果 previous 与 before 不一致,先检查是否有其他初始化逻辑改过同一个连接;如果 after 小于请求值,则可能是 SQLite 的硬上限或调用方传入了不同的类别。不要只根据返回的旧值断言新配置已经生效。
附加数据库数量是一个直观的选型例子
如果应用只允许一个连接附加一个外部数据库,可以在连接工厂里设置 SQLITE_LIMIT_ATTACHED。这比在业务层维护一个“已附加数量”计数更靠近 SQLite 的实际约束,也不会因为异常路径漏记计数而失真。
import sqlite3

def open_connection(path: str) -> sqlite3.Connection:
    con = sqlite3.connect(path)
    # 让这个连接最多附加一个数据库,策略只对当前 Connection 生效
    con.setlimit(sqlite3.SQLITE_LIMIT_ATTACHED, 1)
    return con

con = open_connection(":memory:")
try:
    # 业务代码在这里使用 con;不同连接需要各自经过同一工厂
    current = con.getlimit(sqlite3.SQLITE_LIMIT_ATTACHED)
    print(current)
finally:
    con.close()  # 统一关闭工厂创建的连接
这个例子没有把限制伪装成跨连接的全局安全策略。若应用还会在别处直接调用 sqlite3.connect(),那些连接不会自动继承工厂里的设置,必须把初始化入口收拢。
SQL 长度限制适合放在受控连接上
SQLITE_LIMIT_SQL_LENGTH 适合用来约束某个连接接受的 SQL 文本规模,尤其是应用有明确的查询模板、希望避免把超长文本当成 SQL 发送时。它仍然是 SQLite 连接行为的限制,不等于请求体大小限制,也不替代参数绑定。
import sqlite3

con = sqlite3.connect(":memory:")
try:
    # 限制当前连接可接受的 SQL 文本长度;实际值仍受 SQLite 硬上限影响
    con.setlimit(sqlite3.SQLITE_LIMIT_SQL_LENGTH, 100_000)
    sql_limit = con.getlimit(sqlite3.SQLITE_LIMIT_SQL_LENGTH)
    print({"sql_limit": sql_limit})
finally:
    con.close()  # 即使读取限制失败,也确保连接释放
如果真正要限制的是 HTTP 请求、消息队列消息或用户输入,应在对应入口先做大小控制;如果要防止 SQL 注入,应使用参数绑定。把多个层次的限制都命名成“SQL 长度限制”,会让故障定位变得困难。
三种方案怎么选
| 方案 | 优点 | 代价与边界 | 适用判断 |
|---|---|---|---|
Connection.setlimit() | 作用域清楚,读取和修改都在连接对象上 | 每个连接要初始化,不覆盖磁盘配额 | 需要 SQLite 原生连接级限制 |
| 统一连接工厂 | 能让多个业务入口使用同一套设置 | 绕开工厂的连接仍可能漏配 | 应用有多个连接并需要一致策略 |
| 业务层自行计数 | 可表达业务自定义规则 | 异常、并发和多进程下容易与实际状态偏离 | 原生限制无法表达的业务约束 |
| SQLite 编译或部署级设置 | 可以形成更底层的统一边界 | 变更和部署成本高,不能替代连接初始化 | 需要固定构建策略并由平台统一管理 |
一般建议是:先用 setlimit() 表达 SQLite 能直接表达的连接级约束;再用连接工厂保证初始化覆盖面;只有当限制属于业务语义时,才在业务层补充计数或配额。三层可以组合,但不要把业务层计数当成 SQLite 当前限制的读取结果。
常见误区和落地清单
- 不要把
setlimit()当成全局配置;每个Connection都要经过初始化入口。 - 不要把
setlimit()的返回值当成新值;旧值与新值分别由返回值和getlimit()表示。 - 不要忽略负数参数的语义;负数表示保持当前限制,不是把限制设置成负数。
- 不要把 SQLite 的硬上限当成请求值;修改后读取实际值,才能知道是否被截断。
落地时可以按这个顺序处理:确定要限制的 SQLite 类别;统一连接创建入口;设置较低的期望值;读取旧值和实际值;最后把连接关闭与异常处理放在同一生命周期里。
setlimit 能限制数据库文件大小吗?不能。它针对 SQLite 连接暴露的运行时限制,文件大小应由文件系统、配额或业务写入策略处理。
为什么 setlimit 设置后读到的值不是请求值?SQLite 的硬上限可能更低;另外也要确认读取和修改使用的是同一个限制类别、同一个连接。
多个 sqlite3.connect() 会共享限制吗?不会自动共享。把设置放进统一连接工厂,并避免业务代码绕过工厂创建连接。
-
267 收藏
-
255 收藏
-
文章 · python教程 | 25分钟前 | SQLite · Python教程 · Python SQLite sqlite3 complete_statement 多语句脚本 CREATE TRIGGER140 收藏
-
290 收藏
-
256 收藏
-
299 收藏
-
文章 · python教程 | 46分钟前 | 依赖管理 · 故障排查 · Python教程 · Python importlib.metadata packages_distributions 发行包 导入名138 收藏
-
417 收藏
-
235 收藏
-
443 收藏
-
283 收藏
-
229 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习