
FAISS IndexIDMap2 怎样按自定义 ID 删除向量
来源:17golang原创
时间:2026-11-18 00:26:04 334浏览 收藏
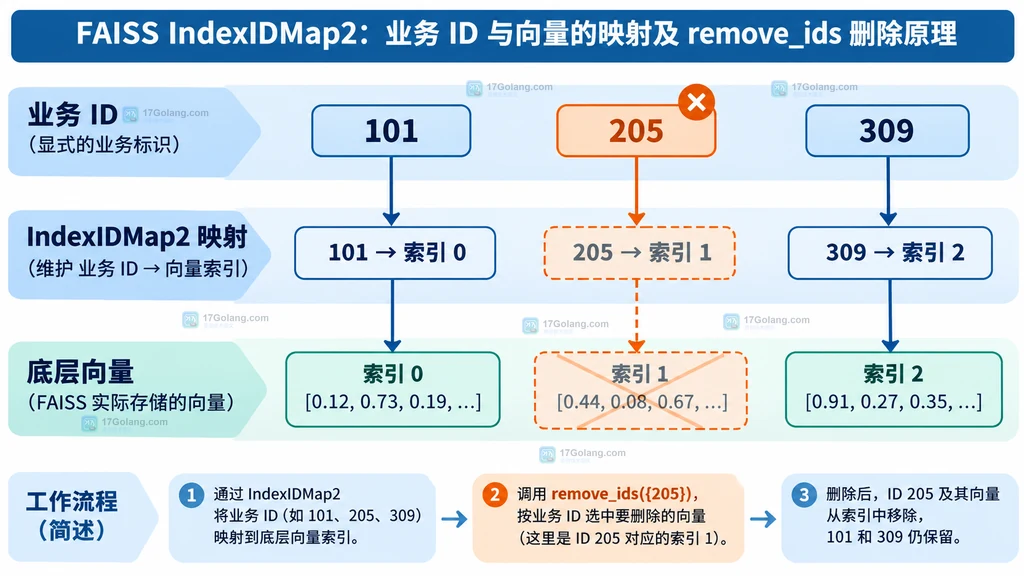
如果业务表里的主键已经是 101、205、309 这类自定义 ID,不要把它们重新压成 0、1、2 再交给 FAISS。用 IndexIDMap2 包住底层索引后,通过 add_with_ids 写入向量和业务 ID,删除时把同一批业务 ID 交给 remove_ids 即可。返回值是实际删除的数量,ntotal 则反映删除后的索引条目数。
最小做法是:mapped.add_with_ids(vectors, ids)写入,removed = mapped.remove_ids(ids_to_remove)删除;删除参数代表显式 ID,不代表当前向量的位置。IndexIDMap2中其它显式 ID 不会因为删除而整体前移。
官方地址:https://github.com/facebookresearch/faiss/wiki/Special-operations-on-indexes
一、先分清底层位置和业务 ID
FAISS 的底层索引负责存储和检索向量,IndexIDMap2 负责维护“业务 ID ↔ 向量条目”的关系。底层使用 IndexFlatL2 时,直接调用它的 add_with_ids 并不成立;包装后才可以把任意的 64 位整数 ID 作为标签写入。
这里有三个容易混淆的数字:
| 概念 | 含义 | 删除时是否直接使用 |
|---|---|---|
| 业务 ID | 例如 101、205,由应用保存并传给 FAISS | 是 |
| 内部位置 | 底层数组当前的槽位,不是稳定业务标识 | 否 |
| 搜索标签 | search 返回的 label,使用映射后就是业务 ID | 可用于回查 |
二、用 add_with_ids 写入自定义 ID
向量数组必须与 ID 数组一一对应,通常使用 int64 保存 ID,向量使用连续的 float32 数组。下面的示例只展示映射和删除所需的最小准备,不涉及模型生成向量。
import faiss
import numpy as np

# 三条向量的维度都是 4,实际项目中应替换成已经生成的 float32 向量
vectors = np.asarray([
    [0.10, 0.20, 0.30, 0.40],
    [0.20, 0.10, 0.40, 0.30],
    [0.90, 0.80, 0.70, 0.60],
], dtype="float32")

# 业务主键使用 int64;数组顺序必须和 vectors 行顺序一致
ids = np.asarray([101, 205, 309], dtype="int64")

# IndexIDMap2 在底层平面索引上保存显式 ID,并额外支持按 key 重建
base = faiss.IndexFlatL2(vectors.shape[1])
mapped = faiss.IndexIDMap2(base)
mapped.add_with_ids(vectors, ids)

# ntotal 是当前索引中的向量数量,不是最后一个业务 ID
print(mapped.ntotal)
写入后,搜索结果中的标签会是 101、205、309,而不是 0、1、2。应用层可以直接用这个标签回查业务表,但要确保一个索引内的显式 ID 具有清晰的唯一性约束。
三、用 remove_ids 按业务 ID 批量删除
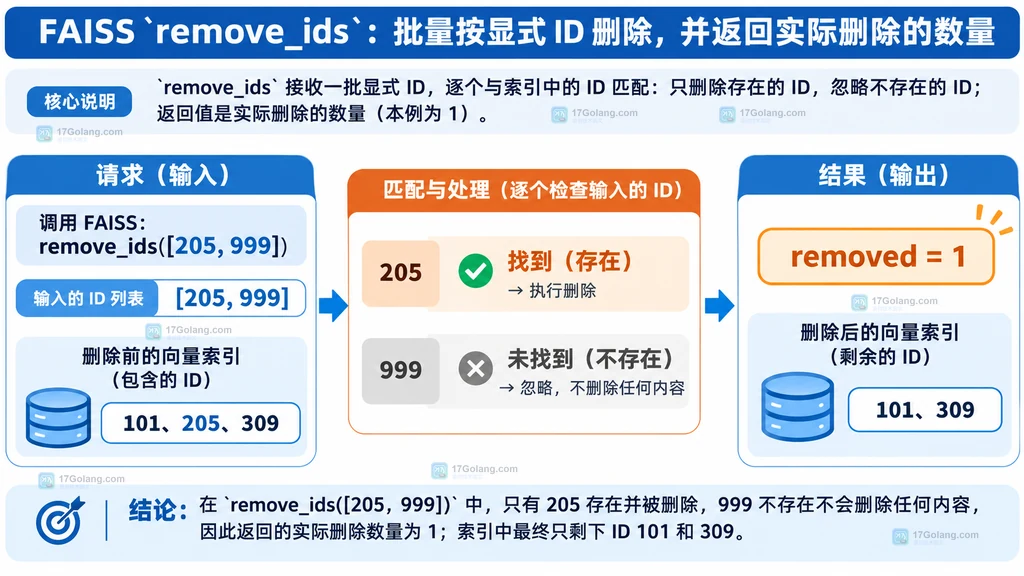
Python 接口可以接收 NumPy 数组形式的待删除 ID。删除是按显式 ID 匹配的:数组里放 205,就会尝试删除 ID 为 205 的向量,而不是删除当前下标为 205 的槽位。
# 只放需要删除的业务 ID;不存在的 ID 不会误删其它向量
ids_to_remove = np.asarray([205, 999], dtype="int64")
removed = mapped.remove_ids(ids_to_remove)

# removed 是本次真正移除的数量;999 不存在,所以只删除 205
print("removed:", removed)
print("remaining:", mapped.ntotal)
如果输入中包含一个不存在的 ID,返回数量不会把它算进去。把“请求删除了几个 ID”和“实际删除了几个条目”分开记录,批处理日志会更容易排查。
四、根据返回值和 ntotal 判断结果
删除操作最值得关注的是两个结果:removed 和 mapped.ntotal。前者回答“这次删掉了多少条”,后者回答“索引现在还剩多少条”。不要只根据没有抛出异常就认为所有 ID 都已删除。
before = mapped.ntotal
requested = np.asarray([101, 1001], dtype="int64")

# 返回值用于区分全命中、部分命中和完全未命中
removed = mapped.remove_ids(requested)
after = mapped.ntotal

if removed == len(requested):
    print("all requested IDs were removed")
elif removed == 0:
    print("no requested ID was present")
else:
    print("partially removed")

# 对于删除成功的条目,数量变化应与 removed 一致
print("delta:", before - after)
生产代码可以额外在应用数据库里记录本次请求的 ID、实际删除数量和删除后的 ntotal。这属于状态同步记录,不要把它当成 FAISS 的事务回滚机制:如果应用层还有一份元数据,仍需要自行处理两边的失败恢复。
五、删除后为什么其它 ID 不会整体前移
顺序数组删除元素时,后面的数组位置通常会向前移动;但 IndexIDMap2 存储的是显式 ID,删除 205 不会把 309 改成 205。也就是说,业务 ID 是稳定标签,内部存储位置则可以变化,应用不应保存内部位置作为长期引用。
如果需要按 key 重建向量,IndexIDMap2 还提供了以显式 ID 为入口的能力;找不到 key 时应把异常当成“记录已删除或映射不一致”处理,而不是自动换用数组下标。
key = 309
try:
    # key 是写入时的业务 ID,不是搜索结果数组的下标
    vector = mapped.reconstruct(key)
    print(vector.shape)
except RuntimeError as exc:
    # key 不存在时保留上下文,交给上层决定是否回查元数据
    print("reconstruct failed:", exc)
六、适合放进维护任务的完整流程
- 从业务表取出待删除的唯一 ID,规范化为
int64数组。 - 调用
remove_ids,保存返回的实际删除数量。 - 比较删除前后的
ntotal,识别全命中、部分命中和空命中。 - 同步更新外部元数据,但不要按数组位置重写其它业务 ID。
- 若后续需要重建,继续用显式 key 调用
reconstruct,并处理 key 不存在的情况。
这个流程适合一次删除一批已知 ID。官方说明指出,remove_ids 默认需要扫描索引来判断哪些元素匹配,所以频繁删除少量记录时,应结合索引规模、删除频率和重建策略评估成本;本文不把删除接口包装成低延迟事务接口。
常见问题
remove_ids 传的是向量位置吗?
不是。对于 IndexIDMap2,传入的是通过 add_with_ids 写入的显式 ID。
删除不存在的 ID 会报错吗?
通常不会把不存在的 ID 计入删除数量,应该以返回值判断命中情况。
IndexIDMap 和 IndexIDMap2 怎样选?
两者都用于显式 ID 映射;如果还需要按 key 重建已存向量,优先确认底层索引和 Python 绑定支持 IndexIDMap2 的重建能力。
总结
IndexIDMap2 删除向量的关键只有三点:写入时用 add_with_ids 保存稳定业务 ID,删除时用同一 ID 集合调用 remove_ids,结果判断同时看返回数量和 ntotal。只要不把内部位置当业务主键,删除后的 ID 映射就能保持清晰。
-
346 收藏
-
235 收藏
-
387 收藏
-
447 收藏
-
360 收藏
-
212 收藏
-
301 收藏
-
313 收藏
-
294 收藏
-
195 收藏
-
403 收藏
-
230 收藏
-
231 收藏
-
294 收藏
-
144 收藏
-
230 收藏
-
375 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习