
Python sqlite3.Connection.interrupt 怎样从线程中止长查询
来源:17golang原创
时间:2026-11-18 05:40:55 287浏览 收藏
Python sqlite3.Connection.interrupt 怎样从线程中止长查询
SQLite 查询跑得比页面、接口或后台任务的等待时间更久时,直接关闭连接并不是一个稳妥的取消方案。Python 的 sqlite3.Connection.interrupt() 专门用于从另一个线程中止该连接上正在执行的查询;被中止的查询会以 sqlite3.OperationalError 结束。
官方地址:https://docs.python.org/3/library/sqlite3.html#sqlite3.Connection.interrupt
最稳妥的模型是:查询线程只负责使用连接执行 SQL,控制线程只持有同一个 Connection 的 interrupt 能力;取消成功后,把这次 OperationalError 识别为预期取消,而不是数据库永久故障。
interrupt 到底跨了哪条线程边界
interrupt() 的关键不是“把 Connection 交给另一个线程”,而是“让另一个线程请求当前连接中止正在执行的查询”。查询线程仍然负责 Cursor.execute(),控制线程不应该拿同一个游标去执行 SQL、读取结果或提交事务。
这一区分很重要:sqlite3.connect() 默认启用 check_same_thread=True,普通连接操作跨线程会触发线程检查;官方文档把 interrupt() 作为从不同线程中止连接查询的专门入口。也就是说,允许跨线程调用的是这个控制方法,不是把连接当成无锁共享对象。
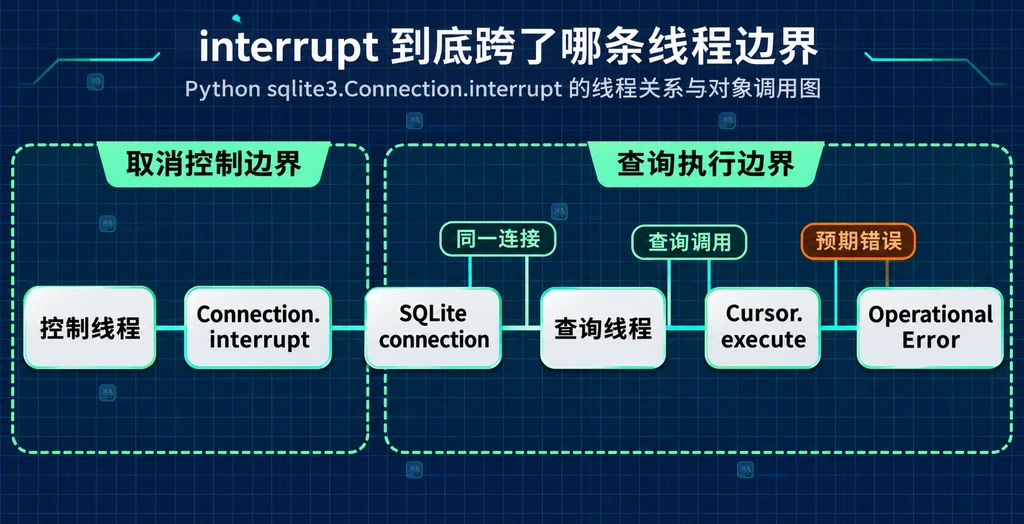
把查询线程和超时控制线程放在同一个模型里
下面的示例使用一个共享的 Connection,让 worker 线程执行查询,主线程等待一个有限时间;超时后只调用 connection.interrupt()。示例中的递归 CTE 只是为了表示可能持续较久的查询,不代表应该用它制造压力。
import sqlite3
import threading
import time

connection = sqlite3.connect(":memory:")
result = {"rows": None, "error": None}

def run_query():
    try:
        # 查询线程只执行 SQL;不要把 cursor 交给控制线程。
        cursor = connection.execute(
            """
            WITH RECURSIVE numbers(value) AS (
                SELECT 1
                UNION ALL
                SELECT value + 1 FROM numbers WHERE value
这个写法的重点有三个:控制线程不碰游标;interrupt() 调用的是正在执行查询的同一连接;等待线程结束后再关闭连接。否则可能出现 worker 仍在使用连接、主线程已经关闭它的竞态。
中止后为什么得到 OperationalError
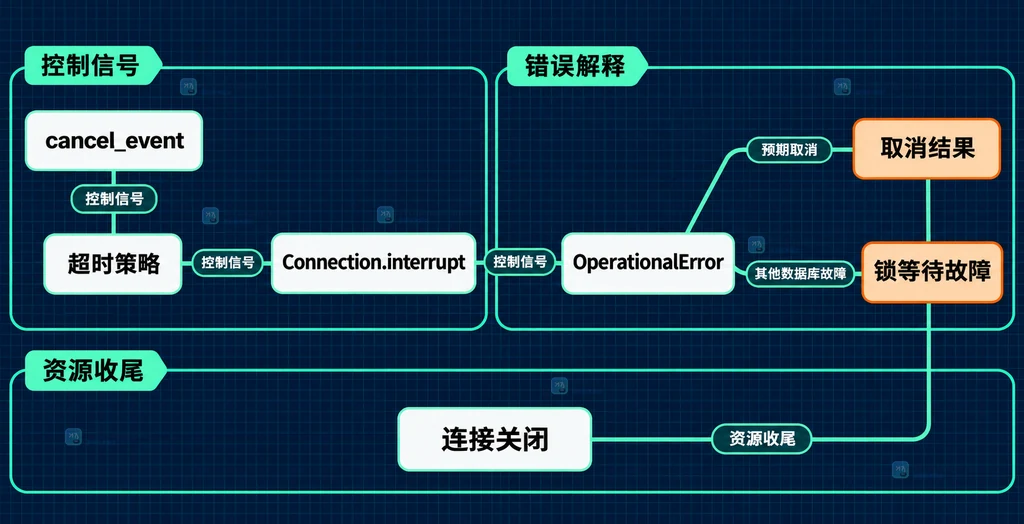
被 interrupt() 中止的查询会报告 OperationalError,但这个异常类型并不只表示“用户点击了取消”。锁等待、数据库文件损坏或其他 SQLite 运行错误也可能使用同一个异常族。因此不要只写一个宽泛的 except 就把所有错误当成正常取消。
可以在发出中止请求前记录一个线程安全的取消标记。示例把“是否主动取消”与异常对象分开保存;生产代码还应把 SQL 场景、请求编号和连接标识写进自己的日志字段。
cancel_requested = threading.Event()

def stop_after(deadline, connection):
    # 只在控制线程决定超时后设置标记,再请求 SQLite 中止。
    if not cancel_requested.wait(deadline):
        cancel_requested.set()
        connection.interrupt()

def classify_error(error):
    # 主动取消和其他 OperationalError 需要不同的上层结果。
    if isinstance(error, sqlite3.OperationalError) and cancel_requested.is_set():
        return "cancelled"
    if isinstance(error, sqlite3.OperationalError):
        return "database-error"
    return "unexpected-error"
取消标记只能说明“本应用发出了中止请求”,不能证明异常一定由这次请求造成。若系统同时存在锁超时、连接关闭或其他线程操作,还要结合发生时间、查询状态和日志上下文判断。
check_same_thread 不等于可以随意共享连接
把 check_same_thread=False 作为“解决一切线程问题”的开关,是这类代码最容易留下的隐患。它只是放宽 Python 层面的线程检查,不会自动替你串行化游标、事务和写操作,也不会让多个查询同时安全地复用同一连接。
如果业务只需要外部取消,优先保留默认线程检查,把连接创建、查询执行和关闭放在明确的 worker 生命周期中,让控制方只调用官方的 interrupt()。只有在确实设计了锁、连接所有权和事务边界时,才讨论放宽检查。
另外,interrupt() 作用于连接上当前正在执行的查询。它不是进程级停止,不会替你回滚已经提交的其他事务,也不等价于销毁数据库文件。中止后的游标和事务状态应由查询线程完成清理,再决定连接是否回收。
生产代码怎样选择取消策略
| 场景 | 建议 | 需要记录 |
|---|---|---|
| 用户取消报表查询 | 设置取消标记并调用同一 Connection 的 interrupt | 请求编号、取消时间、SQL 名称 |
| 接口预算到期 | 超时控制线程发出 interrupt,等待查询线程退出 | 预算时长、错误分类、连接生命周期 |
| 锁等待频繁发生 | 先区分锁错误与主动取消,再处理重试或降级 | 锁等待上下文、重试次数、事务状态 |
| 连接长期复用 | 建立单连接所有权和串行执行规则,必要时取消后回收 | 连接编号、owner、关闭原因 |
如果查询本身经常被中止,interrupt() 只是止损手段,不是性能优化。还应回到索引、返回行数、分页、事务范围和连接池策略上查原因。
常见问题
可以从第三个线程调用 interrupt 吗?
可以把控制职责放在不同线程,但它必须拿到正在执行查询的同一个 Connection。不要把一个连接的控制权和多个执行游标混在一起。
interrupt 会关闭数据库连接吗?
不会。它针对当前正在执行的查询;连接是否继续复用,要在查询线程完成清理、确认事务状态后再决定。
捕获 OperationalError 后直接重试可以吗?
不建议。先判断是否是主动取消、锁等待或其他数据库错误,再根据幂等性和事务状态决定重试。
总结
Connection.interrupt() 解决的是“让另一个线程请求当前查询停止”,不是“让 SQLite 连接可以被任意线程共享”。保留查询线程的连接所有权,用独立取消标记解释 OperationalError,等待 worker 退出后再关闭或回收连接,这三点能把超时控制、错误分类和资源生命周期连起来。
-
346 收藏
-
235 收藏
-
387 收藏
-
447 收藏
-
360 收藏
-
341 收藏
-
文章 · python教程 | 57分钟前 | 错误处理 · 字符集 · Python教程 · Python MIME email.utils collapse_rfc2231_value RFC 2231330 收藏
-
479 收藏
-
348 收藏
-
275 收藏
-
文章 · python教程 | 1小时前 | 日志 · 标准库 · HTTP · python · Python HTTPS post logging.handlers.HTTPHandler HTTPHandler 远程日志262 收藏
-
205 收藏
-
401 收藏
-
192 收藏
-
413 收藏
-
474 收藏
-
331 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习