
Redis Cluster 的节点之间不只存在客户端访问连接,还会为集群内部通信维护面向每个对端的长期 TCP 链路。需要查看这些链路时,直接在目标节点执行 CLUSTER LINKS 即可。它返回一个列表,每一项描述一条节点间链路,适合用来回答“本节点和哪些对端建立了连接、连接方向是什么、当前注册了哪些读写事件、发送缓冲区里是否有数据”等问题。
官方地址:https://redis.io/docs/latest/commands/cluster-links/
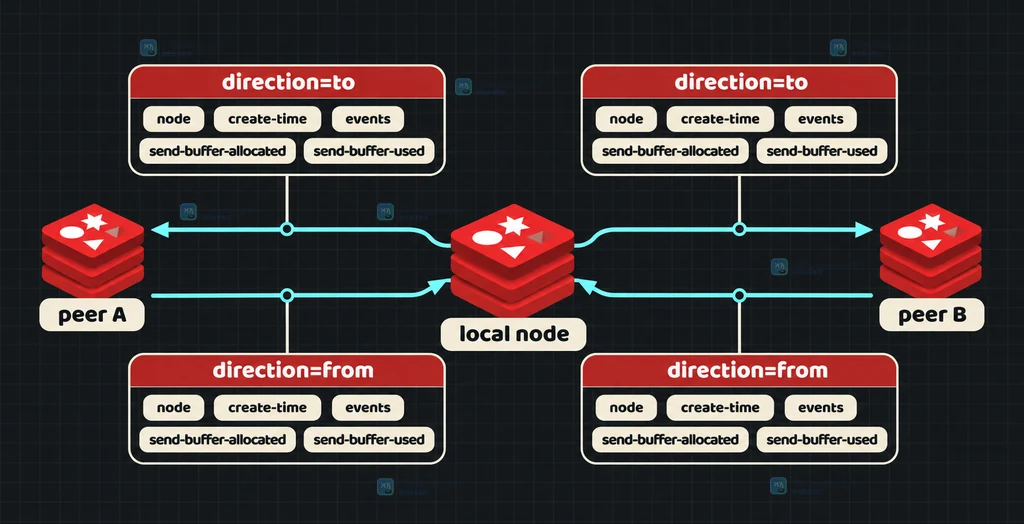
CLUSTER LINKS不需要参数。它从当前登录的 Redis 节点视角列出所有对端链路;同一个对端通常会对应to和from两个方向的记录。先按node配对,再阅读事件和缓冲区字段,才能把结果看成一组连接,而不是一串孤立键值。
先划清这个命令负责查看什么
CLUSTER LINKS 从 Redis Open Source 7.0.0 开始提供,时间复杂度为 O(N),其中 N 是集群节点数量。它查看的是当前节点与对端节点之间的集群链路,不是客户端连接列表,也不是槽位分配表。
Redis Cluster 中,每个节点会为每个对端维护一对长期 TCP link:一条用于本地节点向对端发送消息,另一条用于本地节点接收对端发来的消息。命令返回数组;在 RESP2 下可以理解为数组中的多组 map,在 RESP3 下则是数组中的 map reply。每组 map 对应一条链路。
从目标节点执行 CLUSTER LINKS
命令本身没有参数,关键在于“从哪一个节点执行”。如果你通过 redis-cli 连接的是节点 A,返回内容就是节点 A 看到的所有对端链路。为了让后续记录有上下文,建议同时保存执行节点的标识和命令原始输出。
# 连接到要观察的 Redis Cluster 节点;--raw 让多行返回更容易保存和阅读
redis-cli -h 127.0.0.1 -p 7000 --raw CLUSTER LINKS

# 需要认证时,把认证信息放在客户端连接参数中;不要把密码写进脚本或文章日志
redis-cli -h 127.0.0.1 -p 7000 --user monitor --pass '替换为受控凭据' --raw CLUSTER LINKS
正式环境不要把密码直接写在 shell 历史或共享脚本里。上面第二条命令只用于说明连接方式,实际使用时应改为受控凭据注入方式。命令没有额外参数,因此如果你想观察另一台节点,需要重新连接到另一台节点执行。
文档示例中的返回大致是下面这种“字段名、字段值交替出现”的结构:
# 下面是官方文档风格的字段结构示意,不代表当前环境的实时输出
direction to
node 8149d745fa551e40764fecaf7cab9dbdf6b659ae
create-time 1639442739375
events rw
send-buffer-allocated 4512
send-buffer-used 0
不要把示意里的节点 ID、时间戳或缓冲区数值当成自己的运行结果。真正需要分析的是字段含义以及同一对端的两条方向记录。
按 node 和 direction 配对阅读
每条记录最先看两个字段:node 指向对端节点 ID,direction 表示链路方向。to 是本地节点向对端建立的链路;from 是本地节点接受对端连接的链路。它们共同描述本地节点与同一个对端之间的双向通信关系。
例如,同一个 node 出现两次,一条为 to,另一条为 from,这通常正是文档所说的一对链路。不要简单按返回数组下标判断“第 1 项是节点 1”,而应按 node 分组、再按 direction 区分方向。
# 把扁平的键值列表整理成按对端节点分组的阅读结构
def group_cluster_links(records: list[dict]) -> dict[str, dict[str, dict]]:
    grouped: dict[str, dict[str, dict]] = {}
    for record in records:
        # 每条记录都必须有 node 和 direction,缺字段时保留原记录供人工处理
        node_id = record.get("node")
        direction = record.get("direction")
        if not node_id or direction not in {"to", "from"}:
            continue
        # 一个对端节点下分别保存 to/from,方便检查双向记录是否成对
        grouped.setdefault(node_id, {})[direction] = record
    return grouped
这个函数只是阅读层的整理逻辑,不会改变 Redis 集群状态。实际采集器还需要根据客户端返回格式,把数组中的键值对转换成字典;当返回字段不完整时,应保留原始响应,而不是悄悄补造字段。
读懂 create-time、events 和两个 buffer 字段
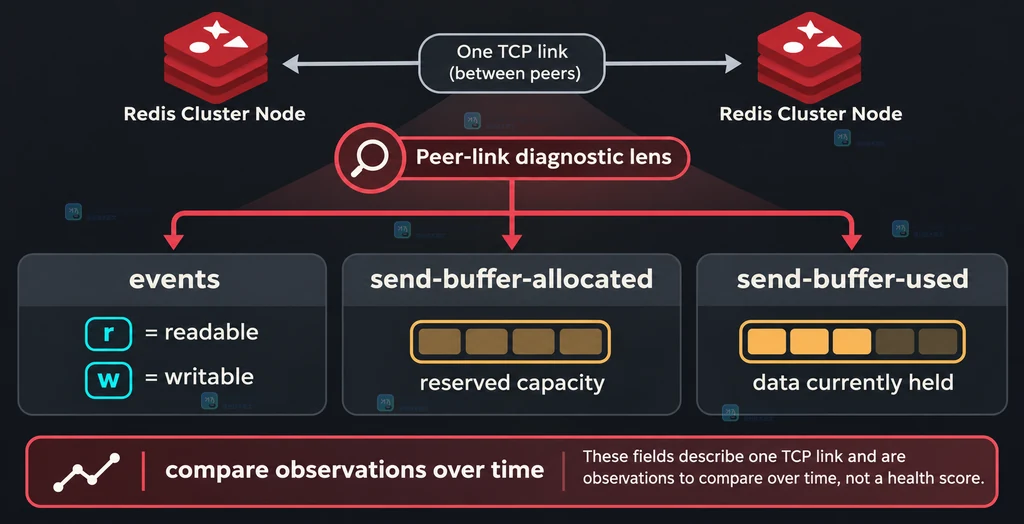
create-time 是链路创建时间的毫秒时间戳。对于 to 链路,它表示本地节点创建 TCP link 的时间,并不等同于 TCP 连接已经完成建立的时间。因此它适合做生命周期记录,不应单独当成握手成功证明。
events 表示当前为该链路注册的事件:r 表示可读事件,w 表示可写事件。它是一个事件状态字符串,不能直接翻译成“正常”或“异常”;是否需要关注,要结合节点角色、采样时刻和其他运维信息判断。
send-buffer-allocated 是该链路为发送数据分配的缓冲区大小,send-buffer-used 是当前缓冲区中正在存放数据的部分大小。一次输出只是快照,更有价值的做法是按固定时间间隔记录同一 node + direction 的变化趋势。
| 字段 | 怎么读 | 不应直接推出什么 |
|---|---|---|
| direction | to 或 from,表示本地视角的链路方向 | 不能单独代表节点健康状态 |
| node | 对端节点 ID,用于分组配对 | 不是客户端连接名,也不是槽位编号 |
| create-time | 链路创建时间的毫秒时间戳 | 不等于 TCP 已完成建立的时间 |
| events | r 可读,w 可写 | 不能把字符组合直接当告警等级 |
| send-buffer-allocated | 发送缓冲区已分配容量 | 不等于当前积压数据量 |
| send-buffer-used | 发送缓冲区当前存放数据量 | 单次大值不能替代时间序列判断 |
把一次查看变成可复用的巡检流程
如果只是临时定位,执行一次命令即可。如果要用于值班或集群巡检,可以按下面顺序保存信息:
- 记录连接的本地节点 ID、地址和采样时间。
- 执行
CLUSTER LINKS,保存未改写的原始返回。 - 按
node分组,并检查to/from方向是否都出现。 - 对每条链路记录
events、send-buffer-allocated和send-buffer-used。 - 跨多个采样点比较同一对端的变化,再决定是否需要结合日志、客户端超时或节点状态继续排查。
这里的重点是“记录并比较”,而不是给命令输出附加一个未经定义的健康分数。CLUSTER LINKS 负责提供链路对象的当前属性;至于业务消息是否延迟、节点是否被标记为失败,还需要其他命令和监控证据共同说明。
它和 CLUSTER NODES 怎么分工
CLUSTER NODES 更适合查看节点拓扑、角色、槽位以及故障标志;CLUSTER LINKS 更聚焦当前节点与对端之间的内部 TCP link 属性。两者可以配合,但不能互相替代。
| 问题 | 优先查看 | 原因 |
|---|---|---|
| 某个节点负责哪些槽位 | CLUSTER NODES | 这是拓扑和槽位视图 |
| 当前节点和某对端是否有方向记录 | CLUSTER LINKS | 这是本地链路视图 |
| 某条链路缓冲区当前占用多少 | CLUSTER LINKS | 字段直接描述发送缓冲区 |
| 节点是否被标为失败 | CLUSTER NODES 及其他运行信息 | 链路字段本身不是故障标志 |
常见误区
为什么只看到一个方向?
先确认你是在正确节点上执行,并按同一个 node 分组查看。不要因为输出顺序或客户端格式化方式,就把一条记录误认为完整的节点连接状态。
send-buffer-used 为 0 是否代表链路断开?
不能这样推断。它表示当前观察时刻发送缓冲区没有正在存放的数据;链路是否建立、节点是否可达,需要结合方向记录、事件状态与其他节点信息判断。
CLUSTER LINKS 能查看客户端连接数吗?
不能。它面向 Redis Cluster 节点之间的内部链路。客户端连接数应使用面向客户端连接的观测方式,不要把这份返回当作连接池统计。
Redis Cluster 旧版本能直接使用吗?
官方命令文档标注该命令自 Redis Open Source 7.0.0 起提供。遇到更早版本时,应先以目标环境的命令能力为准,不能只复制新版本文档中的排查步骤。
小结
查看 Redis Cluster 节点间总线连接,可以从目标节点直接执行无参数的 CLUSTER LINKS。阅读时抓住四件事:按 node 找到对端,按 direction 区分 to/from,用 events 了解当前读写事件,再用两个 send-buffer 字段观察发送缓冲区。把这些字段按采样时间保存下来,才能让一次命令输出真正服务于集群巡检。




