
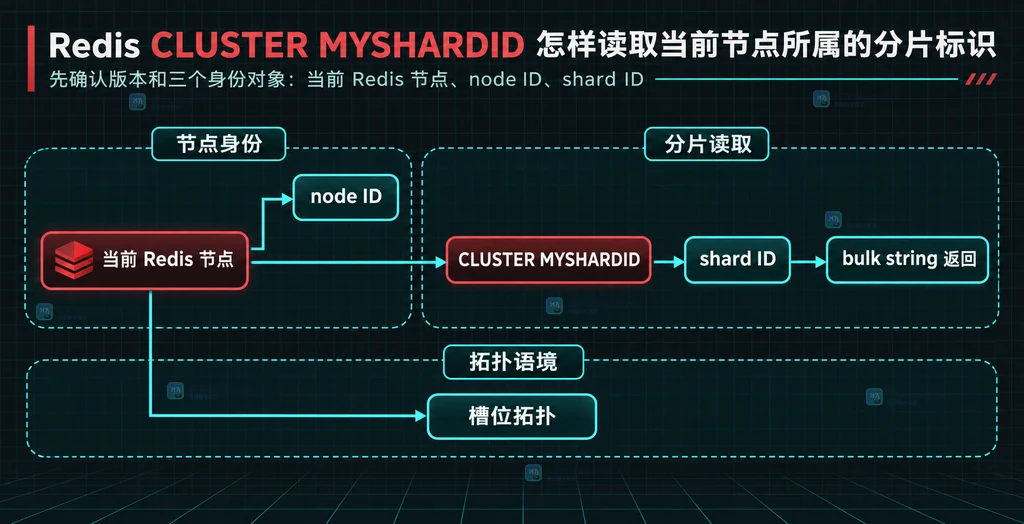
在 Redis Cluster 中,节点身份并不只有一种:节点有自己的 node ID,分片(shard)也有独立的 shard ID,槽位范围则属于拓扑信息。想知道“当前连接的这个节点属于哪个分片”,可以直接执行 CLUSTER MYSHARDID。它不需要参数,返回当前节点所属 shard 的唯一标识,返回类型是 bulk string。
官方地址:https://redis.io/docs/latest/commands/cluster-myshardid/
CLUSTER MYSHARDID读取的是当前节点的分片归属,不是节点 ID,也不是槽位编号。排查时先确认连接落在哪个节点,再把这个返回值与CLUSTER MYID、CLUSTER NODES分开记录。
先确认版本和三个身份对象
Redis 官方命令文档标注 CLUSTER MYSHARDID 自 Redis Open Source 7.2.0 起提供,时间复杂度为 O(1)。因此升级到包含该命令的版本后,它适合做一次轻量的分片身份读取;在更早版本上直接照搬调用,会得到命令不存在或不兼容的结果。
写排查脚本前,先把三个概念分开:
| 对象 | 负责回答什么 | 不要混淆成什么 |
|---|---|---|
shard ID | 当前节点所属分片的唯一标识 | 不是单个节点的 node ID |
node ID | 当前 Redis 节点自身的身份标识 | 不是槽位范围 |
| 槽位范围 | 拓扑中某个节点或主节点负责的数据区间 | 不是一个分片标识字符串 |
从目标节点执行 CLUSTER MYSHARDID
这条命令没有参数,关键是连接对象。你在哪个 Redis 节点上执行,返回值就代表哪个节点所属的分片。建议在同一条连接中顺手读取 CLUSTER MYID,把“当前节点是谁”和“当前节点属于哪个 shard”放进同一条记录。
# 连接到要观察的 Redis Cluster 节点,并读取它所属的分片标识
redis-cli -h 127.0.0.1 -p 7000 CLUSTER MYSHARDID

# 同一连接读取节点自身的 node ID,便于把两种身份分开记录
redis-cli -h 127.0.0.1 -p 7000 CLUSTER MYID
官方命令页面给出的返回类型是 bulk string。实际输出会是一段标识文本,而不是一个可以直接参与槽位计算的整数。下面的形式只用于说明返回形状,不代表某个真实环境的结果:
# 这是返回形状示意,不是当前环境的运行结果
"shard-id-from-redis"
如果使用连接池,不能拿一条物理连接上的结果代表整个连接池。应该让采集记录同时保留连接地址、node ID、shard ID 和采样时间;这样切换节点后仍能看出每条记录属于谁。
把 shard ID 放回集群拓扑
CLUSTER MYSHARDID 的结果适合做“分片归属”这一层的标识。想看节点是否负责某些槽位、节点角色和故障标志,仍然要读取 CLUSTER NODES;想确认当前节点自身身份,则使用 CLUSTER MYID。三个命令的输出不能互相替代。
# 把一次采集结果保存为分层记录,避免把三种身份放进同一个字段
def build_identity_record(address: str, node_id: str, shard_id: str) -> dict[str, str]:
    # 采集器应保留原始字符串,不能把 shard ID 强行转成整数
    return {
        "address": address,
        "node_id": node_id,
        "shard_id": shard_id,
    }

# 这里的字段名分别对应连接位置、节点身份和分片身份
record = build_identity_record("127.0.0.1:7000", "node-id-example", "shard-id-example")
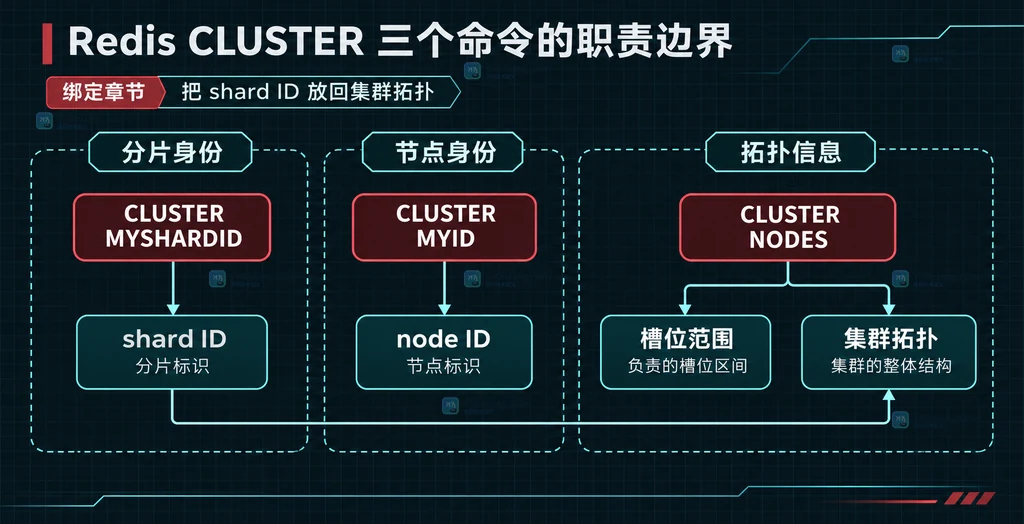
这一步的判断重点不是把 shard ID 解码成槽位,而是确认记录中的身份层级没有错位:shard ID 用来标识所属分片,node ID 用来标识单个节点,槽位和角色则回到拓扑命令查询。
安排升级后的回归检查
如果这是从旧版 Redis 升级后的排查项,可以把下面几件事列进迁移清单:
- 确认目标节点版本满足命令的版本要求;旧节点不能假设拥有该命令。
- 确认客户端把 bulk string 按字符串读取,不要根据字段名称把它转换成槽位数字。
- 确认采集器同时保存连接地址、node ID、shard ID 和采样时间。
- 需要拓扑、角色或槽位时,继续调用
CLUSTER NODES,不要用 shard ID 代替拓扑数据。 - 在混合版本集群中分别检查每个目标节点的命令能力,再决定是否启用统一采集逻辑。
命令复杂度是 O(1),适合低成本读取身份,但它只回答“当前节点属于哪个分片”。它不直接返回节点健康状态、槽位迁移进度或客户端连接数量。
常见问题
返回的 shard ID 是不是当前节点的 node ID?
不是。CLUSTER MYSHARDID 返回分片标识;当前节点自己的 node ID 应使用 CLUSTER MYID 读取。
能用 shard ID 直接判断槽位范围吗?
不能。shard ID 只是分片身份,槽位范围和节点角色属于集群拓扑信息,应从 CLUSTER NODES 等拓扑命令获取。
为什么在不同节点执行得到的值可能不同?
因为命令按当前连接的节点视角返回所属分片。切换连接节点后,查询对象也随之改变;巡检记录必须带上地址和 node ID。
Redis 7.2 之前能直接使用吗?
官方文档把该命令标为 Redis Open Source 7.2.0 起提供。旧版本应先确认实际命令能力,不能把新版命令当成所有版本都存在。
小结
读取当前节点所属的分片标识,直接执行无参数的 CLUSTER MYSHARDID 即可。迁移或排查时记住三条:它返回 shard ID 而不是 node ID;它的返回是 bulk string 而不是槽位数字;它只负责分片归属,节点身份和槽位拓扑要分别交给 CLUSTER MYID 与 CLUSTER NODES。




