
Go encoding/base32.Encoding.EncodeToString 怎样直接生成 Base32 字符串
来源:17golang原创
时间:2026-11-18 15:44:28 485浏览 收藏
我第一次需要把一段二进制标识放进只允许大写字母和数字的文本字段时,最容易想到的是自己写位运算。Go 的 encoding/base32 已经把这件事封装好了:给 Encoding.EncodeToString 传入 []byte,就能直接得到 Base32 字符串。
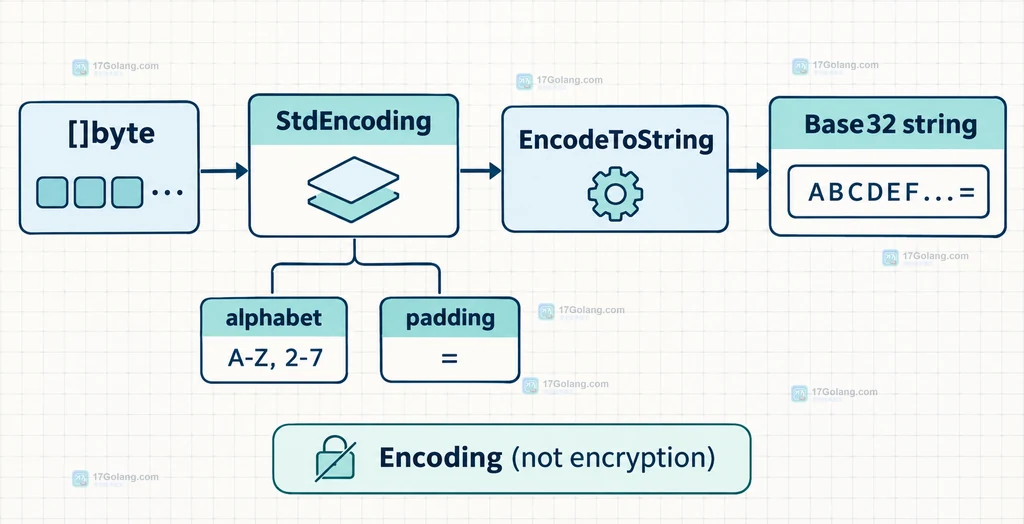
最短写法:base32.StdEncoding.EncodeToString(data)。它使用 RFC 4648 约定的标准 Base32 字符表,返回值是 string,默认保留必要的 = 填充。这里做的是可逆编码,不是加密,不能用来隐藏敏感内容。
官方文档:https://pkg.go.dev/encoding/base32#Encoding.EncodeToString
这个能力解决的是什么问题
EncodeToString 的价值是把“字节切片如何映射到 Base32 字符串”交给标准库处理。调用方只需要决定三件事:输入是哪一组字节、使用哪一个 Encoding、输出是否需要填充。它不会返回 error,因为编码过程本身没有像解码那样的非法字符输入。
我更愿意把它看成一个小的边界适配器:左侧是程序里的二进制数据,右侧是协议或配置字段里的文本。只要两端约定了同一套字符表和填充规则,后续就可以由对应的解码 API 还原。
用 StdEncoding 直接生成 Base32 字符串
标准场景优先使用 base32.StdEncoding。它代表 RFC 4648 的常见字母表,字符范围是大写 A-Z 和数字 2-7。最小示例可以这样写:
package main

import (
    "encoding/base32"
    "fmt"
)

func main() {
    // 输入是要编码的原始字节,不是已经转换好的二进制字符串。
    data := []byte("service-42")

    // StdEncoding 使用 RFC 4648 的标准 Base32 字符表。
    encoded := base32.StdEncoding.EncodeToString(data)

    // 返回值已经是 string,可以直接写入文本字段或日志。
    fmt.Println(encoded)
}
方法签名可以记成 EncodeToString(src []byte) string:参数是字节切片,结果是一个新的字符串。输入是空切片时,结果也是空字符串;输入中的每一个字节都会参与编码,不能把中文、UUID 或数字直接当成“特殊类型”传入,应该先明确它们要按什么字节表示。
标准 Base32 会把输出补齐到 8 个字符一组,所以短输入的结果末尾可能出现一个或多个 =。这些字符属于编码格式的填充,不是原始数据的一部分;如果协议要求保留补齐信息,就不要在业务层随意裁掉。
StdEncoding、HexEncoding 和自定义字符表有什么区别
Encoding 决定了 32 个字符如何表示编码结果。常见选择可以先按下面这张表判断:
| 选择 | 字符表 | 适用判断 |
|---|---|---|
StdEncoding | A-Z、2-7 | 对接常见 RFC 4648 Base32 文本格式 |
HexEncoding | 0-9、A-V | 协议已经约定使用 Base32 Hex 字母表 |
NewEncoding | 调用方提供 32 个互不重复的字节 | 自有协议明确规定了另一套字母表 |
不要因为输出看起来都是大写字母,就在编码端和解码端随意切换这几个对象。字符表不同,即使输入字节相同,结果也会不同。自定义字符表还必须满足长度为 32、字符互不重复,并且不能包含换行或默认填充字符等约束:
package main

import (
    "encoding/base32"
    "fmt"
)

func main() {
    // HexEncoding 是标准库提供的 Base32 Hex 变体。
    hexText := base32.HexEncoding.EncodeToString([]byte("service-42"))

    // 自定义字符表必须正好有 32 个互不重复的字节。
    custom := base32.NewEncoding("0123456789ABCDEFGHIJKLMNOPQRSTUV")
    customText := custom.EncodeToString([]byte("service-42"))

    // 两种结果的字符表不同,不能混用对应的解码器。
    fmt.Println(hexText)
    fmt.Println(customText)
}
上面的自定义字符表恰好与 Base32 Hex 字母表一致,实际项目通常直接复用 HexEncoding。只有在外部协议真的规定了另一组 32 字符时,才值得创建自己的 Encoding。
需要不要保留末尾的等号填充
默认的 StdEncoding 使用 = 填充。如果目标字段或协议明确要求无填充,可以从现有编码对象创建一个新对象,而不是修改全局变量:
package main

import (
    "encoding/base32"
    "fmt"
)

func main() {
    data := []byte("service-42")

    // WithPadding 返回配置不同的新 Encoding,不会改变 StdEncoding。
    noPadding := base32.StdEncoding.WithPadding(base32.NoPadding)
    encoded := noPadding.EncodeToString(data)

    // 无填充结果更适合受限字段,但解码端也要使用相同约定。
    fmt.Println(encoded)
}
这里的关键不是“有没有等号更好”,而是两端是否一致。数据库键、URL 片段或人工输入字段可能不喜欢 =,但删除填充后,接收方必须知道采用的是 NoPadding。如果协议没有明确要求,优先保留默认填充,减少跨语言实现的歧义。
一次性字符串和流式写出怎么选
EncodeToString 返回完整字符串,适合短标识、配置值、消息字段或已经在内存中的小块数据。它的调用体验很好,但并不意味着所有大数据都应该先聚合成一个字符串。
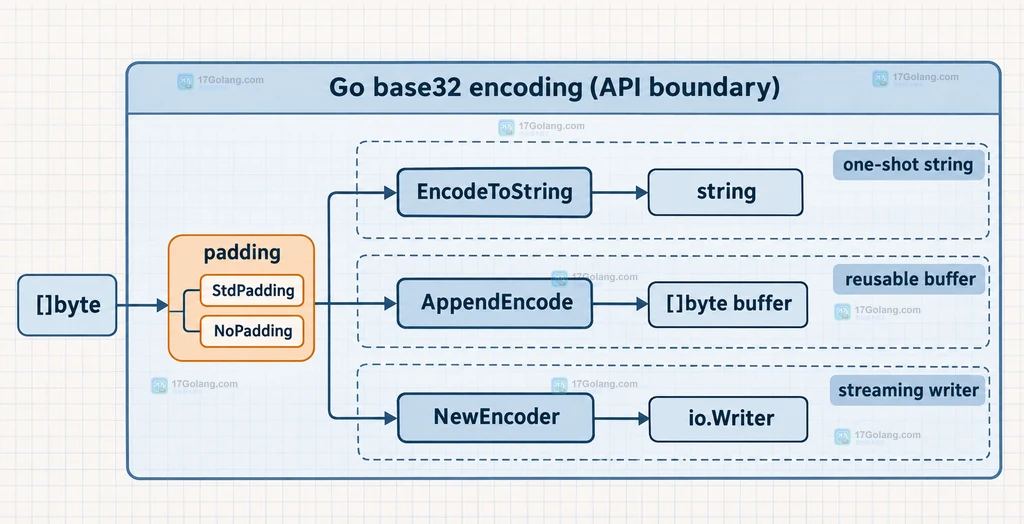
当输出要追加到已有缓冲区,可以看 AppendEncode;当数据来自较大的连续输入并且目标是一个写出端,可以考虑 NewEncoder。三者的边界可以这样记:
| API | 结果形态 | 更适合 |
|---|---|---|
EncodeToString | string | 一次性得到完整文本 |
AppendEncode | 追加到 []byte | 复用或拼接已有缓冲区 |
NewEncoder | 写入 io.Writer | 边读取边写出,避免一次聚合全部结果 |
尤其要注意 NewEncoder 的生命周期:写入结束后需要调用 Close,让最后一个未满分组的数据完成编码。这个边界属于流式写出,不应为了替换一个简单的 EncodeToString 调用而增加复杂度。
接入前的几个核对点
- 输入是否已经明确为要编码的
[]byte,字符编码转换是否由业务层负责? - 发送端和接收端是否约定了同一个
Encoding,没有把StdEncoding和HexEncoding混用? - 协议是否要求填充?若使用
NoPadding,解码端是否同步配置? - 数据是否足够大,以至于一次性构造完整字符串会增加不必要的内存压力?
- 是否把 Base32 当成编码而不是加密,避免用它存放需要保密的原文?
EncodeToString 会返回 error 吗?不会。它只接收字节并生成文本;需要重点处理错误的是解码方向,或者底层流式写出过程。
为什么结果末尾有 =?这是默认填充,用来让 Base32 输出按 8 个字符对齐。只有协议明确要求无填充时,才使用 WithPadding(base32.NoPadding)。
能不能把 Base32 当作密码保存?不能。Base32 是可逆的文本编码,任何拿到字符串的人都可以按同一字符表解码。需要保密时,应使用经过审慎设计的加密方案。
这次如果只是要把一小段字节变成可传输文本,我会优先写 base32.StdEncoding.EncodeToString(data),把字符表和填充决定留在协议层;等数据规模或输出方式真的变化,再切换到缓冲或流式 API。这样既能保持代码短,也不会把一次性编码和大数据处理混成同一个问题。
-
394 收藏
-
376 收藏
-
463 收藏
-
260 收藏
-
360 收藏
-
238 收藏
-
501 收藏
-
377 收藏
-
122 收藏
-
424 收藏
-
343 收藏
-
344 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习