-
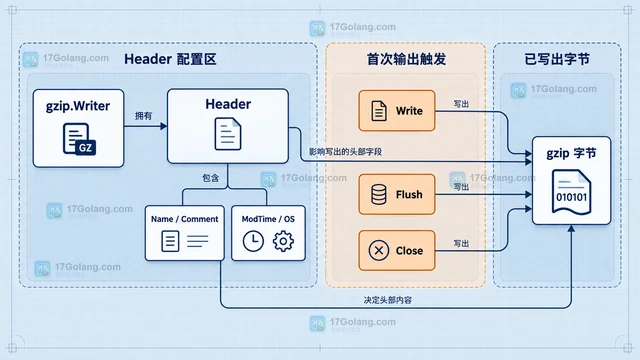
gzip.Writer 会在首次 Write、Flush 或 Close 时把 Header 编码到底层输出;之后修改结构体只改变内存字段,无法回写已发出的字节。本文给出正确初始化、Reset 复用和防回归写法。
-
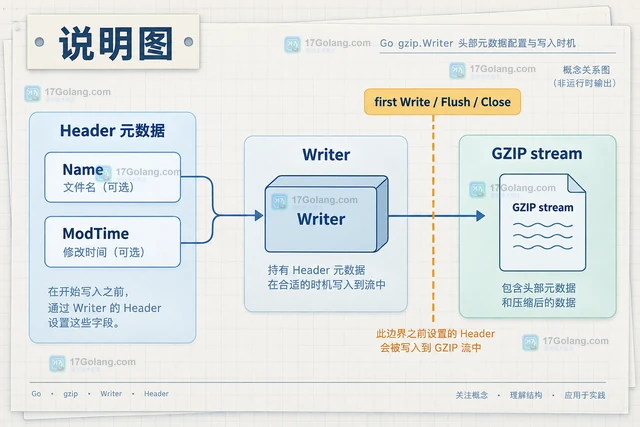
Go 的 gzip.Writer 可以在首次写入前通过 Name 和 ModTime 设置 GZIP 头元数据;本文给出可读回核对的完整示例,并说明 Close、Reset、零值时间和编码边界。
-
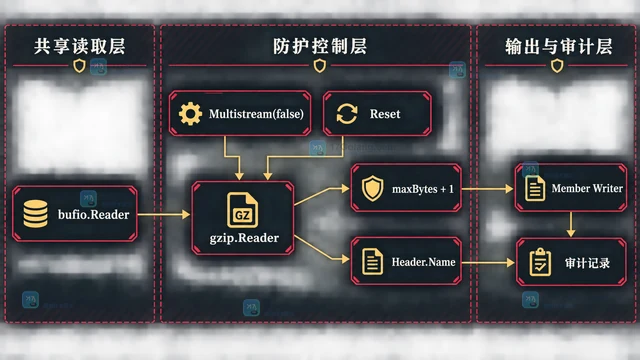
Go gzip.Reader 默认会连续解压拼接成员。本文用 Multistream(false)、bufio.Reader 和 Reset 逐段取得每个成员的 Header 与正文,并加入单成员大小限制、错误处理和安全落盘边界。
-
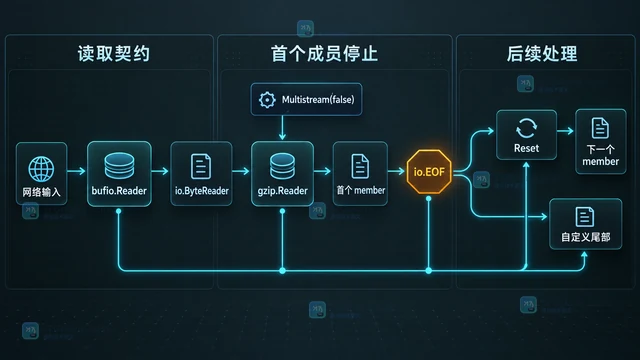
Multistream(false) 只让 gzip.Reader 在首个成员后返回 EOF,并不会省略 trailer 校验。本文解释底层流越界读取的原因,并给出 bufio.Reader、io.ByteReader、Reset 与自定义尾部的可靠处理方式。
-
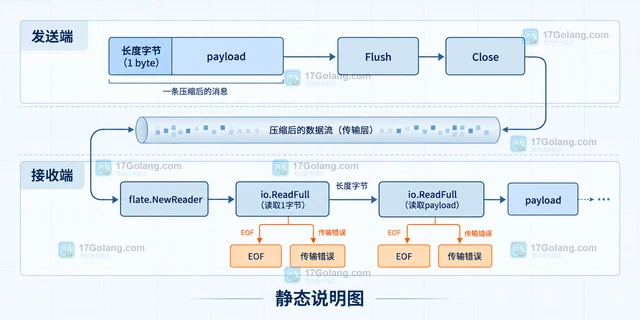
Go compress/flate 的 Write 可能暂存在压缩器内部,实时传输要在消息写入后调用 Flush,把当前数据和同步标记推到底层 writer;Close 只负责最终收尾。本文用长度帧、io.Pipe 和 io.ReadFull 说明发送、接收与刷新频率的边界。
-
Go compress/flate 的 Flush 只推出压缩器待处理数据,不提供网络消息边界。本文用长度帧、io.ReadFull、双层缓冲和 Close 说明接收端拿不全数据的排查与处理方法。
-
Go compress/flate 的 HuffmanOnly 只做 Huffman 熵编码,不再寻找 Lempel-Ziv 重复串。它更适合已经经过 Snappy、LZ4 等 LZ 类压缩、但字节频率仍明显偏斜的数据;普通文本直接使用它往往会牺牲压缩率。本文用原创示例说明选择边界、资源收尾和上线前对比方法。
-
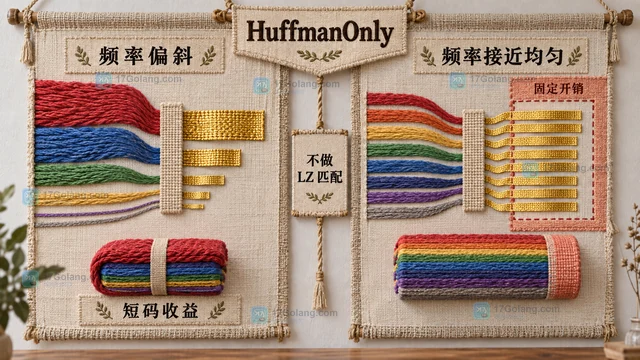
flate.HuffmanOnly 只做 Huffman 熵编码,不搜索重复字符串。输入很短、字节分布接近均匀、已经完成熵编码,或频繁 Flush 时,DEFLATE 块与同步标记开销可能超过节省的字节。本文说明如何测量并选择模式。
-
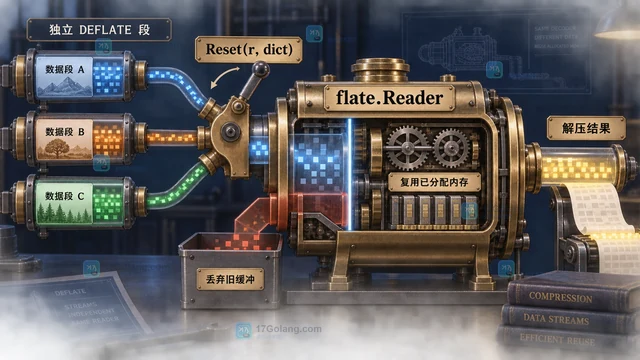
Go 的 flate.NewReader 返回值同时实现 flate.Resetter,可在每段独立 DEFLATE 数据开始前调用 Reset 切换输入,复用内部已分配内存。本文给出完整循环,并说明 Close、字典、ByteReader 过读和并发使用边界。
-
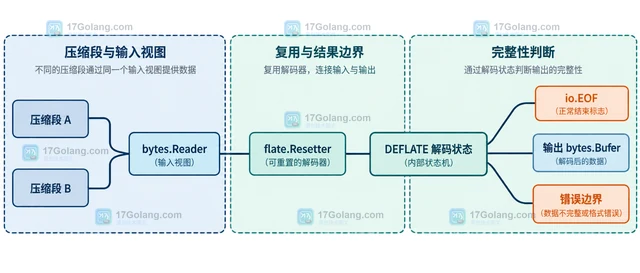
Go compress/flate 复用解压器时,Reset 会清理内部状态但不会清空调用方的输入和输出缓冲。本文用代码和边界清单定位上一段数据残留、输入游标错位、Close 缺失与字典不匹配。
-
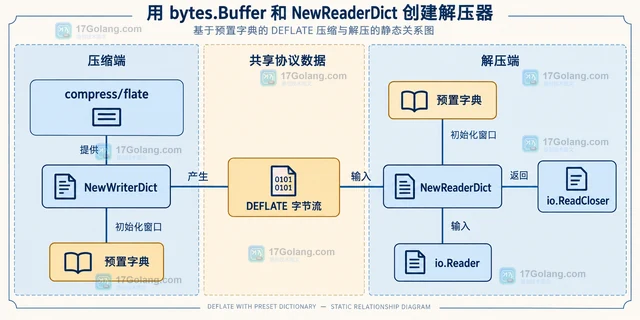
用 Go compress/flate 的 NewReaderDict 配合同一份预置字典解压 DEFLATE 数据,示范 io.Copy、Close、Reset 的写法,并按字典、输入流和读取边界排查失败原因。
-
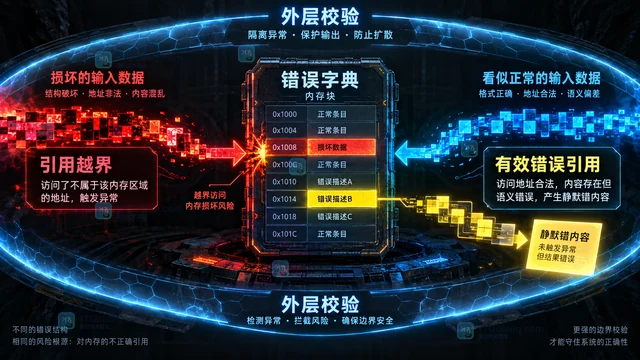
flate.NewReaderDict 只初始化解压状态,不会在构造时读取并验证完整数据;字典不一致通常到 Read 或 io.Copy 展开回溯引用时才暴露,而且可能表现为 corrupt input,也可能静默产出错误字节。本文给出诊断与协议修复方法。
-
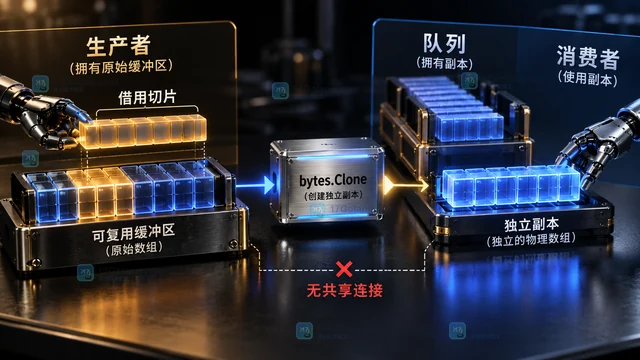
当 []byte 来自读取缓冲区、sync.Pool 或短生命周期回调时,直接保存会继续共享底层数组。本文说明如何在队列、goroutine 和缓存边界使用 bytes.Clone 获得独立副本,并处理 nil、空切片与复制成本。
-
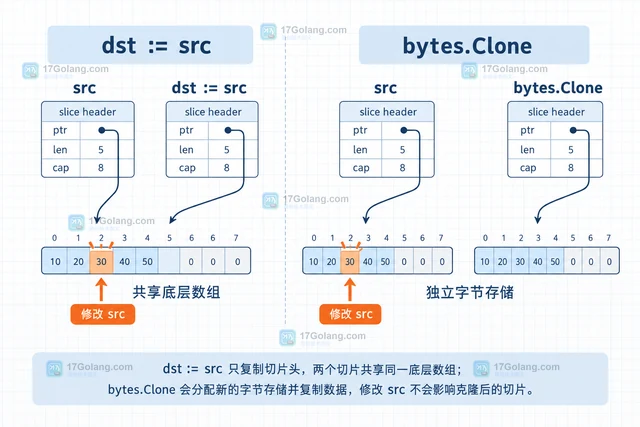
解释 Go bytes.Clone 为什么能让副本与原切片隔离,覆盖切片头、底层数组、长度容量以及 nil 与空切片的边界。
-
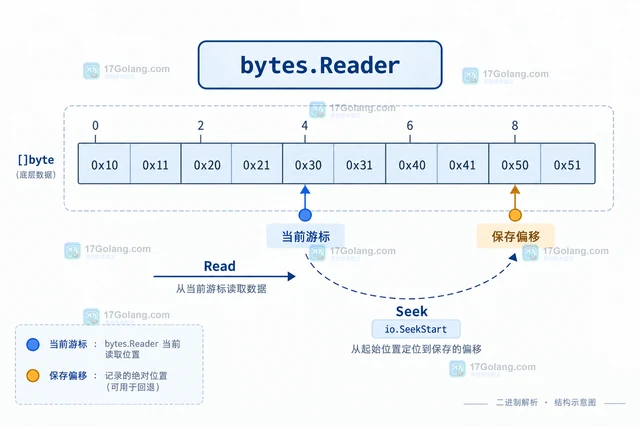
用 Go bytes.Reader 保存绝对偏移、回退试读分支,并区分 Seek 越界、负位置、EOF 与 ReadAt 独立探测。
