-
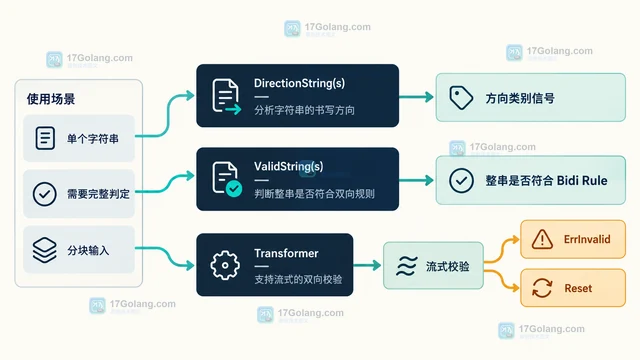
Go x/text/secure/bidirule 按 RFC 5893 实现双向文本规则。本文说明混合左右方向字符为何可能不合法,拆解 LTR/RTL 标签、EN/AN 数字冲突、末尾字符约束,并给出 ValidString 与 Transformer 的 Go 用法。
-
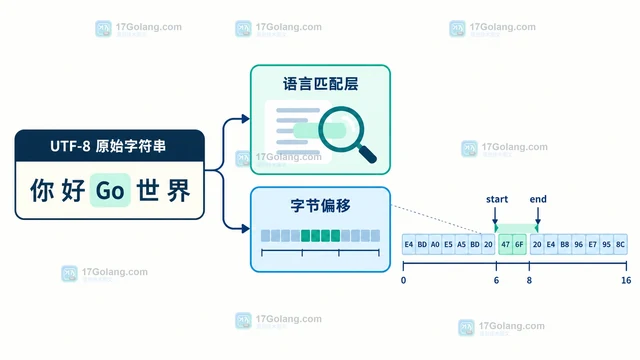
Go x/text/search 的匹配规则可以按语言处理大小写、重音和宽度,但 IndexString 返回的 start/end 仍应按原始 UTF-8 字节偏移使用。本文说明如何切取原文,并安全转换为 rune 下标。
-
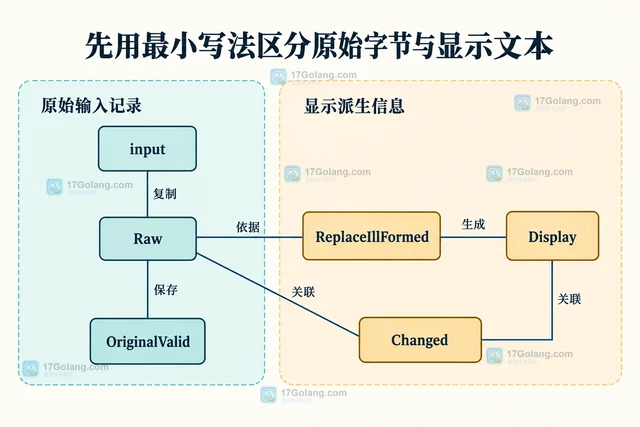
Go runes.ReplaceIllFormed 会将非法 UTF-8 字节替换为 U+FFFD。本文说明字节变化与无损解码的区别,给出原始副本和显示文本分离的示例,并解释批量与分块处理限制。
-
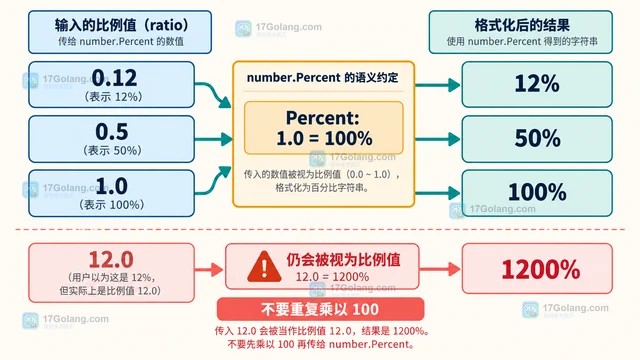
Go x/text/number 的 Percent 把 1.0 定义为 100%,所以 0.12 会显示为 12%。本文区分比例与百分数输入,说明语言环境、小数位选项和重复放大的排查边界。
-
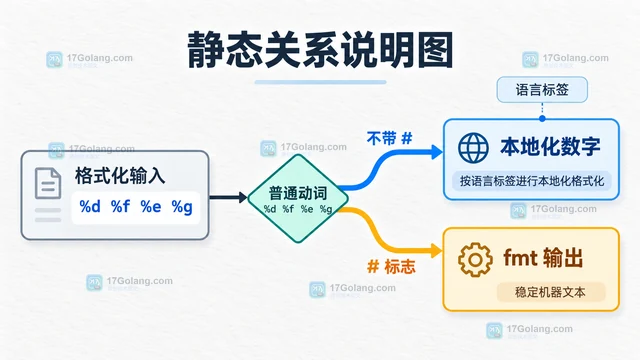
x/text/message 的 Sprintf 不是简单改名版 fmt.Sprintf:Printer 会按语言标签处理数字格式,格式串还可能作为翻译键。本文用最小 Go 示例说明差异、# 标志、Key 和回退边界。
-
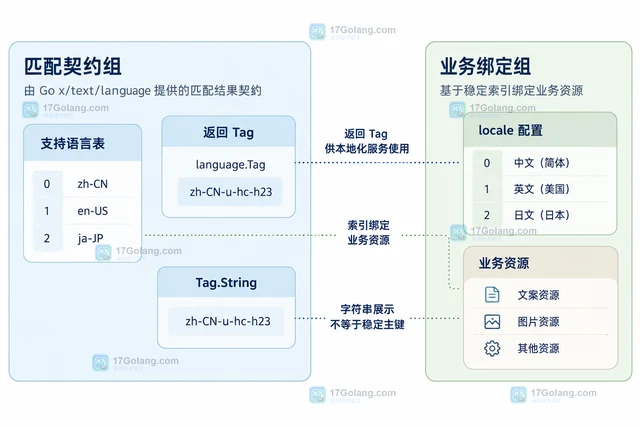
Go x/text/language 的 Matcher.Match 返回值可能带有 -u-rg- 等扩展字段,这是把用户地区设置带入匹配结果的设计。本文区分返回 Tag 与 index 的用途,并给出资源绑定示例。
-
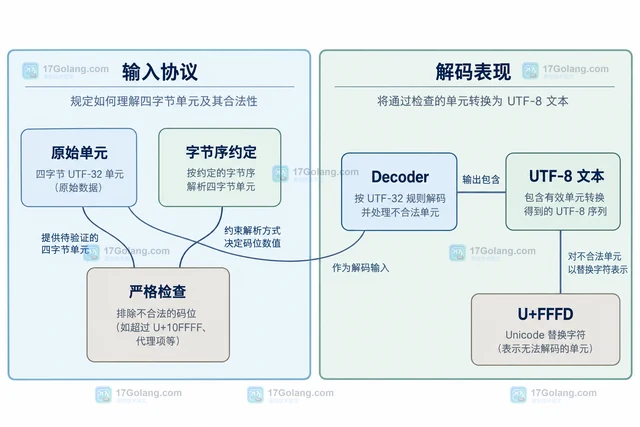
UTF-32 的四字节单元仍可能是代理项、超范围值或被错误字节序解释。本文给出固定小端的严格导入示例,说明默认解码替换行为、BOM 策略和失败偏移。
-
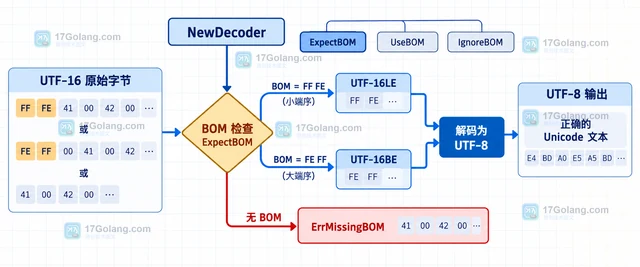
Go x/text/encoding/unicode 的 ExpectBOM 会要求 UTF-16 输入以 BOM 开始,没有签名的字节流会返回 ErrMissingBOM。本文对比三种 BOMPolicy,演示解码、编码和 transform.Reader 的正确使用边界。
-
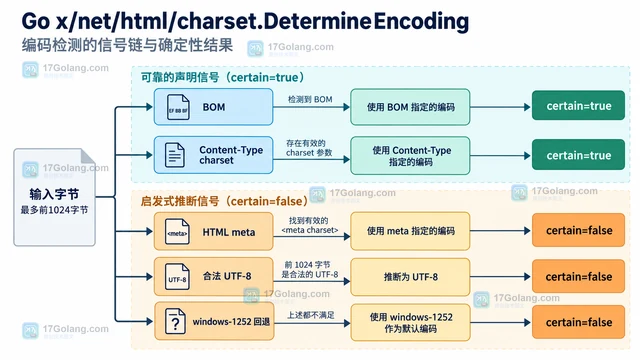
Go x/net/html/charset.DetermineEncoding 返回的 certain 不是“有没有识别出编码”,而是“结果是否来自可靠声明”。本文拆解 BOM、Content-Type、meta 扫描、UTF-8 推断与 windows-1252 回退的顺序,给出网页乱码排查时的使用方式。
-
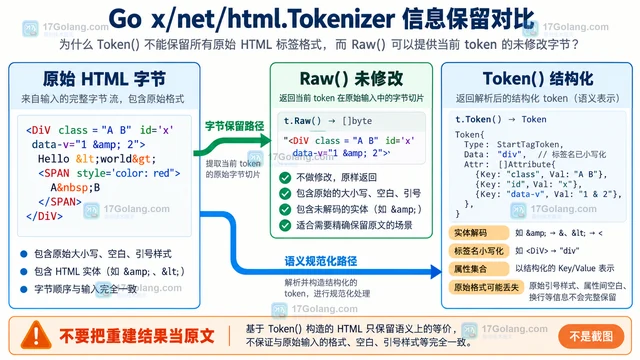
Go x/net/html.Tokenizer 的 Token 会把实体、标签名和属性转成结构化数据,因此不能当作原始 HTML 的无损副本。本文用 Raw、Token 和低级 API 对比保留边界,给出按 token 复制原始字节的写法。
-
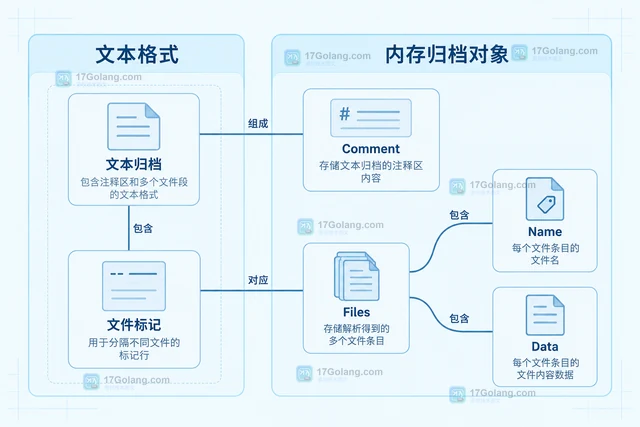
Go txtar.Parse 将注释区和文件段拆成 Archive。本文说明标记行、Files 顺序、末尾换行与输入切片引用,并给出保留独立存储的内存解析示例。
-
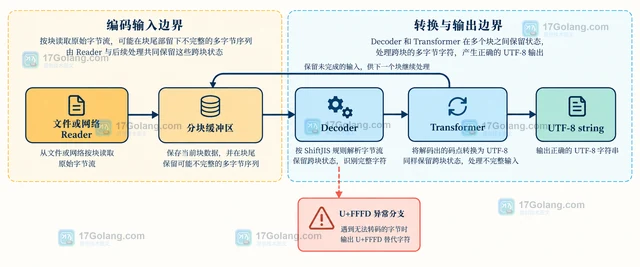
ShiftJIS 的字节边界不一定等于字符边界,逐字节调用 Go 解码器会让日文字符失去配对关系。本文说明 japanese.ShiftJIS 的 Decoder、transform.Bytes 和 Reader 应如何选择,并给出分块乱码与 U+FFFD 的排查方法。
-
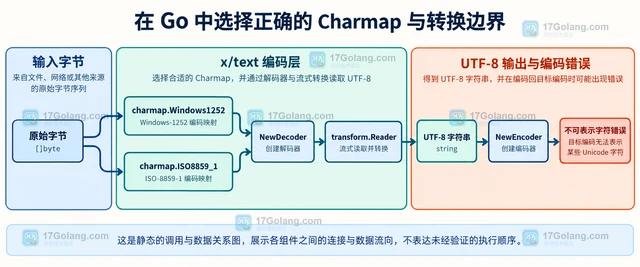
Windows1252 与 ISO8859_1 都是单字节编码,但 0x80–0x9F 区域的字符定义不同。本文用 Go x/text/encoding/charmap 对比解码、流式转换和反向编码,说明为什么不能只看字节宽度来选择编码。
-
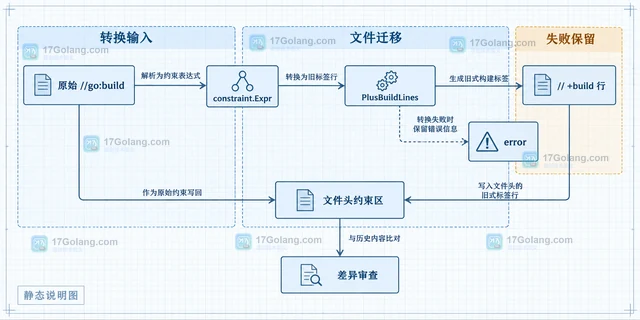
Go constraint.PlusBuildLines 可以把 constraint.Expr 转成一组等价的 // +build 旧标签行。本文说明 Parse、转换错误、复杂表达式边界以及写回源文件时的新旧约束同步方法。
-
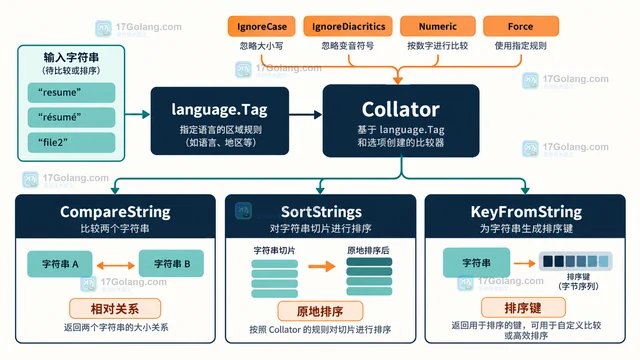
Go x/text/collate 的 CompareString 比较的是指定语言环境下的 Unicode 排序关系,不是字符串的 UTF-8 字节序。本文用最小示例说明 locale、返回值、比较选项和排序接入方式。
