-
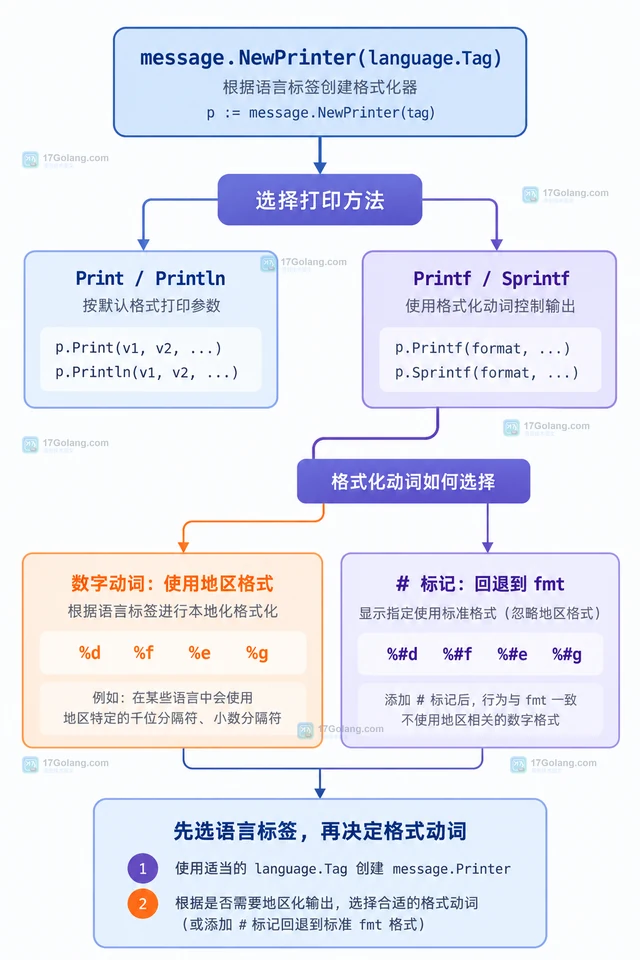
Go 使用 x/text/message Printer 配合 language.Tag 输出地区化数字。本文比较 Printer、fmt 和显式格式化的适用边界,说明 Printf、Sprintf、%d、%f、%g 以及 # 标记的选择。
-
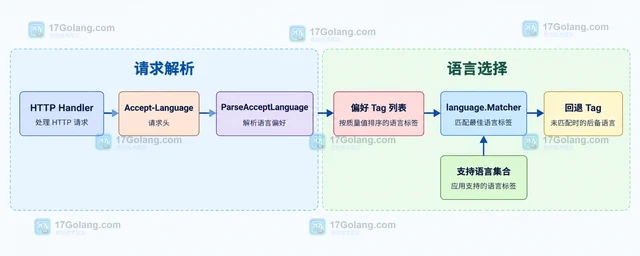
Go 服务可以用 x/text/language 的 ParseAcceptLanguage 读取 Accept-Language 头,把语言标签和 q 权重交给 Matcher 选择支持的语言。本文覆盖返回值、排序、错误和回退处理。
-
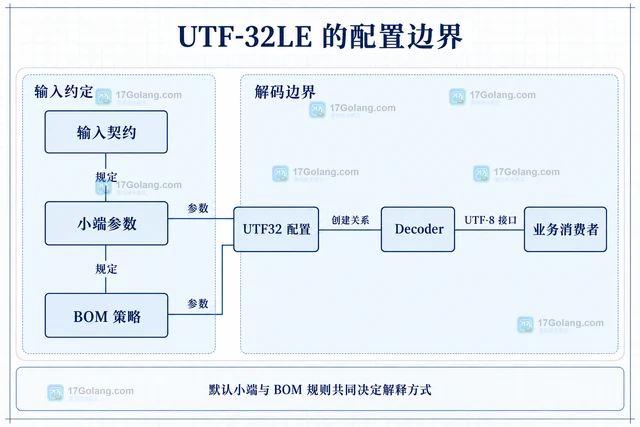
Go 用 UTF32 配置小端解码器,再通过 transform.NewReader 转成 UTF-8。本文说明 IgnoreBOM、UseBOM、ExpectBOM 的区别,以及流式处理中的资源归属和部分输出。
-
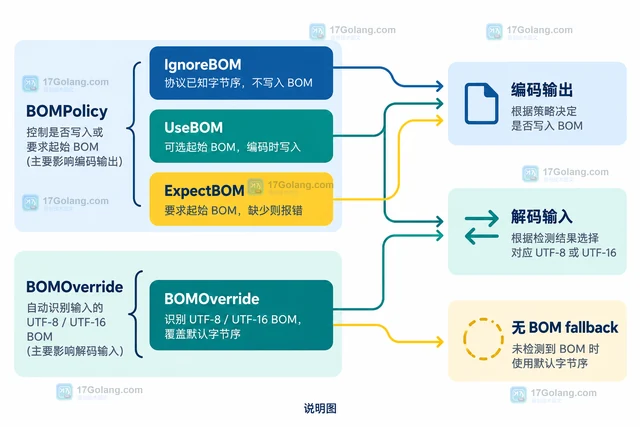
介绍 Go x/text/encoding/unicode 中 UTF16 的字节序与 BOMPolicy 配置,说明 IgnoreBOM、UseBOM、ExpectBOM 和 BOMOverride 在读写 UTF-16 时的区别与选择方法。
-
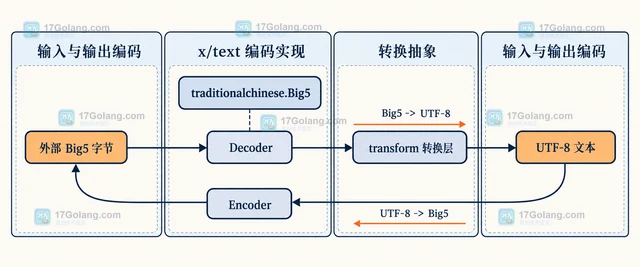
Go 使用 golang.org/x/text/encoding/simplifiedchinese 处理 GB18030 四字节字符,关键是用 GB18030 的 Decoder 与 Encoder 在 UTF-8 和旧编码字节之间转换,并区分解码替换字符与编码不可表示错误。
-
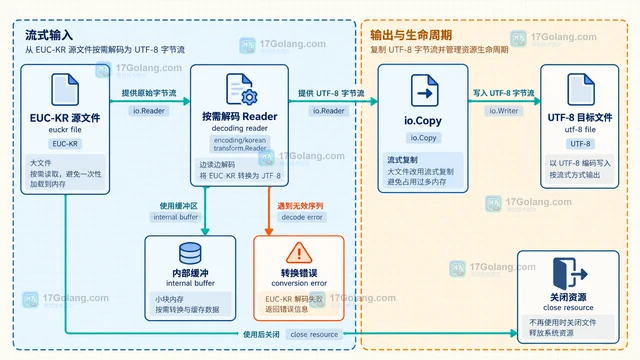
读取 EUC-KR 或 CP949 保存的旧韩文文本时,不能直接把原始字节转换成 UTF-8 字符串。本文用 golang.org/x/text/encoding/korean 的 EUCKR 解码器接入 transform.Reader,给出整文件读取、流式复制、错误处理和内存取舍。
-
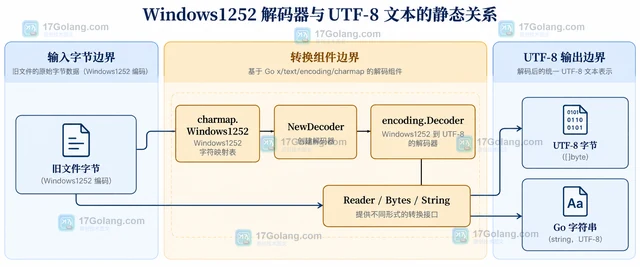
Windows-1252 旧文件不能直接当作 UTF-8 读取。本文用 golang.org/x/text/encoding/charmap 的 Decoder 说明内存转换、流式读取和写回旧编码时的字符边界。
-
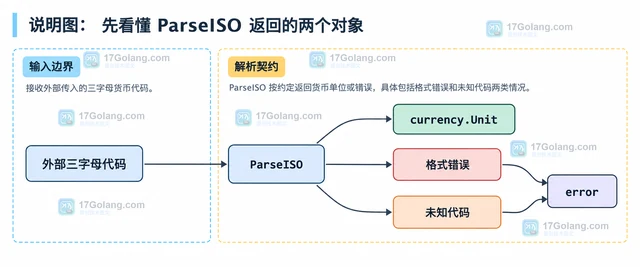
Go x/text/currency 的 ParseISO 用于解析三字母 ISO 4217 货币代码。本文说明如何处理格式或未知代码错误,并区分 Unit、Amount、Formatter 与 MustParseISO 的职责边界。
-
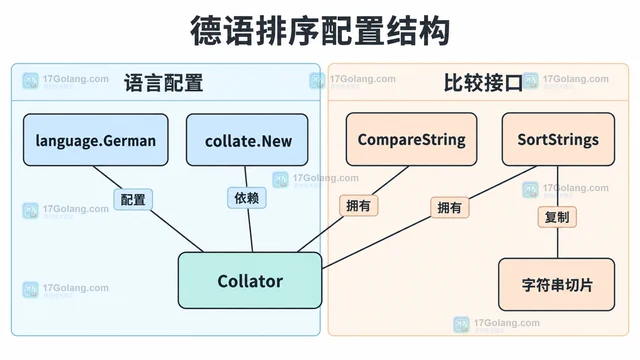
Go 用 collate.New(language.German) 创建德语文本排序器。通过完整示例说明语言标签、稳定排序与原切片保护,并解释比较等价、并发独占和配置记录的使用边界。
-
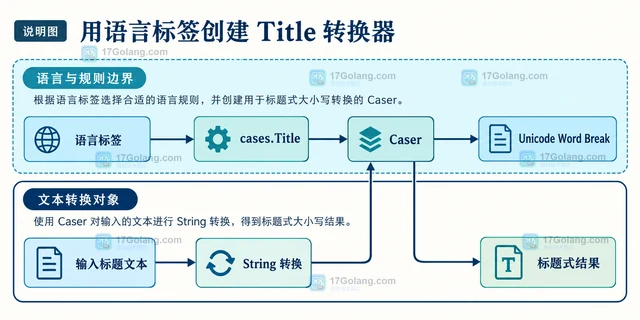
Go x/text/cases 的 Title 可以结合语言标签生成标题式大小写。本文用普通标题、NoLower、String/Bytes/Transform 和 Caser 并发边界说明怎样选参数与避免误用。
-
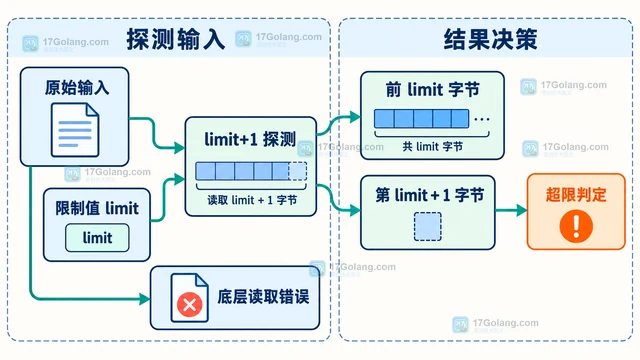
io.LimitReader 读到上限后返回 EOF 是设计出来的正常结束信号,不是超限报错。本文从 Reader 契约出发,说明如何用 limit+1 的策略识别输入是否真的超过上限,并比较 LimitReader、ReadFull 与 ReadAtLeast 的适用边界。
-
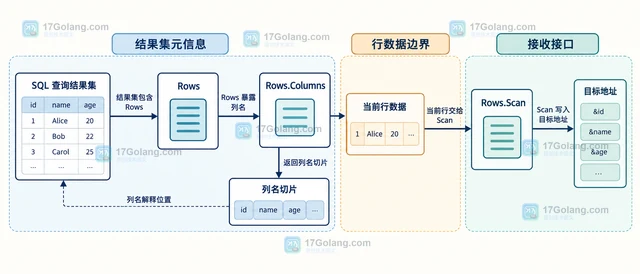
Rows.Columns 返回列名顺序,Rows.Scan 按位置写入目标地址。本文解释固定列与动态列的对应规则,并处理 NULL、Close 和 Err 的常见边界。
-
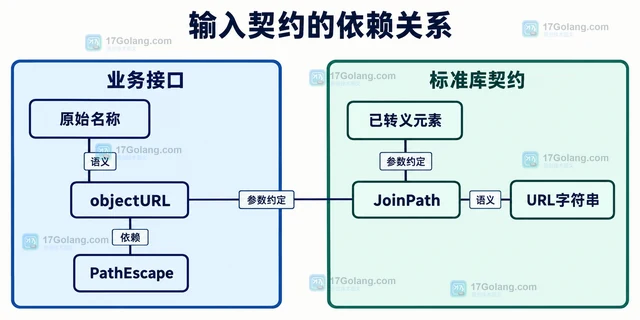
Go url.JoinPath 接收已转义路径元素,保留百分号编码并不异常。通过 Path、RawPath、EscapedPath 的区别和原始名称构造示例,说明斜杠、点段与重复转义的处理方法。
-
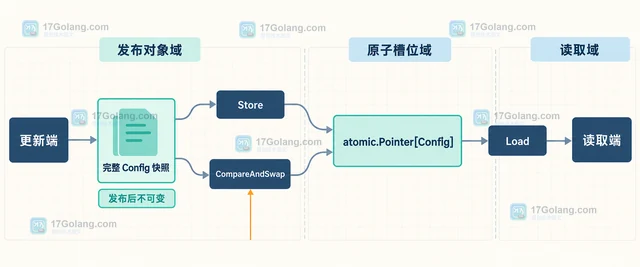
atomic.Pointer[T] 中的 T 决定了它保存的指针类型以及 Store、Load、Swap 和 CompareAndSwap 的参数与返回值。本文解释 Go 为什么要求指针类型一致,并给出共享配置对象的安全用法与复制、可变性边界。
-
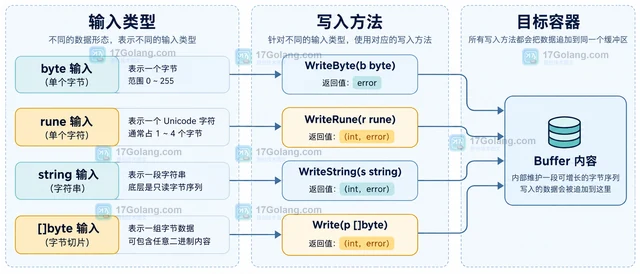
bytes.Buffer.WriteByte 的 error 固定为 nil 并不是漏掉了错误处理,而是为了匹配 bufio.Writer 的接口形状。本文说明单字节写入、字符写入与容量边界的区别。
