-
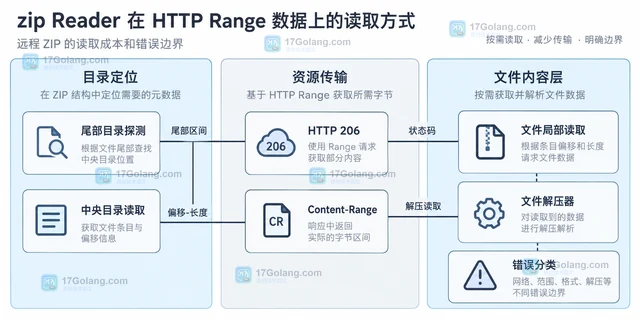
zip.NewReader 需要 io.ReaderAt 和压缩包总大小,HTTP 响应体却通常只能顺序读取。本文用 RangeReaderAt 把 HTTP Range 适配成随机读取,并说明 206、Content-Range、目录定位和错误边界。
-
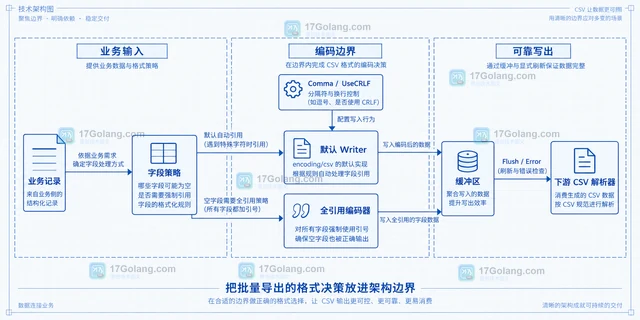
Go 的 encoding/csv Writer 会按字段内容自动决定是否加引号,但不会默认把空字符串写成双引号。本文解释 Comma、UseCRLF、Flush、Error 与全引用编码方案,解决批量导出时的格式兼容问题。
-
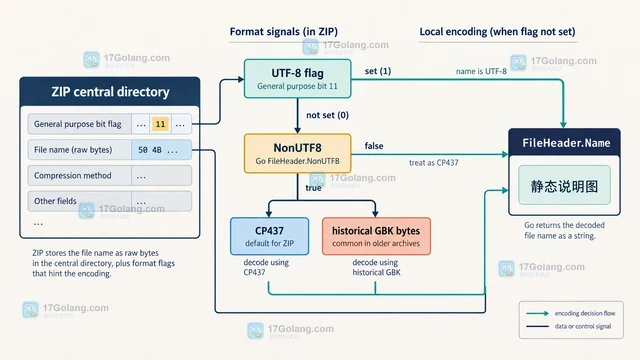
Go 使用 archive/zip 读取中文文件名异常时,先区分 UTF-8、CP437 和历史本地编码,再用显式解码与路径安全策略处理,避免把乱码或不可信路径直接落盘。
-
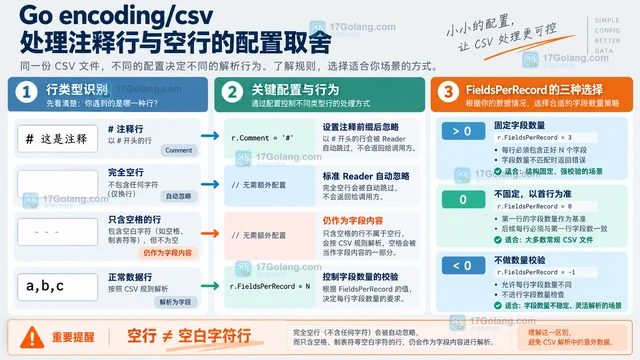
Go 的 encoding/csv 会自动忽略完全空行,但不会把只含空格的行当作空行。本文说明 Comment、TrimLeadingSpace 与 FieldsPerRecord 的取舍,并给出带错误处理的读取示例。
-
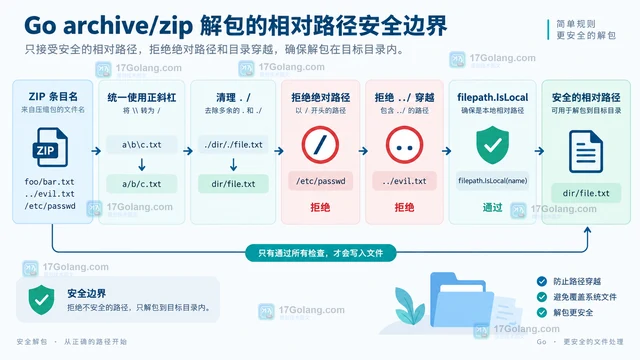
Go 使用 archive/zip 解包时,不能把 ZIP 条目名直接拼到目标目录。本文用相对路径校验、安全根目录映射和先校验后写盘的代码,处理绝对路径、../、反斜杠及 ErrInsecurePath,并说明符号链接和共享目录的额外边界。
-
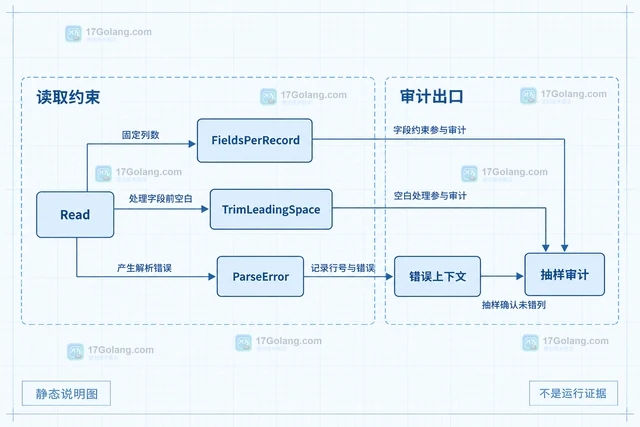
encoding/csv 遇到非标准引号时可以用 LazyQuotes 放宽读取,但应同时固定字段数、记录解析错误并保留抽样检查,避免把脏数据直接变成静默错列。
-
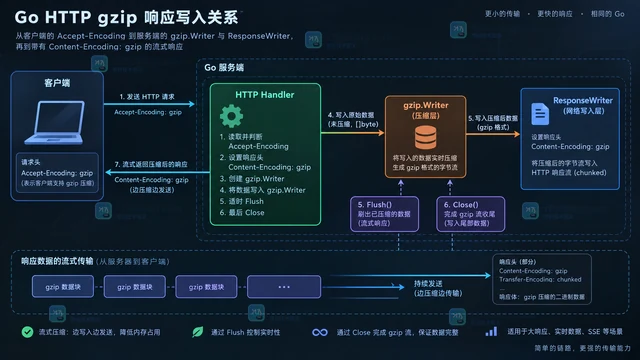
Go 的 gzip 压缩级别是在 CPU 消耗、响应体大小和端到端延迟之间做取舍。本文用 NewWriterLevel 比较级别,并给出 HTTP Handler 中的配置、Close、Flush 与 Writer 复用注意事项。
-
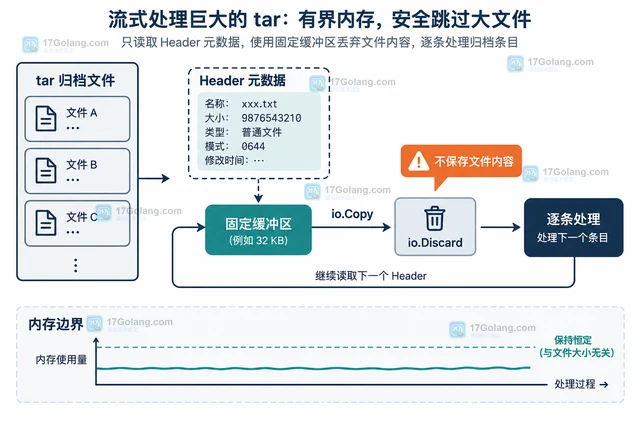
Go 的 archive/tar 适合流式读取归档。本文区分 Header 与 payload,演示只保留文件头元数据、用固定缓冲区消费内容,并说明超大条目和异常归档的内存控制边界。
-
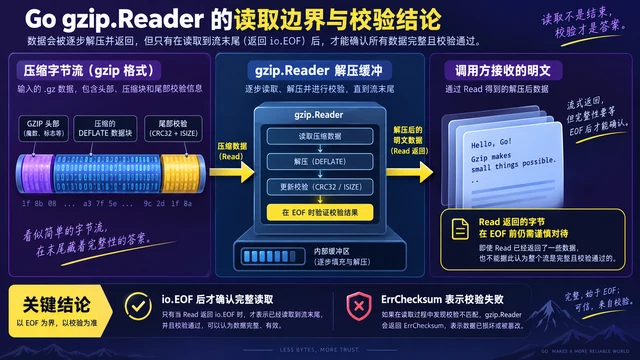
复用 gzip.Reader 时看到旧数据,通常不是 Reset 失效,而是把 Reader 内部状态、输入源位置和调用方输出缓冲混在了一起。本文用 Reset、EOF、ErrChecksum 与 Multistream 说明正确的复用边界。
-
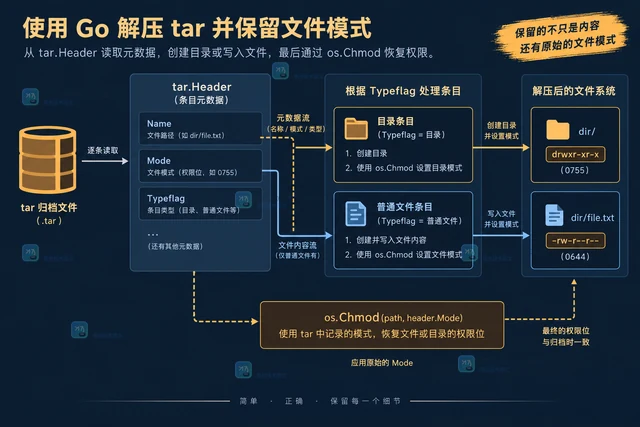
用 archive/tar 解包时,先读取 Header.Mode 和 Typeflag,再按成员类型创建目录、写入文件并恢复权限,避免脚本或只读文件的模式丢失。
-
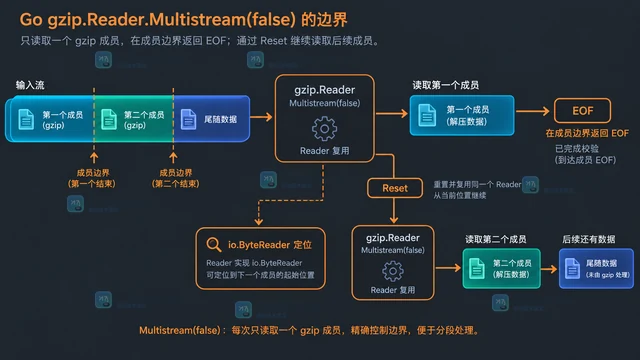
Go 的 gzip.Reader 默认会连续读取拼接的 gzip 成员。本文用原创示例拆开 Multistream、Reset、io.ByteReader、EOF 与尾随数据的边界,帮助你选择整体解压或按成员处理。
-
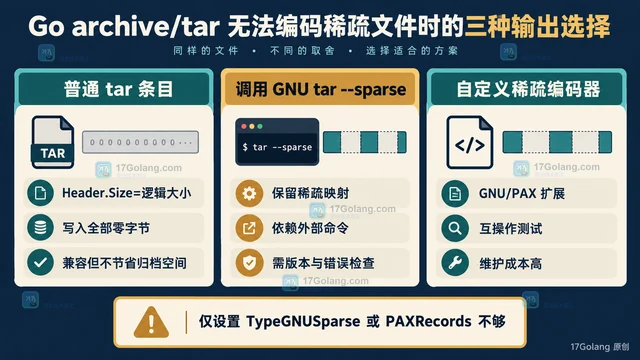
Go 标准库 archive/tar 能读取 GNU/PAX 稀疏归档,但 Writer 当前不支持编码稀疏文件,因此不存在一组 Header 字段能直接开启稀疏写入。本文解释 Size、Typeflag、Format、PAXRecords 的边界,并给出普通条目和 GNU tar --sparse 两种可靠方案。
-
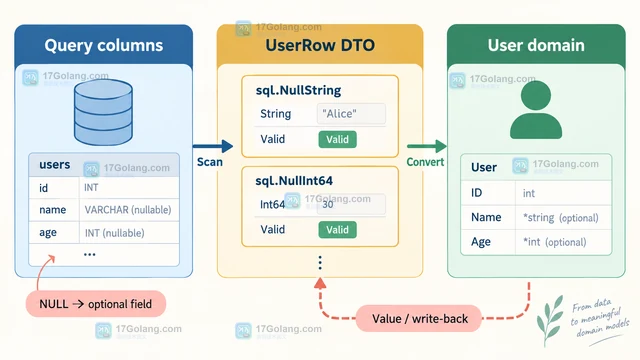
database/sql 扫描 SQL NULL 时,普通 string、int 字段无法表达空值语义。本文从扫描失败现场入手,分别使用 sql.Null* 与 Go 1.22 的 sql.Null[T],再把数据库 DTO 转换为业务结构体,给出单行、批量查询和写回数据库的稳定做法。
-
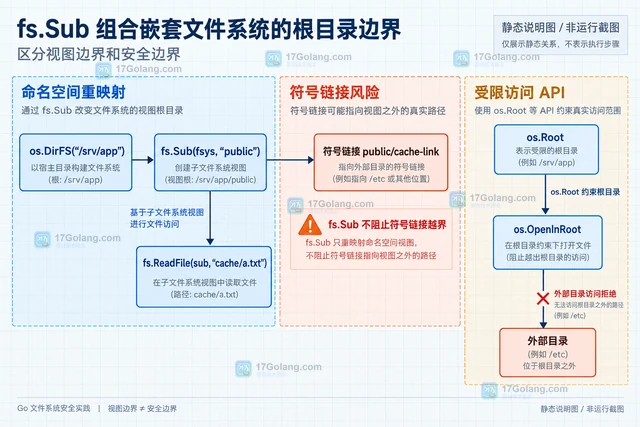
fs.Sub 可以把已有 FS 映射成以某个子目录为根的视图,嵌套调用时每一层路径都相对当前子 FS 解析。本文拆开根目录变化、符号链接风险与 os.Root 的安全边界,给出可复查的组合方式。
-
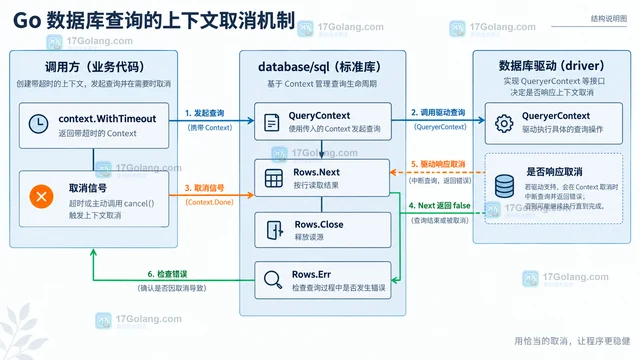
database/sql 查询过程中上下文被取消时,Rows.Next 可能只是返回 false,真正的取消或驱动错误要在 Rows.Err 中读取。本文给出稳定的读取模板,并说明 Close 与驱动取消支持的边界。
