-
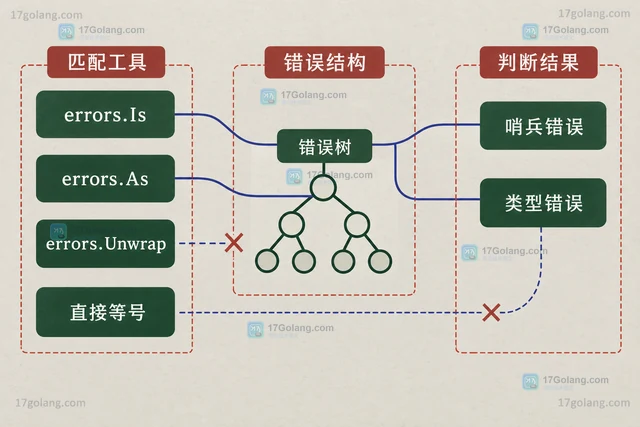
Go errors.Join 会生成实现 Unwrap() []error 的多分支错误树。errors.Is 会检查根错误并深度优先遍历每个子错误,因此可对多个原因逐个匹配;直接等号和 errors.Unwrap 不适用于该结构。
-
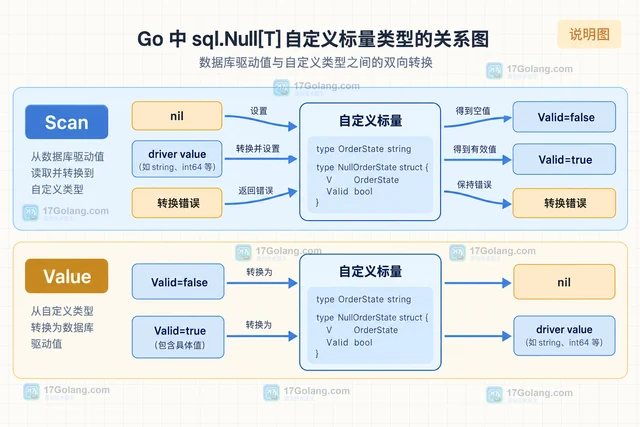
Go 1.22 引入的 sql.Null[T] 可以把 NULL 与自定义标量类型放在同一个扫描目标中。本文用 OrderState 和订单编码示例说明类型定义、Scan 调用、Valid 判断,以及 driver.Value 和旧版本兼容边界。
-
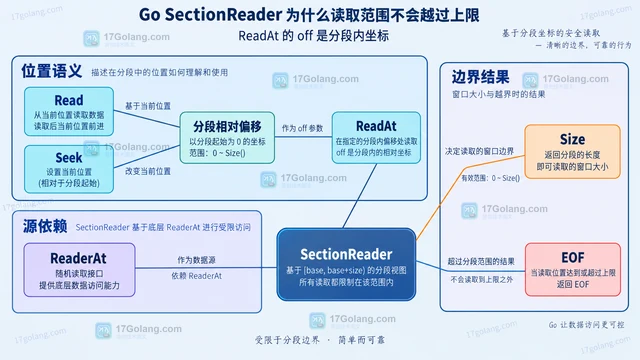
Go SectionReader 通过 base、当前偏移和 limit 建立固定读取窗口。本文解释 Read 的缓冲区裁剪、ReadAt 的相对偏移、EOF、Seek 与 Size 的边界语义。
-
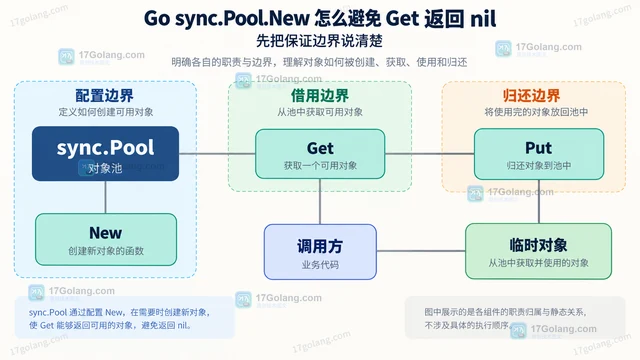
sync.Pool 在池空时只有 New 非 nil 才会创建默认对象。本文用 bytes.Buffer 说明正确初始化、typed nil 陷阱、借用归还封装、状态重置和测试边界。
-
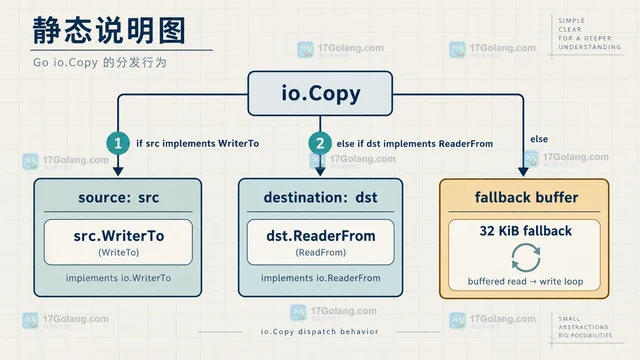
io.Copy 不一定走缓冲循环:它会优先调用 WriterTo 或 ReaderFrom。本文用调用顺序、CopyBuffer 边界和适配器示例说明自定义缓冲区为什么没有生效,以及如何正确控制这条路径。
-
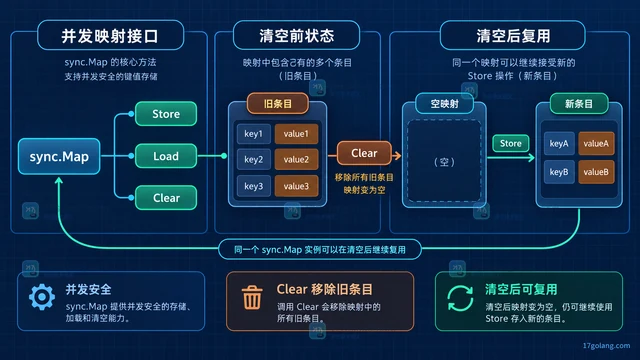
Go 1.23 起,sync.Map.Clear 可直接删除并发映射中的全部条目,清空后仍能继续 Store 和 Load。本文通过可重置缓存示例说明基本用法、并发写入边界、旧版本兼容方案,以及需要严格换代时的原子指针切换设计。
-
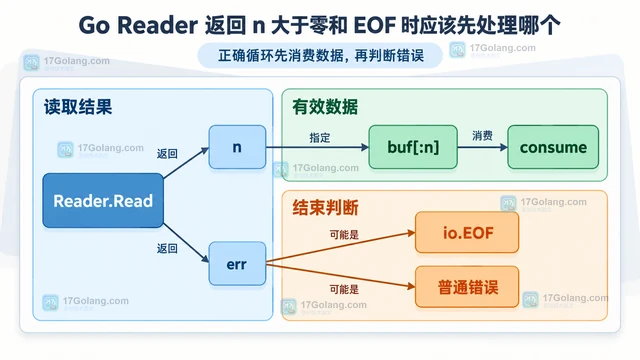
Go 的 io.Reader 可以在一次 Read 中同时返回 n > 0 和 io.EOF。正确顺序是先处理 buf[:n],再判断 err;否则会丢掉输入流最后一段有效数据。本文给出通用循环、错误优先级、0,nil 边界与标准库替代方案。
-
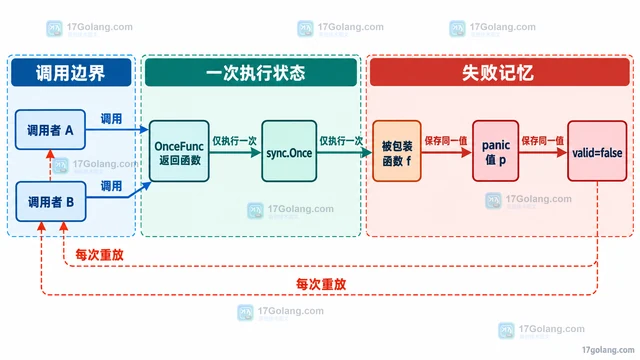
sync.OnceFunc 包装的函数如果首次执行 panic,被包装函数不会重试,但包装函数之后每次被调用都会使用同一个 panic 值再次 panic。本文给出最小示例、与 sync.Once.Do 的差异,以及线上恢复、失败缓存和重试设计建议。
-
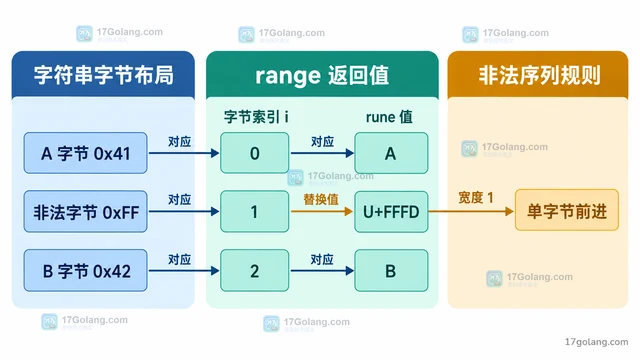
Go 对字符串执行 for range 时,如果遇到非法 UTF-8,第二个迭代值会是 U+FFFD(utf8.RuneError),下一轮只前进一个字节。本文解释字节索引、连续非法序列、合法 U+FFFD 的歧义,以及 ValidString 和 DecodeRuneInString 的正确用法。
-
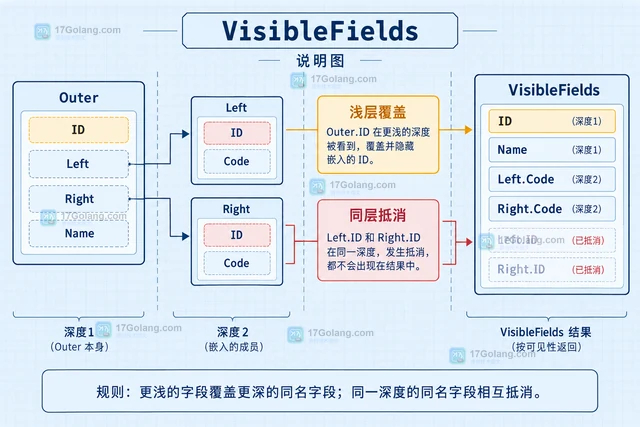
Go reflect.VisibleFields 会按 FieldByName 的可见性处理嵌入字段:浅层同名字段覆盖深层字段,同层同名字段互相抵消。本文用结构体示例说明冲突判断、StructField.Index 读取路径和 nil 嵌入指针边界。
-
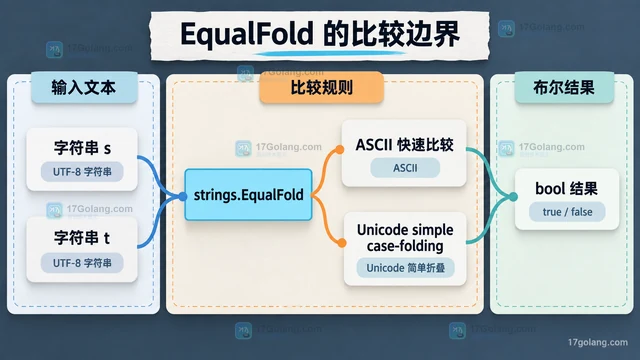
strings.EqualFold 按 Unicode 简单大小写折叠直接判断两个 UTF-8 字符串,而 strings.ToLower 是把字符单向映射成小写。本文用希腊 Sigma、德语 ß 和组合字符说明两者差异、适用场景与工程边界。
-
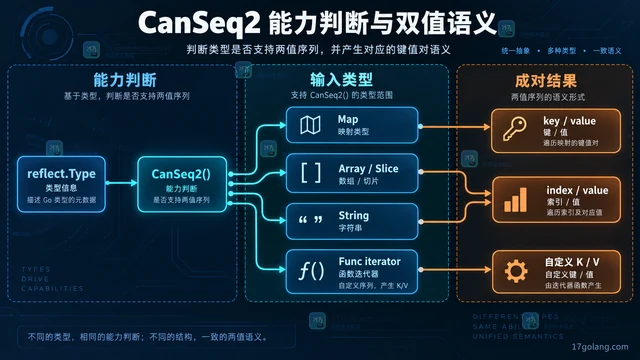
Go 1.23 为 reflect.Value 增加了 Seq2,可把 map 统一为 key/value 序列,也能遍历数组、切片、字符串和双值迭代函数。本文从一次遗漏 map 值的故障出发,说明 CanSeq2 判断、各类型双值语义和提前停止边界。
-
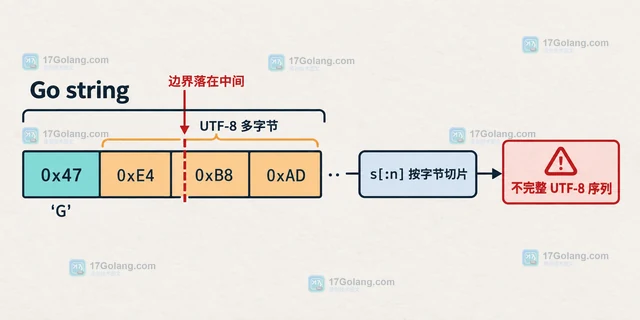
Go 的 string 按字节存储,直接切片可能把多字节 UTF-8 字符截在中间,产生非法编码。本文用可复现代码说明原因,并给出按 rune 截取与按合法字节边界截取的选择方法。
-
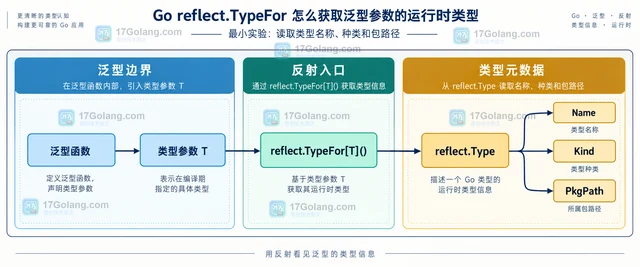
Go 1.22 新增 reflect.TypeFor[T](),可以在没有现成值时直接取得泛型参数 T 对应的 reflect.Type。本文通过最小示例、接口类型对比和泛型注册表说明 TypeFor 与 TypeOf 的区别及使用边界。
-
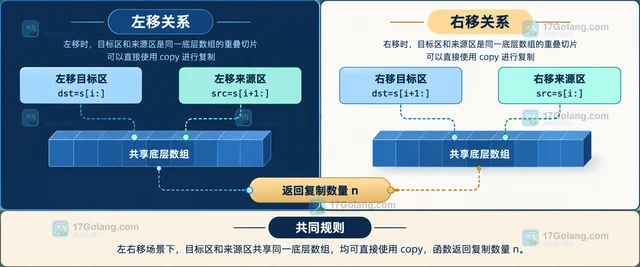
Go 内置 copy 对源和目标切片的重叠有语言规范保证,复制结果不受内存区间是否重叠影响。本文给出切片左移删除、右移插入的可靠写法,并说明返回数量、容量和并发边界。
