-
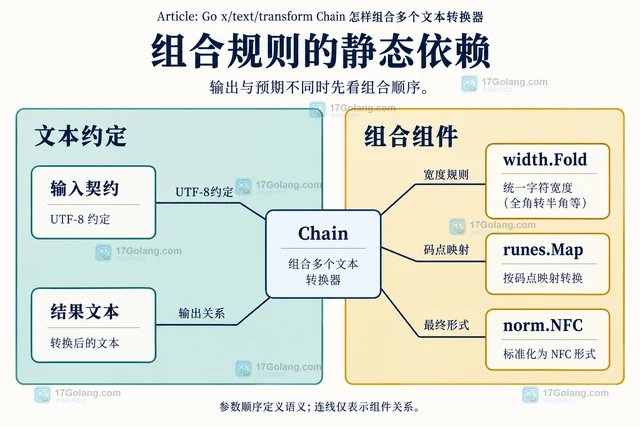
Go transform.Chain 按参数顺序组合文本转换器。本文用宽度折叠、字符映射和 NFC 解释顺序差异,给出字符串与流式写法,并说明错误、状态和资源归属。
-
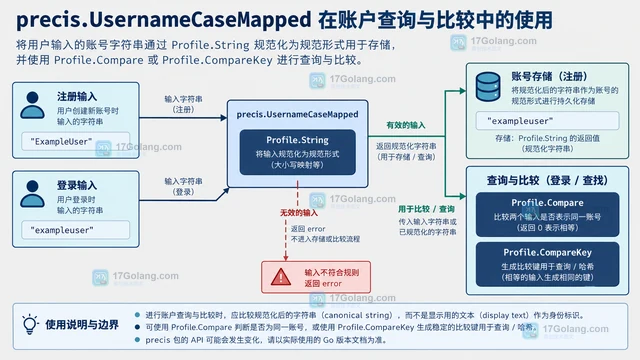
Go 的 golang.org/x/text/secure/precis 提供 UsernameCaseMapped 账户名配置文件。本文用注册和登录场景说明如何处理规范化结果、空值错误、Compare 与 CompareKey 的选择,以及显示名和身份键的边界。
-
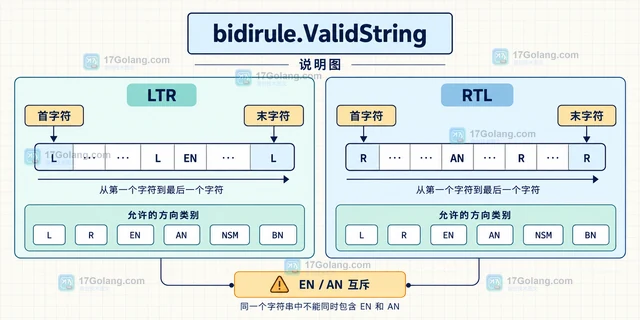
用 Go x/text/secure/bidirule.ValidString 检查字符串是否符合 RFC 5893 双向文本规则,并说明它与 Unicode 规范化、字符白名单和完整标识符校验的边界。
-
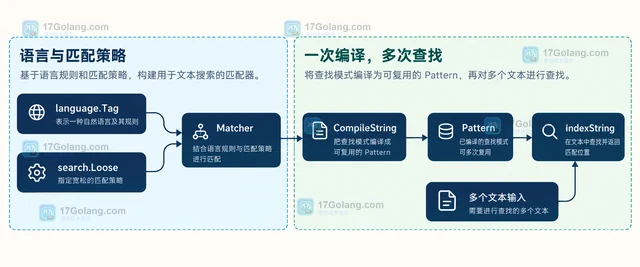
Go x/text/search 的 Pattern 适合把语言相关的查找规则编译一次后反复使用。本文从 CompileString 和 IndexString 入手,说明字节范围、未命中结果、Anchor、Backwards 以及并发复用时的边界。
-
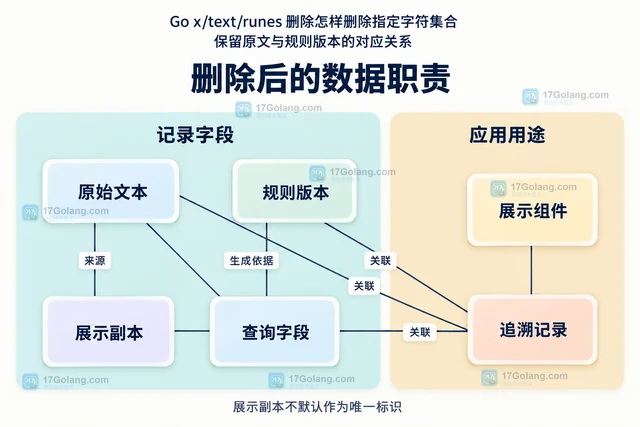
Go runes.Remove 可按字符集合删除命中的 Unicode 码点。本文用 Predicate 删除下划线和中点,说明 UTF-8 输入、字符串返回值、原文留存与展示副本的使用边界。
-
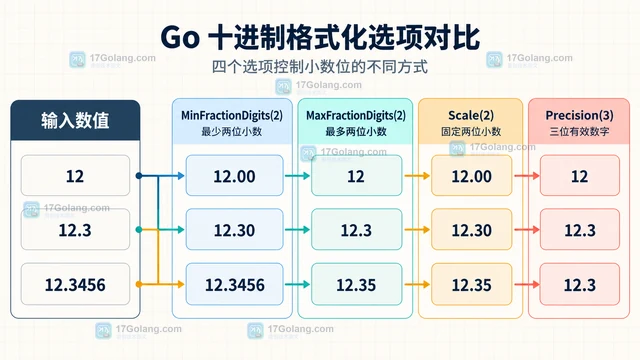
用 Go x/text/number 的 Decimal 配合 MinFractionDigits 控制最少小数位,并比较 MaxFractionDigits、Scale 与 Precision 的适用边界。
-
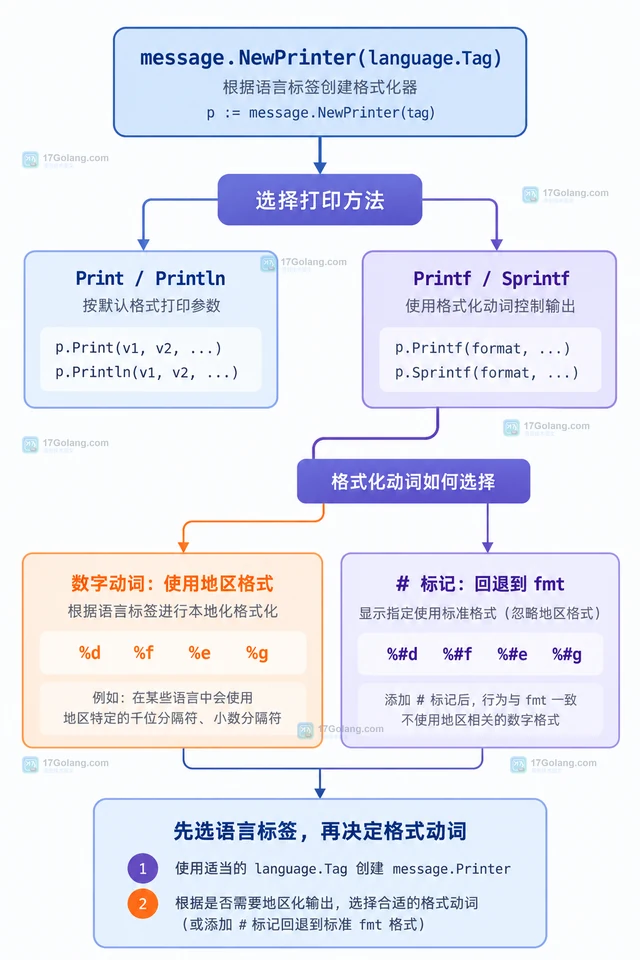
Go 使用 x/text/message Printer 配合 language.Tag 输出地区化数字。本文比较 Printer、fmt 和显式格式化的适用边界,说明 Printf、Sprintf、%d、%f、%g 以及 # 标记的选择。
-
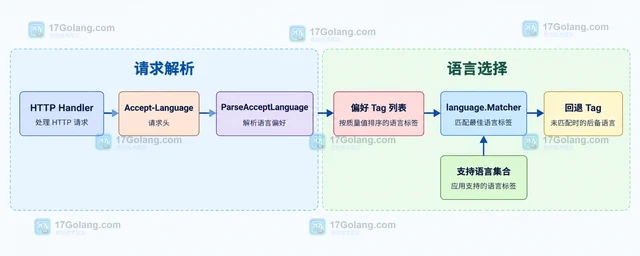
Go 服务可以用 x/text/language 的 ParseAcceptLanguage 读取 Accept-Language 头,把语言标签和 q 权重交给 Matcher 选择支持的语言。本文覆盖返回值、排序、错误和回退处理。
-
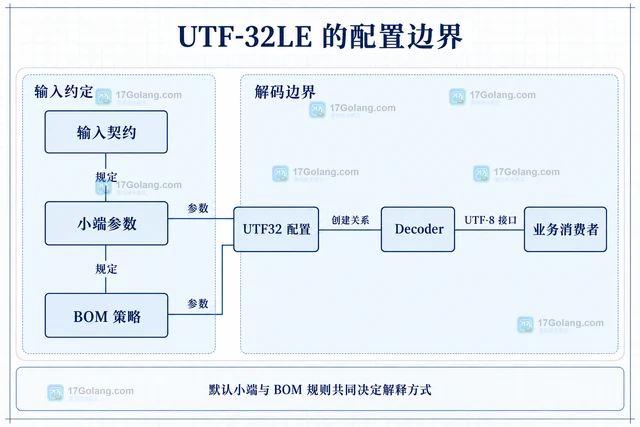
Go 用 UTF32 配置小端解码器,再通过 transform.NewReader 转成 UTF-8。本文说明 IgnoreBOM、UseBOM、ExpectBOM 的区别,以及流式处理中的资源归属和部分输出。
-
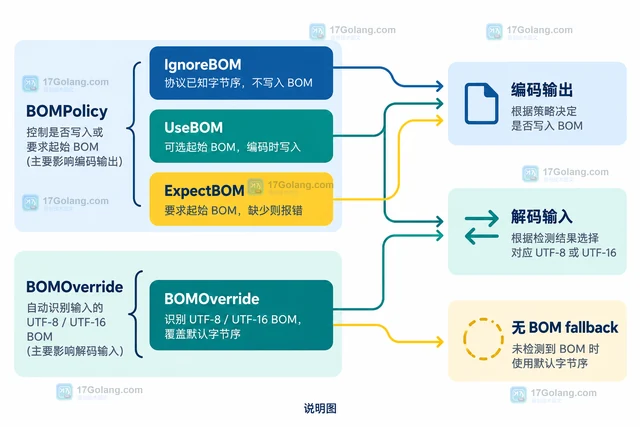
介绍 Go x/text/encoding/unicode 中 UTF16 的字节序与 BOMPolicy 配置,说明 IgnoreBOM、UseBOM、ExpectBOM 和 BOMOverride 在读写 UTF-16 时的区别与选择方法。
-
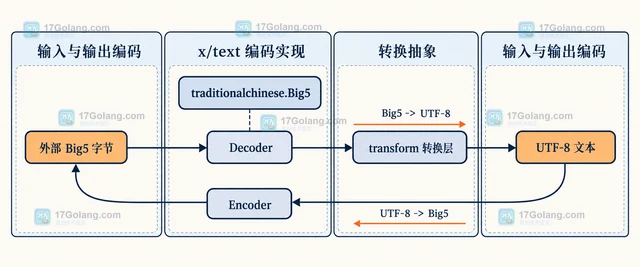
Go 使用 golang.org/x/text/encoding/simplifiedchinese 处理 GB18030 四字节字符,关键是用 GB18030 的 Decoder 与 Encoder 在 UTF-8 和旧编码字节之间转换,并区分解码替换字符与编码不可表示错误。
-
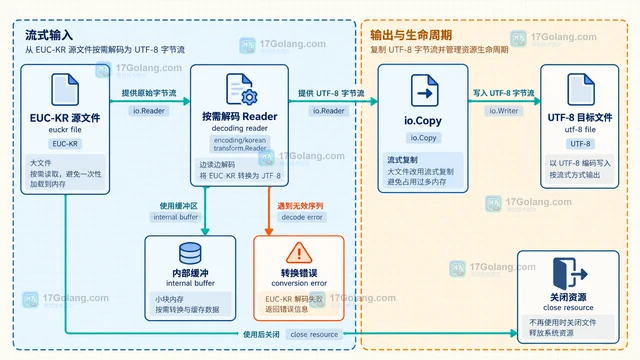
读取 EUC-KR 或 CP949 保存的旧韩文文本时,不能直接把原始字节转换成 UTF-8 字符串。本文用 golang.org/x/text/encoding/korean 的 EUCKR 解码器接入 transform.Reader,给出整文件读取、流式复制、错误处理和内存取舍。
-
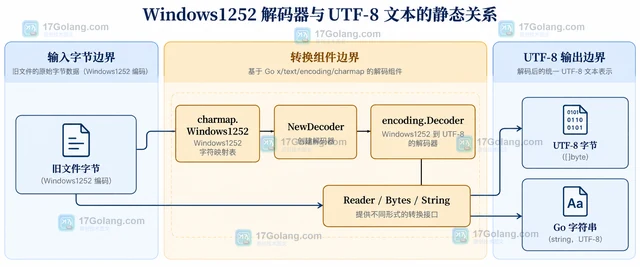
Windows-1252 旧文件不能直接当作 UTF-8 读取。本文用 golang.org/x/text/encoding/charmap 的 Decoder 说明内存转换、流式读取和写回旧编码时的字符边界。
-
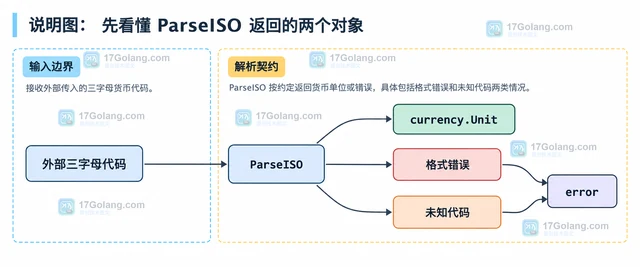
Go x/text/currency 的 ParseISO 用于解析三字母 ISO 4217 货币代码。本文说明如何处理格式或未知代码错误,并区分 Unit、Amount、Formatter 与 MustParseISO 的职责边界。
-
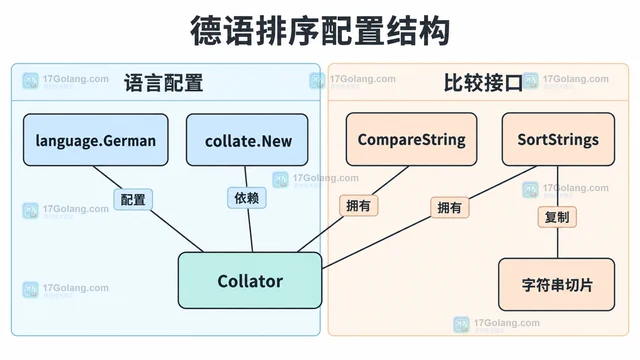
Go 用 collate.New(language.German) 创建德语文本排序器。通过完整示例说明语言标签、稳定排序与原切片保护,并解释比较等价、并发独占和配置记录的使用边界。
