
人工智能技术文章
-
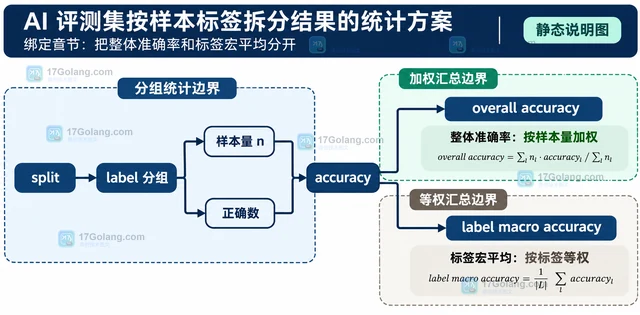 围绕 AI 评测集的样本标签拆分,给出从行式结果、分组计数到整体准确率与标签宏平均的可复算统计方案,并说明小样本、缺失标签和重复样本的处理边界。324 收藏
-
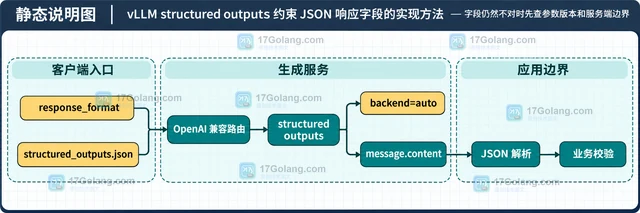 使用 vLLM OpenAI 兼容接口时,可以通过 response_format 的 json_schema 或 structured_outputs.json 声明 JSON Schema,约束模型返回字段。本文从字段契约、Python 调用、旧 guided_json 迁移和常见排查边界说明具体写法。346 收藏
-
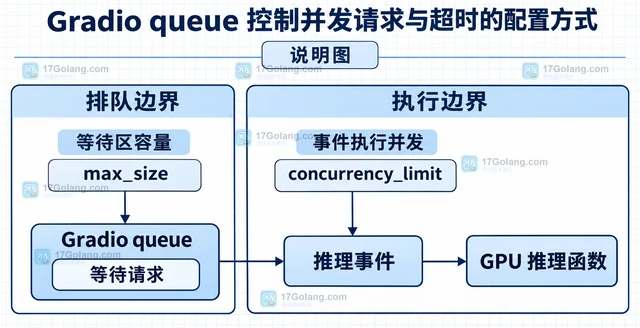 Gradio queue 的并发和超时配置要分层处理:用 max_size 控制等待区,用 concurrency_limit 限制事件执行数,用 concurrency_id 保护共享资源,真正的函数超时交给下游调用层。139 收藏
-
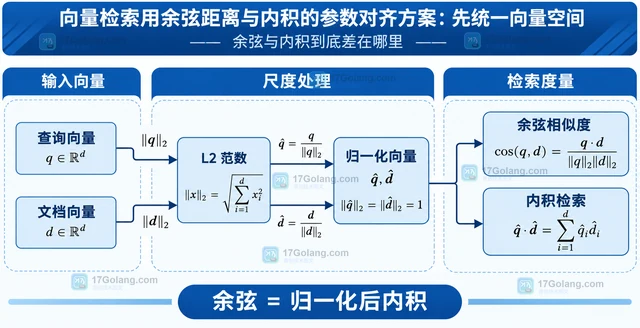 向量检索从余弦距离切换到内积时,关键不是只改 metric,而是确认查询向量和库内向量是否都做了 L2 归一化。本文用公式、Python 检查代码和迁移清单说明两种参数如何对齐,以及未归一化时为什么会改变排序。459 收藏
-
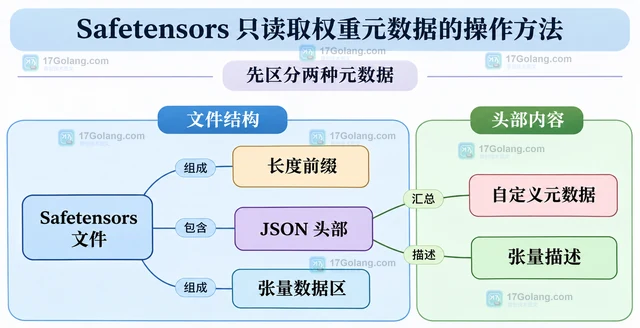 用 Python 标准库读取 Safetensors 长度前缀和 JSON 头部,获取张量名称、dtype、shape 与偏移,区分自定义元数据及分片索引,无需构造张量或初始化模型。318 收藏
-
科技周边 · 人工智能 | 12小时前 | python · dataset Hugging Face Datasets DatasetDict save_to_disk load_from_disk 离线加载
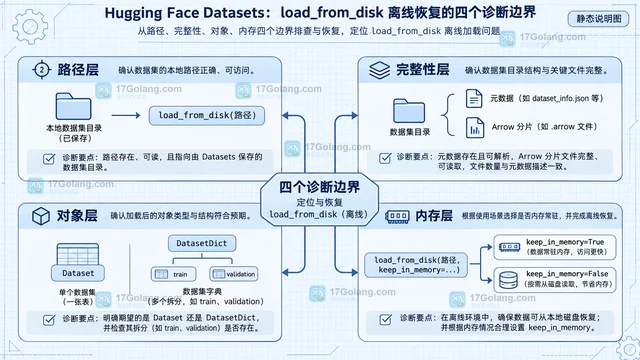 Hugging Face Datasets 的 save_to_disk 可以把 Dataset 或 DatasetDict 写入固定目录,load_from_disk 再从该目录恢复。本文从离线场景出发,说明单数据集与多 split 的保存方式、分片参数、路径边界,以及目录缺失和内存占用的排查顺序。365 收藏
-
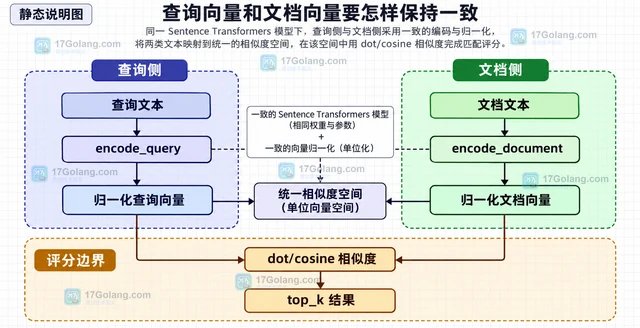 用 Sentence Transformers 的 encode 批量处理文本时,batch_size 决定分批边界,convert_to_numpy 控制输出容器,normalize_embeddings=True 让每个向量长度归一到 1。本文给出一段可迁移的 Python 写法,并说明查询、文档、维度、显存和索引兼容性的边界。323 收藏
-
科技周边 · 人工智能 | 13小时前 | 人工智能 · 深度学习 · PyTorch Accelerate mixed precision Accelerator accelerate launch
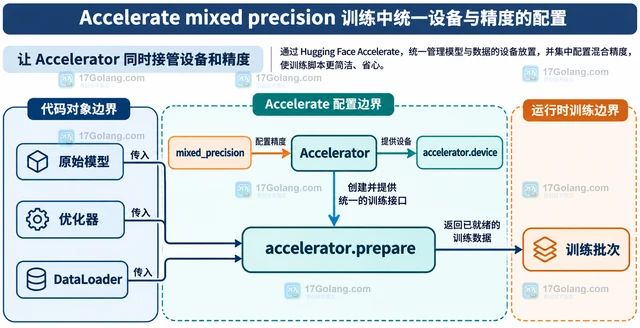 Accelerate 训练时,把设备放置、mixed precision 和启动参数集中到同一个 Accelerator 配置中,能减少手动 to 设备造成的冲突。本文用一段可迁移的 PyTorch 训练骨架说明 prepare、autocast、backward 以及常见排查方法。370 收藏
-
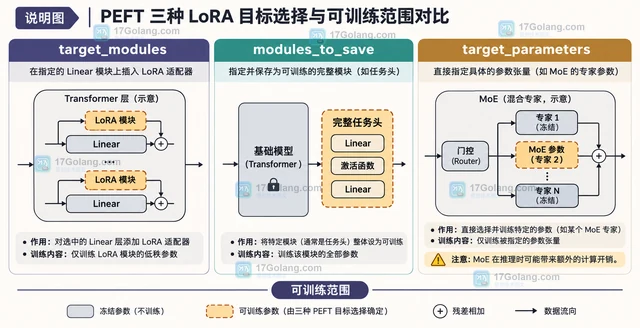 用 target_modules 选择 LoRA 插入位置,用 modules_to_save 保留需要完整训练的模块,并用 target_parameters 处理 MoE 参数级目标;最后通过参数统计清点实际训练范围。397 收藏
-
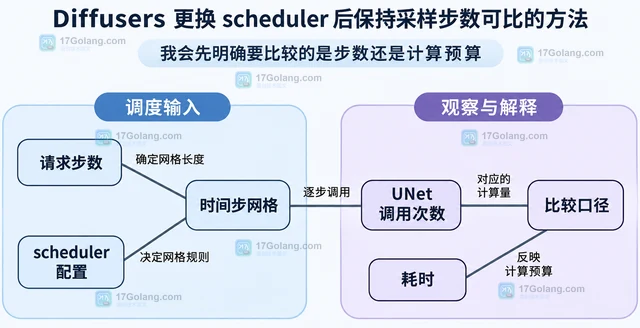 说明 Diffusers 更换 scheduler 时如何区分请求步数、时间步网格和实际网络调用,给出配置继承、独立随机生成器及 UNet 调用记录示例,建立同预算比较方法。451 收藏
-
科技周边 · 人工智能 | 13小时前 | 人工智能 · 工具调用 · Transformers JSON Schema 工具调用 chat template apply_chat_template tool_calls
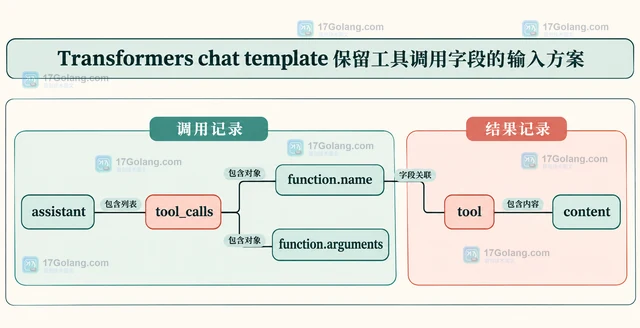 Transformers chat template 接入工具调用时,工具定义应通过 tools 传入,assistant 的 tool_calls 保留列表和嵌套字段,tool 结果写入字符串 content。本文给出完整消息结构、apply_chat_template 调用方式和字段丢失排查表。495 收藏
-
科技周边 · 人工智能 | 13小时前 | python · Hugging Face Datasets Dataset.filter with_indices input_columns load_from_cache_file num_proc
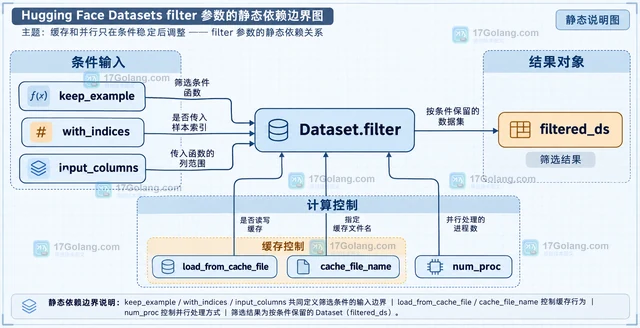 Hugging Face Datasets 的 Dataset.filter 按条件返回新的数据集对象。本文用 Python 说明条件函数、with_indices、input_columns、缓存和 num_proc 的边界,并整理行数、字段与空结果的检查方法。225 收藏
-
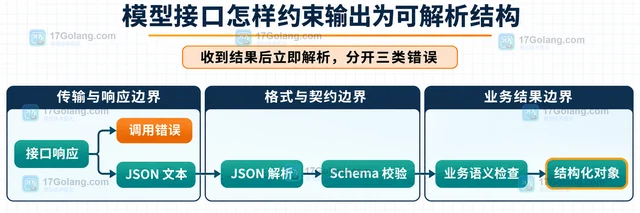 本文用一个工单摘要示例说明模型接口怎样用 JSON Schema 或 grammar 约束输出形状,并区分接口错误、JSON 解析错误、Schema 校验错误和业务语义问题。134 收藏
-
科技周边 · 人工智能 | 2天前 | 人工智能 · PyTorch DataLoader Hugging Face Datasets set_format with_format torch.Tensor
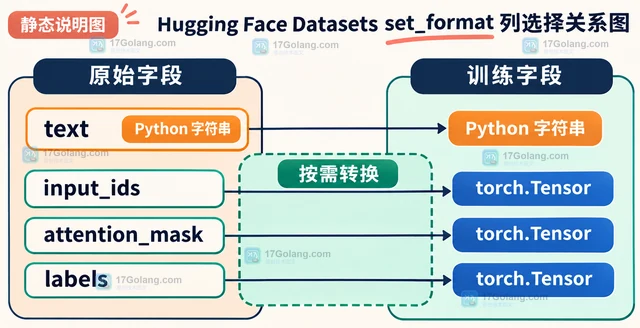 Hugging Face Datasets 同时含有原始文本、标签和模型输入时,可以用 set_format 或 with_format 只选择 input_ids、attention_mask、labels 等训练字段按需转换为 torch.Tensor。本文说明两者差异、output_all_columns 的边界、DataLoader 接入方式和 reset_format 的恢复方法。177 收藏
-
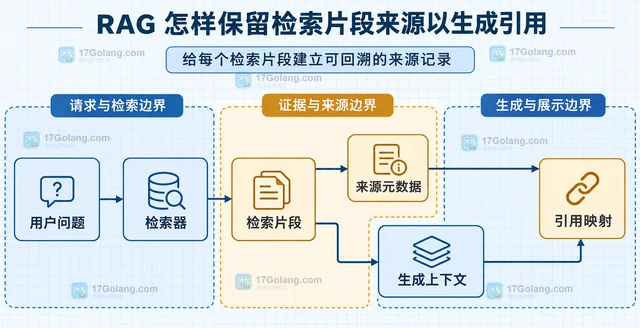 本文说明 RAG 如何在切片、检索、上下文拼接和回答渲染之间保留 chunk_id 与来源元数据,并把短引用标记映射回标题、章节和 URL。435 收藏