-
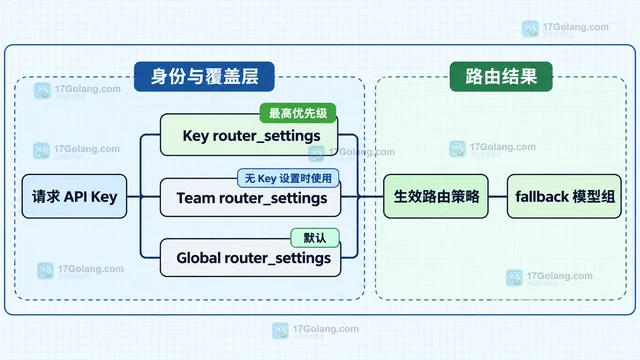
LiteLLM Proxy 支持按 Key、Team、Global 的层级解析 router_settings。本文用一个具体配置说明如何给不同 API Key 设置独立 fallback、timeout、num_retries 和故障冷却,并解释权限与配置覆盖关系。
-
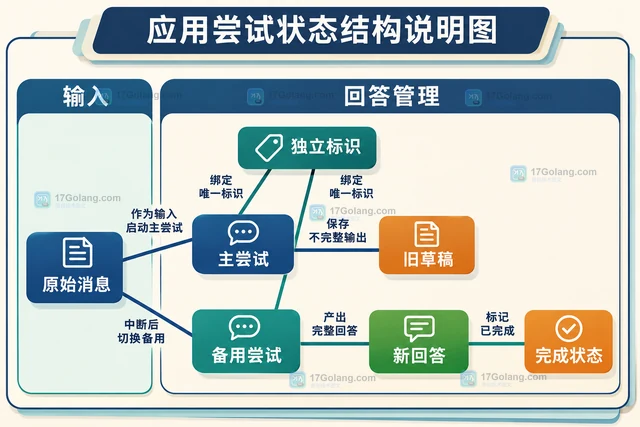
解释 LiteLLM Chat Completions 流已输出内容后的异常行为,给出应用层备用生成与 attempt 隔离写法,避免把重新生成误当成断点续传。
-
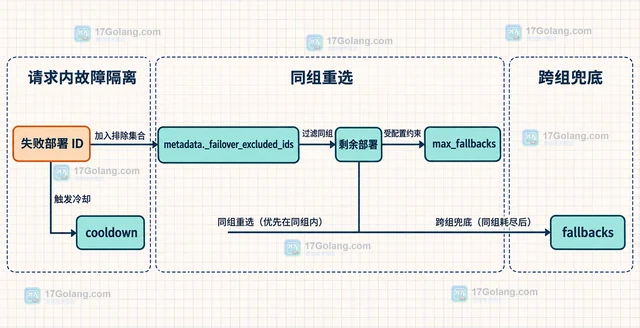
LiteLLM Router 可以把同一 model_name 下的多个区域部署组成模型组,并用 enable_weighted_failover 在异步请求失败时先切换同组健康副本。本文用权重、排除集合、max_fallbacks 和 cooldown 说明配置边界,以及它与跨模型 fallback 的区别。
-
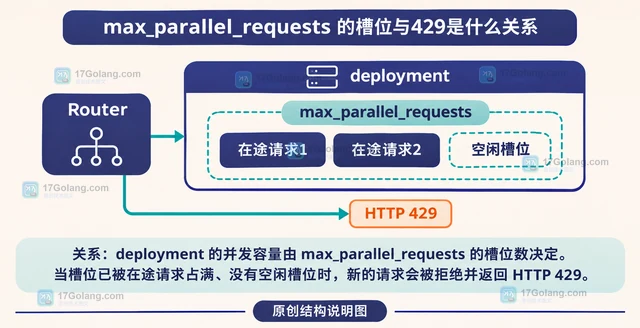
LiteLLM 的 max_parallel_requests 是部署级并发槽位上限,槽位全部占用时会在供应商调用前直接返回429。本文按配置优先级、进程边界和排查路径说明如何处理。
-
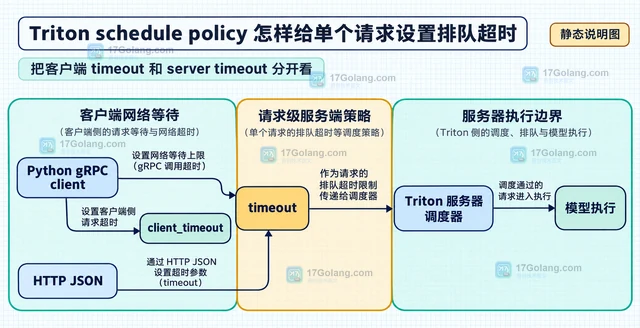
Triton 的 schedule policy 可以把 timeout 放进单个推理请求,让动态批处理队列按微秒值处理等待边界。本文说明模型队列策略、HTTP parameters.timeout、Python gRPC timeout 与 client_timeout 的区别。
-
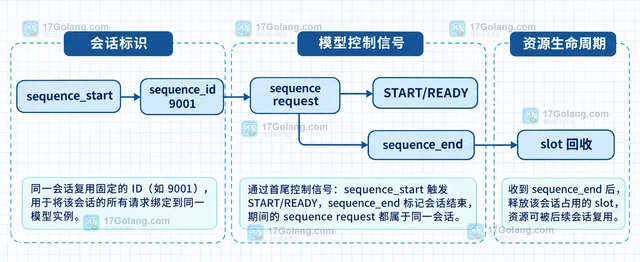
本文围绕 Triton sequence batcher 的 direct scheduling,说明 sequence_id、模型实例、batch slot 和 sequence 控制信号如何配合,让同一会话持续落到同一有状态模型实例;同时区分 direct 与 oldest 策略中 correlation ID 的职责。
-
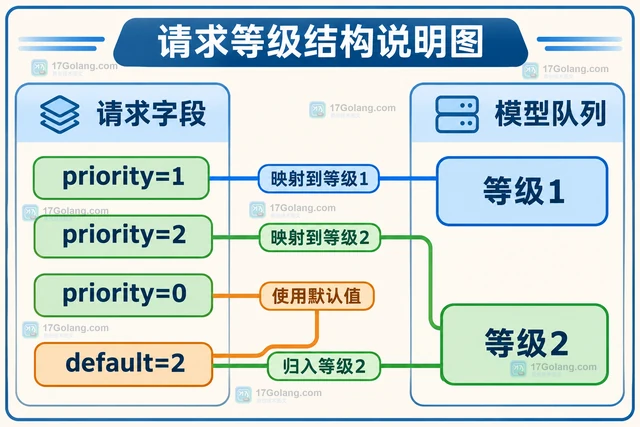
说明 Triton dynamic batcher 的优先级等级、客户端 priority 参数和各级 queue policy,并给出分组延迟、拒绝率与吞吐的对照测量方法。
-
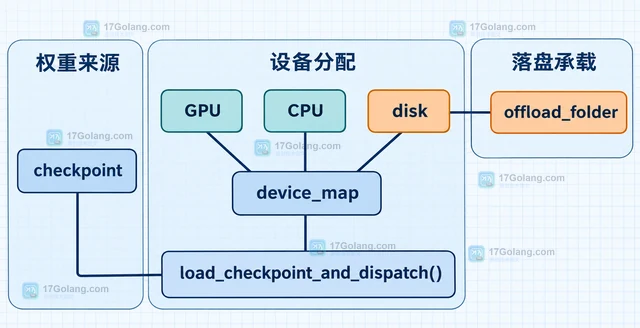
说明 Accelerate disk_offload 如何把模型权重映射到本地目录,区分已加载模型的 offload_dir 与检查点加载时的 device_map、offload_folder,并解释 execution_device、推理边界和磁盘性能影响。
-
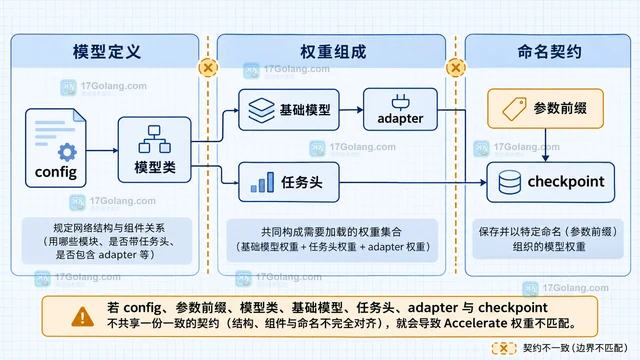
Accelerate 的 load_checkpoint_and_dispatch 遇到 missing 或 unexpected keys 时,先比较 checkpoint 与空模型的 state_dict 键集合,再排查配置、前缀、模型头和 adapter 边界,最后用 strict=True 收窄错误。
-
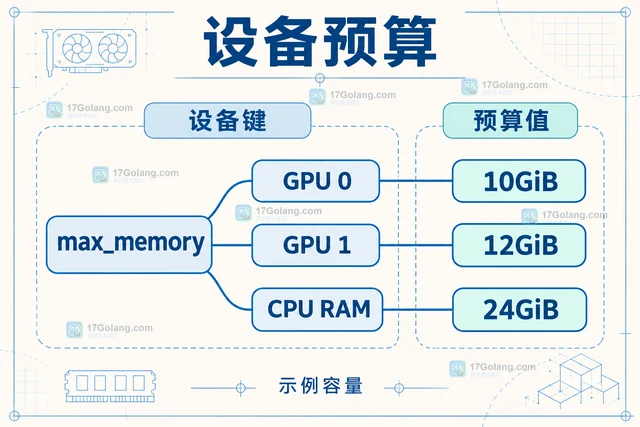
说明 Accelerate max_memory 的 GPU 编号、CPU 预算和容量单位,给出规划与加载代码,并解释权重布局与推理峰值内存的区别。
-
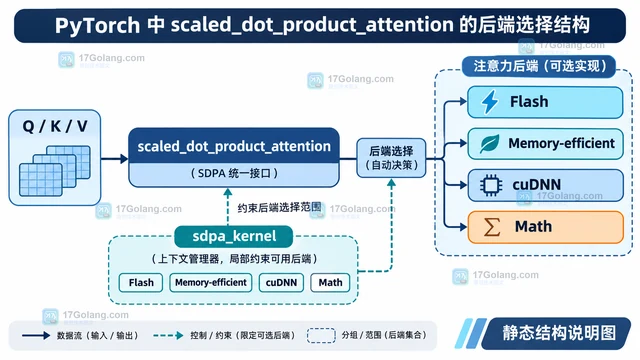
PyTorch 的 scaled_dot_product_attention 默认会根据输入和设备选择可用实现。本文用 sdpa_kernel 说明如何做局部后端约束,并从 CUDA、dtype、mask、dropout、GQA 和数值精度几个条件判断 fused kernel 为什么回退。
-
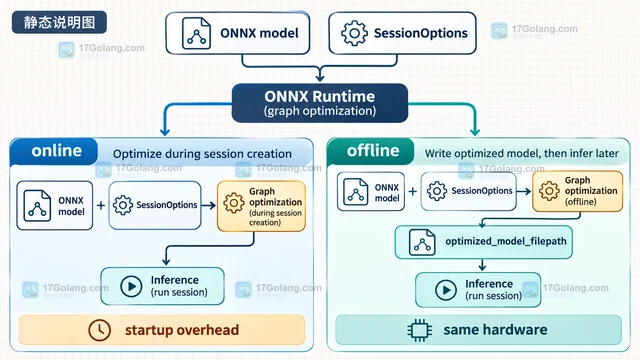
ONNX Runtime 可以在创建推理会话时对模型图做节点消除、常量折叠和算子融合。本文用 Python 说明如何显式设置 ORT_ENABLE_BASIC、ORT_ENABLE_EXTENDED 和 ORT_ENABLE_ALL,并比较在线优化与离线保存优化模型的适用边界。
-
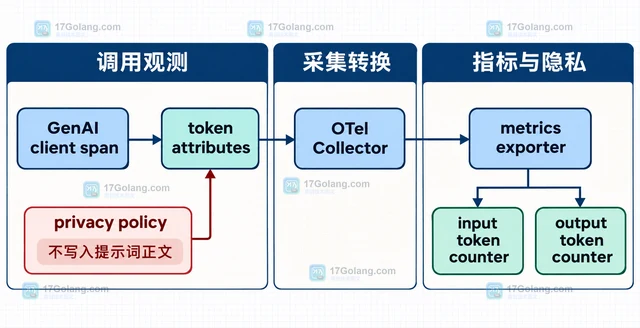
OpenTelemetry GenAI 记录 token 的关键是把模型响应里的 usage 字段映射到 gen_ai.usage.input_tokens 和 gen_ai.usage.output_tokens,再用 span 与指标边界控制隐私和重复统计。
-
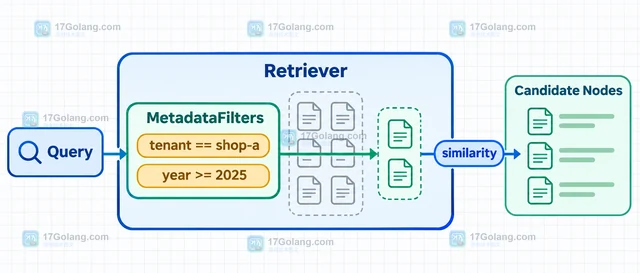
用 LlamaIndex 的 MetadataFilter 和 MetadataFilters 按租户、分类、年份等元数据筛选检索节点,并说明 AND/OR 组合、字段类型和向量库支持边界。
-
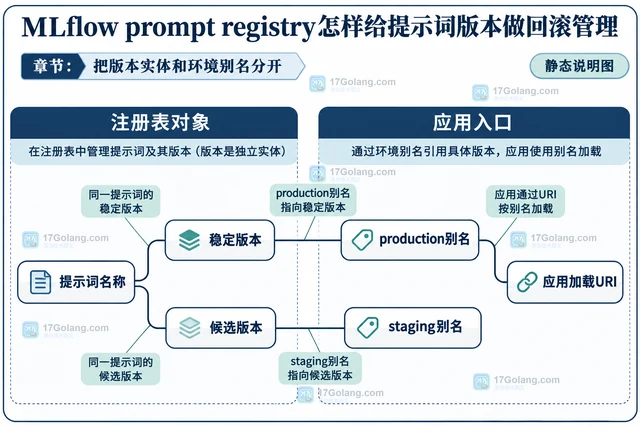
MLflow Prompt Registry如何把production别名切回稳定版本,通过load_prompt处理缓存和应用重载,并记录实际版本、模板变量与发布依赖。
