
人工智能技术文章
-
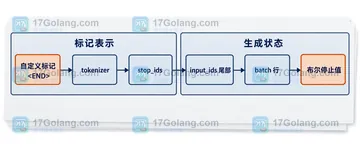 在 Transformers generate 中自定义 StoppingCriteria,用 tokenizer 生成的 token 序列匹配
等标记,并处理批量生成、提示词误匹配和兜底长度限制。 120 收藏 -
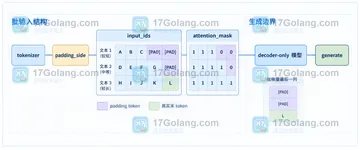 Transformers 批量生成时,padding_side 配错会让 decoder-only 模型把补齐 token 当成生成起点。本文用 input_ids、attention_mask 和 generate 的关系说明 left padding 的配置方法、pad_token 处理与回归检查边界。457 收藏
-
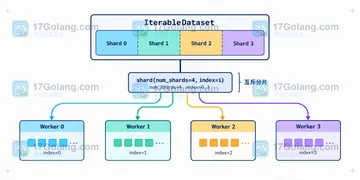 Hugging Face Datasets 开启 streaming 后会返回 IterableDataset。本文用 take、skip 和 shard 解释连续取样、并行分片的差异,以及 shuffle 顺序和性能边界。449 收藏
-
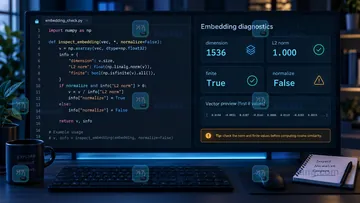 余弦相似度异常,先别急着改阈值。本文用一段最小 Python 配方检查 Embedding 的维度、L2 范数、归一化、点积和向量库距离配置,帮助定位分数漂移的真正环节。383 收藏
-
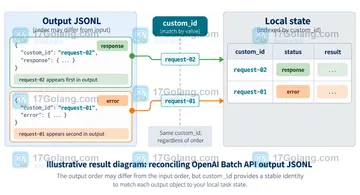 OpenAI Batch API 的输出顺序不保证与输入一致,custom_id 才是回配原始请求的稳定关联键。本文用 JSONL、成功结果、错误结果和重试设计说明如何可靠映射批量任务。105 收藏
-
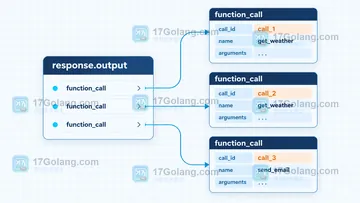 Responses API 一次返回多个 function_call 时,不要只处理第一项;保留完整 response.output,按每个 call_id 执行工具并逐条回传 function_call_output,才能避免结果串线。146 收藏
-
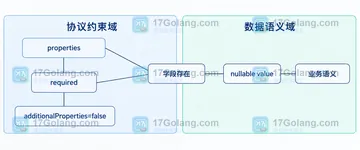 Structured Outputs 严格模式要求字段全部写入 required。本文用 required 加 null 类型表达可选语义,并说明嵌套对象、额外属性、拒答和不完整响应的兼容边界。281 收藏
-
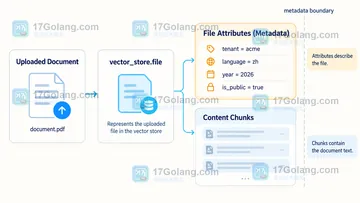 OpenAI File Search 可以在 vector store file 上写入 attributes,再用 file_search.filters 通过 eq、and、or、in 和数值范围条件缩小检索范围。本文用租户、语言和年份示例说明字段设计、复合过滤以及空结果排查。426 收藏
-
 OpenAI Responses API 使用 background=true 后,先保存 response.id,再通过 Responses 取回接口轮询 queued 或 in_progress 状态;本文说明如何读取 output_text,并处理 failed、cancelled、incomplete 等终态。314 收藏
-
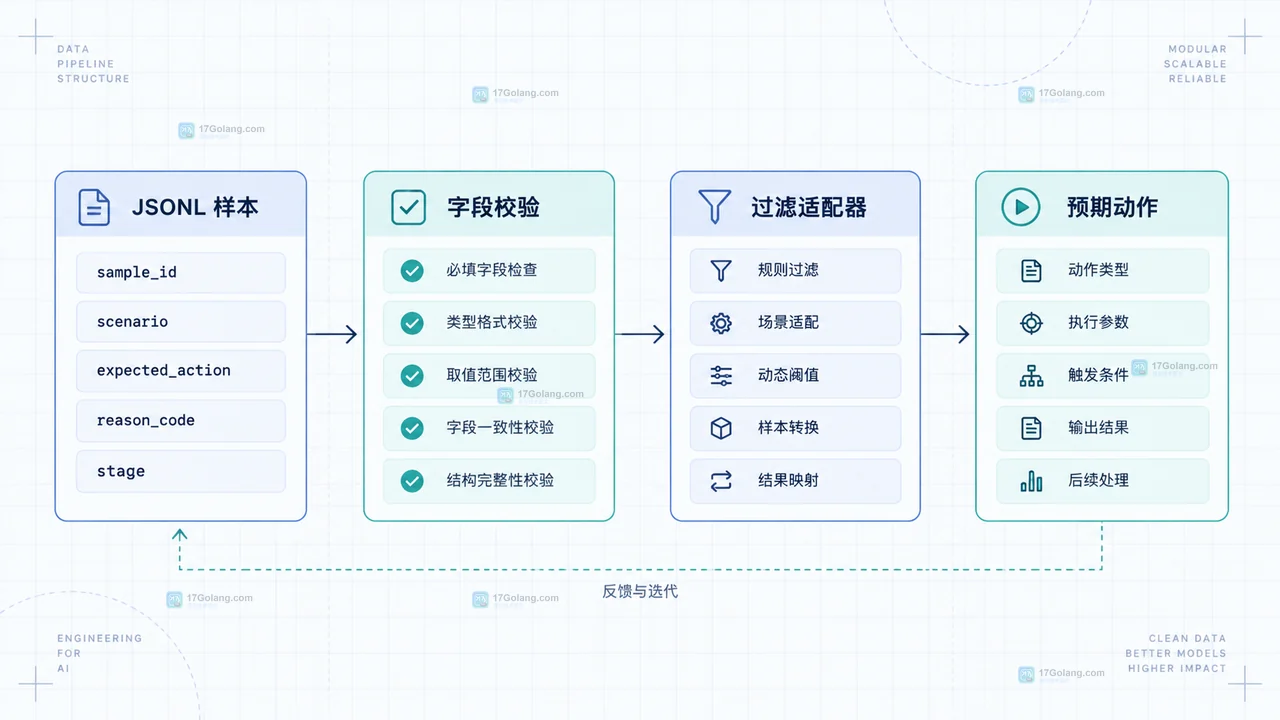 用 JSONL 固定安全过滤回归样本的字段、动作和原因码,再按阶段定位误放行、误拦截与边界样本漂移。345 收藏
-
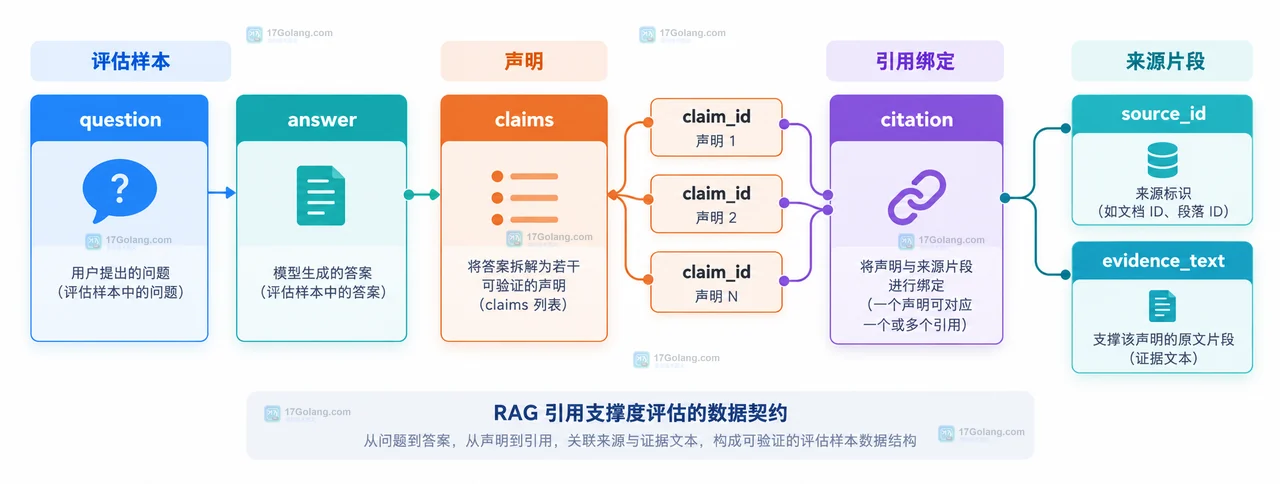 用 Hugging Face 风格的评估数据组织方式,拆解 RAG 引用支撑度的字段契约、覆盖检查、语义判定和分层排障方法。115 收藏
-
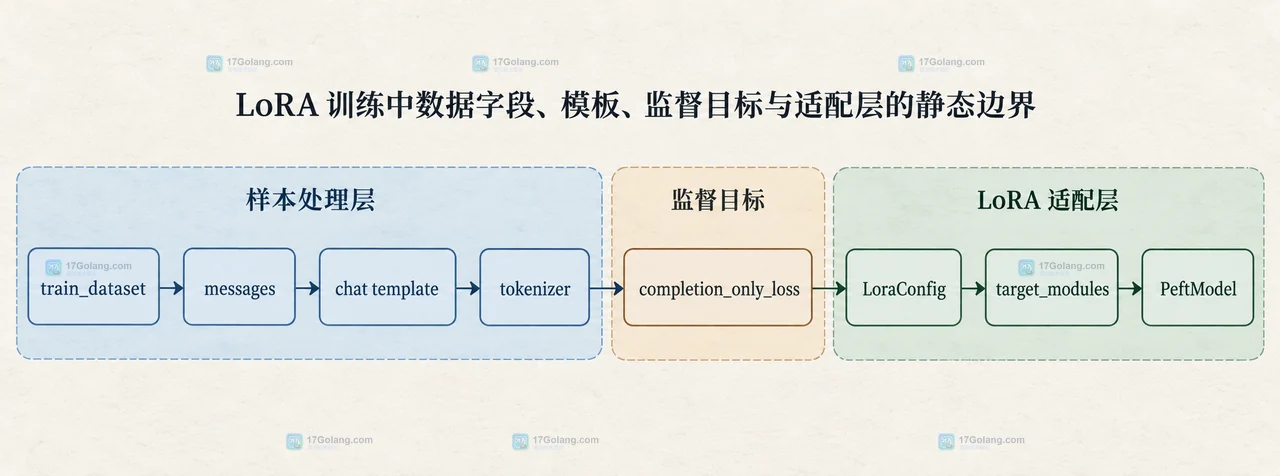 使用 Hugging Face TRL 做 LoRA 微调时,先把 instruction、input、output 等业务字段统一为 text、messages 或 prompt/completion,再分别排查聊天模板、损失目标和 target_modules 配置。171 收藏
-
科技周边 · 人工智能 | 2星期前 | 人工智能 · 性能排查 · 提示词工程 · 提示词缓存动态字段 DynamicCache KV缓存 Transformers缓存 past_key_values use_cache StaticCache
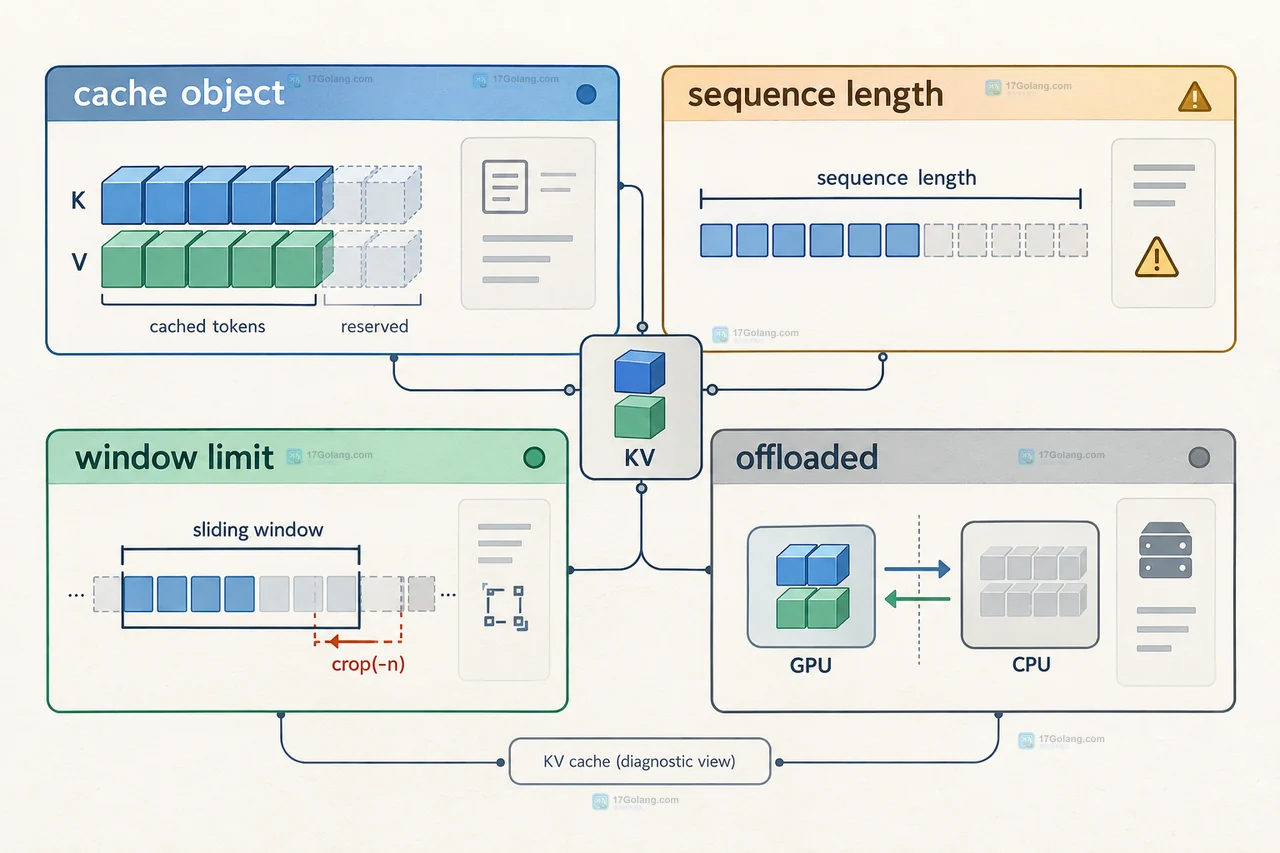 本文以 Hugging Face Transformers 的 DynamicCache 为例,说明提示词缓存动态字段的配置边界,覆盖 use_cache、past_key_values、迭代对话、窗口上限、回滚、显存排查以及切换 StaticCache 的判断方法。397 收藏
-
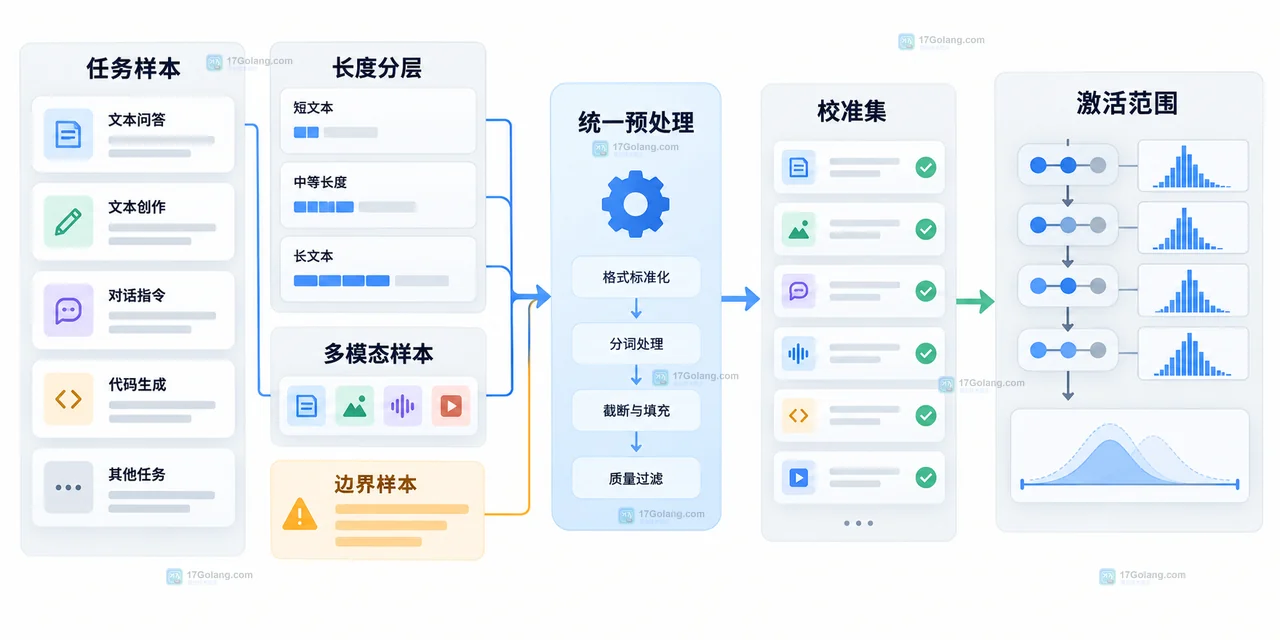 量化校准数据不是随便凑一批样本。本文对比不同量化路径的校准要求,给出样本配置清单、输入契约检查法和精度回归排查步骤。276 收藏
-
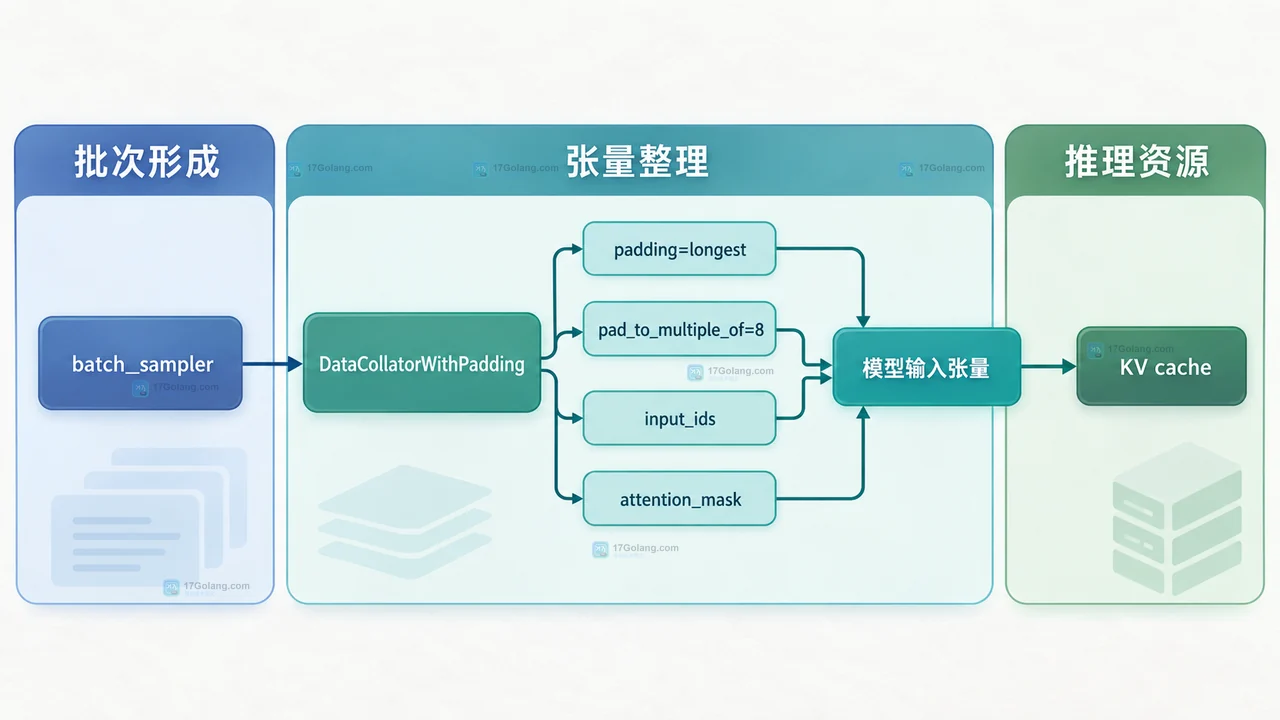 批量推理输入长度差异大时,固定 batch 会产生大量 padding。本文用 Hugging Face Transformers、PyTorch DataLoader 和 token 长度分桶说明配置方式,并给出显存、吞吐和结果顺序的排查清单。221 收藏