
人工智能技术文章
-
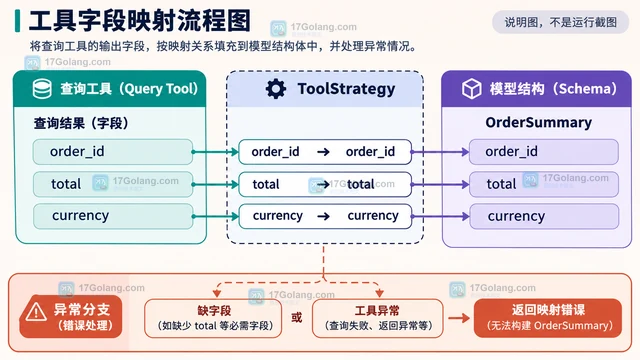 LangChain 的工具返回值不是最终数据模型。本文用 Pydantic 与 ToolStrategy 拆开工具消息、结构化响应和错误边界,说明怎样把查询结果稳定地交给业务代码。135 收藏
-
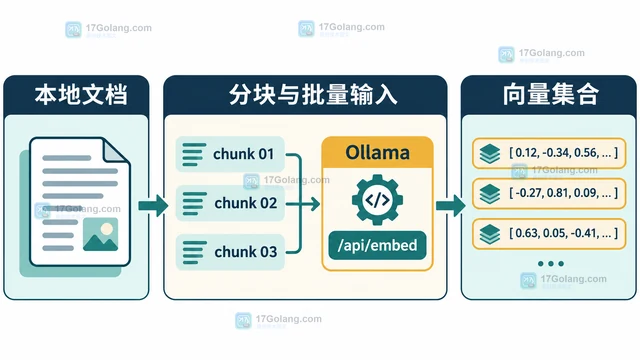 用 Ollama 的 /api/embed 把本地文档切成片段并批量转换为向量,保留文本、模型和元数据映射,再用同一模型生成查询向量完成语义检索。230 收藏
-
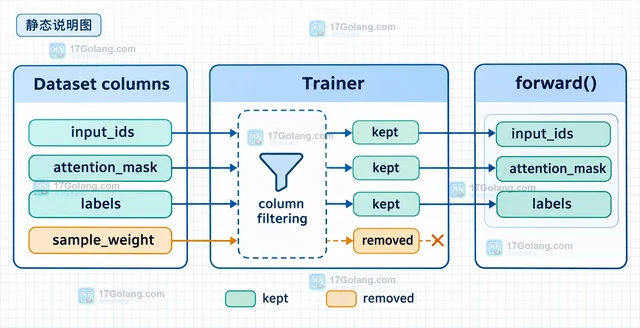 Transformers Trainer 默认会移除模型 forward 未声明的数据集列。本文用 sample_weight 说明如何配置 remove_unused_columns 和 forward 参数,让自定义字段继续传入模型。344 收藏
-
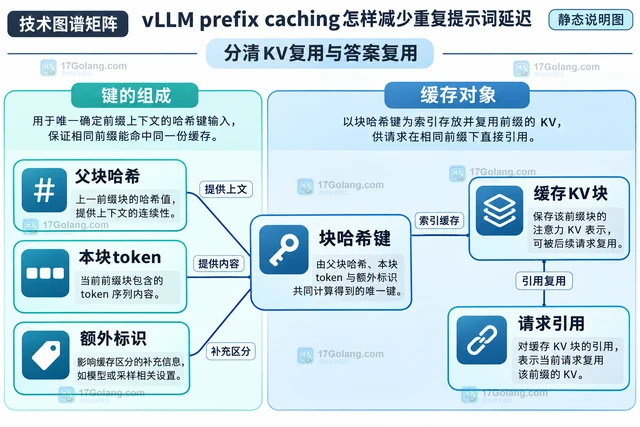 vLLM prefix caching怎样复用共同前缀KV缓存:显式启用APC、稳定提示词结构,用冷暖对照观察首字延迟,并区分预填充优化与答案缓存。312 收藏
-
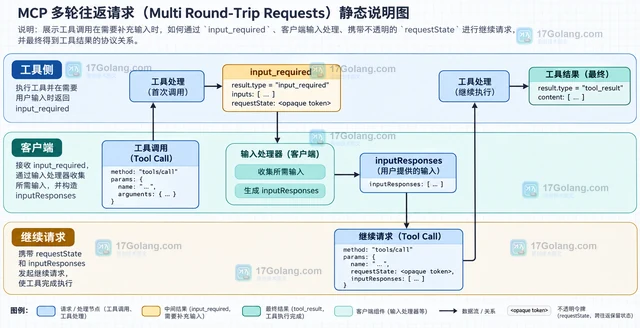 MCP 工具调用返回 input_required 时,如何保存不透明 requestState,处理 sampling、elicitation 或 roots 输入,并携带 inputResponses 重试原始调用。458 收藏
-
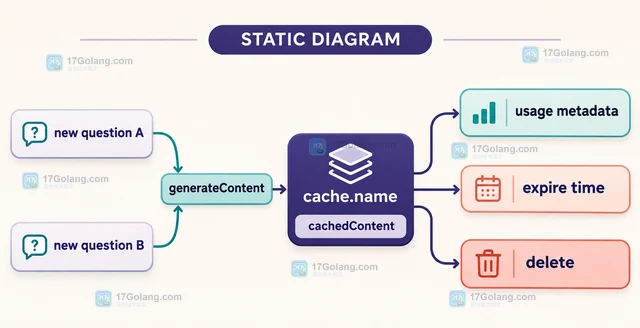 Gemini API 复用长文档的关键是创建显式 context cache,后续请求只发送新问题并引用 cachedContent。本文用 Python 示例说明 Files API、TTL、模型绑定、usage metadata 与文档版本切换。394 收藏
-
科技周边 · 人工智能 | 3天前 | python · 人工智能 · gemini · 结构化输出 · Pydantic JSON Schema Gemini API google-genai structured output
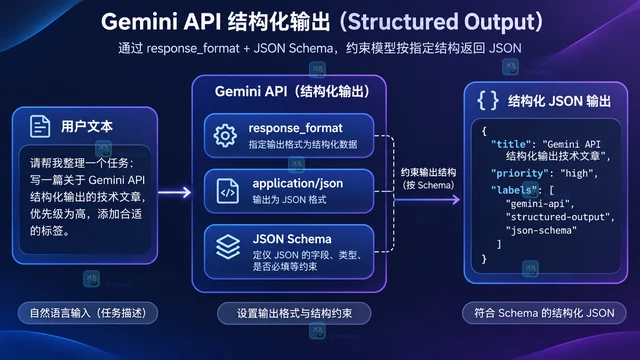 Gemini API structured output 可以让模型按 JSON Schema 返回稳定的对象结构。本文用一个工单字段抽取小例子说明 response_format、application/json、object、enum、array 和本地解析之间的关系,并区分结构约束与业务校验。136 收藏
-
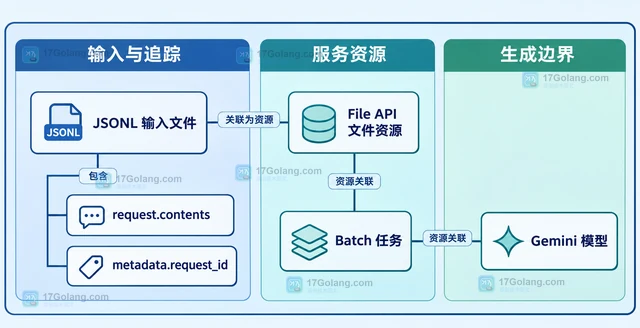 Gemini API Batch 适合输入已准备好、结果不要求实时返回的大量生成任务。本文用 Python 和 JSONL 说明文件上传、批任务创建、状态轮询、逐行结果处理、幂等边界与批次拆分策略。486 收藏
-
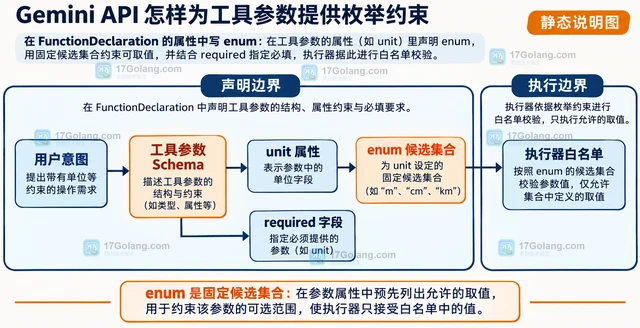 Gemini API 的工具参数如果只有有限几个合法值,可以在 function declaration 的属性 Schema 中使用 enum 声明候选集合。本文从参数进入工具声明、模型返回调用到应用侧执行,说明 enum、required、description 和业务校验各自负责什么。322 收藏
-
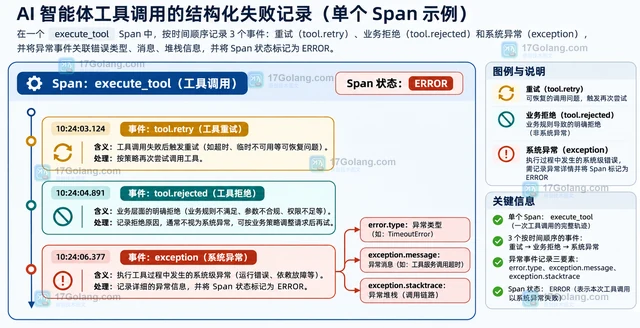 用 OpenTelemetry 把 AI 代理、模型、工具和下游依赖串成一棵 Trace 树,并用结构化事件记录重试、业务拒绝和异常原因。250 收藏
-
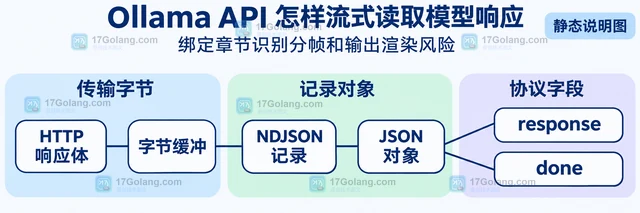 通过 Python 逐行解析 Ollama NDJSON 流,处理文本增量、完成标记、流内错误和连接关闭,并区分中断草稿与完整响应。167 收藏
-
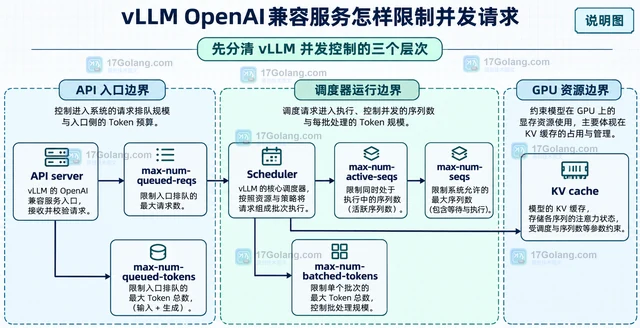 vLLM OpenAI 兼容服务的并发限制要分三层:入口请求队列、运行态序列数和 token 预算。本文给出启动参数组合、503 边界与客户端退避思路。392 收藏
-
科技周边 · 人工智能 | 4天前 | 人工智能 · Transformers bitsandbytes 4-bit量化 BitsAndBytesConfig bnb_4bit_compute_dtype
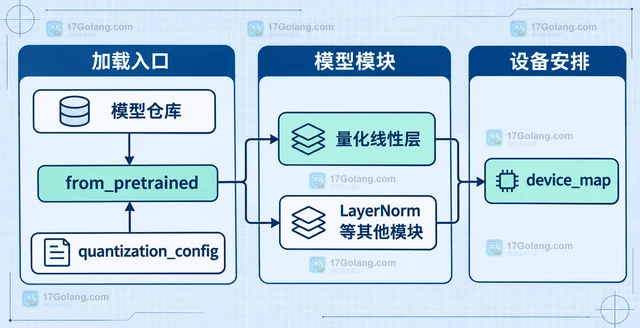 Transformers 的 4-bit 配置容易把量化类型、计算类型和其它模块 dtype 混在一起。本文用 BitsAndBytesConfig 拆开三者边界,给出 NF4、bfloat16、dtype=auto 和 device_map 的实用配置方法。347 收藏
-
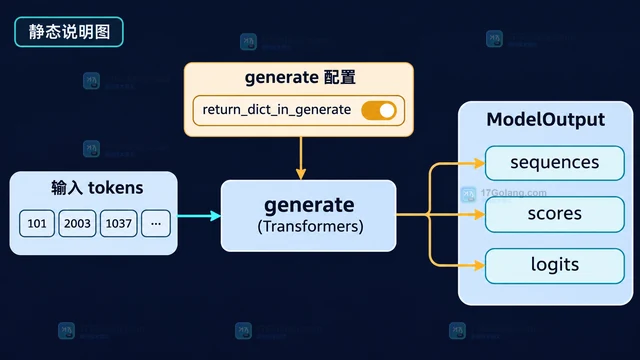 Transformers generate 的 output_scores 与 output_logits 都保存生成步分数,但前者是经过生成处理的 scores,后者更接近未处理的模型 logits。本文说明返回开关、数据结构和实际选择方法。393 收藏
-
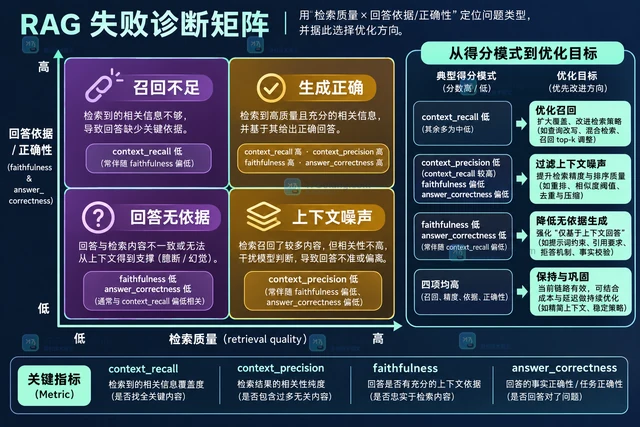 RAG 应用排障不能只盯着最终答案。本文用 context_recall、context_precision、faithfulness 和 answer_correctness 拆分检索与生成问题,并给出一套可接入回归集的评估方法。476 收藏